引言
训练一个高性能 LLM(大语言模型)究竟需要什么?
已发表的研究论文让这一切看起来简单明了:精心选择的架构、仔细筛选的数据集,再加上足够的算力。结果总是经过打磨的,消融实验(ablation)整洁有序。每一个决策事后看来都理所当然。但那些论文只呈现了最终奏效的部分,并带着些许”事后诸葛亮”的滤镜——它们不会记录凌晨两点调试 dataloader(数据加载器)的煎熬、loss(损失值)的突然飙升,也不会记录那个悄悄破坏训练过程的隐蔽 tensor parallelism(张量并行)bug(见后文!)。现实远比论文混乱,更具迭代性,充满了那些永远不会出现在最终论文里的决策。
跟我们一起走进 SmolLM3 训练过程的幕后——这是一个拥有 30 亿参数的多语言推理模型,在 11 万亿 token(词元)上完成训练。这不是一篇普通的指南,而是一张错综复杂的决策之网、探索之路与死胡同的全景拆解,最终引领我们深刻理解构建世界级语言模型究竟需要什么。
这也是我们长篇模型训练系列的收官之作。我们已经历过大规模数据集构建(FineWeb)、驱动数千块 GPU 协同运作(The Ultra-Scale Playbook),以及在训练每个阶段筛选最优评估方案(The LLM Evaluation Guidebook)。现在,我们将把这一切融为一体,构建一个强大的 AI 模型。我们将带你走完整段旅程——不只是那套最终奏效的配方,还有塑造每一个决策的失败、基础设施崩溃与调试过程。你将看到:前景光明的小规模消融实验有时无法在大规模训练中复现;为什么我们在训练 1 万亿 token 后重新启动了训练;我们如何在多语言、数学和代码等相互竞争的目标之间寻求平衡,同时保持强劲的英语能力;以及最终如何对一个混合推理模型进行 post-training(后训练)。
我们努力避免流水账式地罗列所有操作,转而以有组织的故事形式呈现这段探索历程。把这份指南当成一本写给所有人的手册——适用于那些想要从”我们有优质数据集和 GPU”走到”我们构建了一个真正强大的模型”的人。我们希望如此开放的分享能够帮助缩小研究与生产之间的鸿沟,让你的下一次训练稍微少一点混乱。
如何阅读本指南
你不需要从头到尾读完整份指南,事实上它已经太长,无法在一次坐下来时实际读完。它由几个相对独立的部分组成,任何一部分都可以单独阅读或跳过:
- 训练指南针(Training compass): 关于是否应该自行预训练模型的高层次讨论。我们将引导你思考在烧光所有风投资金之前应该问自己的基本问题,以及如何系统地梳理决策过程。这是一个宏观章节;如果你想直接进入技术内容,完全没问题。
- 预训练(Pretraining): 训练指南针之后的章节涵盖了构建自己预训练方案所需了解的一切:如何运行消融实验、选择评估指标、混合数据来源、做出架构选择、调整超参数(hyperparameter),以及最终如何熬过训练马拉松。如果你不打算从头预训练,但对 continued pretraining(持续预训练,又称 mid-training,中间训练)感兴趣,本章同样适用。
- 后训练(Post-training): 在本部分,你将学到充分发挥预训练模型潜力所需的全部技巧。我们将覆盖完整的后训练字母表,从 SFT(监督微调)、DPO(直接偏好优化)、GRPO,到模型合并的黑魔法与炼金术。让这些算法真正奏效的知识往往是通过痛苦的教训换来的,我们将在这里分享我们的经验,希望能帮你少走一些弯路。
- 基础设施(Infrastructure): 如果说预训练是蛋糕,后训练是糖霜和樱桃,那么基础设施就是工业级烤箱。没有它,一切都无从发生;如果它坏了,你轻松愉快的周日烘焙就会变成一场火灾隐患。关于如何理解、分析和调试 GPU 集群的知识散落在互联网各处——各种库、文档和论坛里。本章将系统梳理 GPU 布局、CPU/GPU/节点/存储之间的通信模式,以及如何识别并突破性能瓶颈。
那么,我们从哪里开始呢?选一个你最感兴趣的章节,出发吧!
训练指南针:为什么 → 训练什么 → 怎么训练
机器学习领域与优化有着近乎偏执的关系。我们痴迷于 loss curve(损失曲线)、模型架构和吞吐量;毕竟,机器学习从根本上就是在优化模型的损失函数。然而,在深入这些技术细节之前,有一个更根本的问题往往无人追问:我们真的需要训练这个模型吗?
如下方热力图所示,开源 AI 生态系统几乎每天都在发布世界级模型:Qwen、Gemma、DeepSeek、Kimi、Llama 🪦、OLMo,这份名单每个月都在变长。这些不只是研究原型或玩具示例:它们是生产级模型,覆盖了从多语言理解到代码生成和推理的惊人广度的用例。大多数还附带宽松的许可证和活跃的社区,随时准备帮助你使用它们。
这就引出了一个令人不安的观点:也许 你 根本不需要训练自己的模型。
以这种方式开启一篇”LLM 训练指南”似乎有些奇怪。但许多失败的训练项目并非因为超参数不当或代码有 bug 而失败;它们失败是因为有人决定训练一个根本不需要的模型。所以,在你承诺开始训练并深入研究 如何 执行之前,你需要回答两个问题:为什么 要训练这个模型?应该 训练什么模型?没有清晰的答案,你可能会浪费数月的算力和工程时间,最终构建出世界上已经有的东西,或者更糟——构建出没有人需要的东西。
让我们从 为什么 开始,因为不理解目的,你就无法对后续的任何事情做出连贯的决策。
本章与本指南其余部分有所不同:它更少涉及实验和技术细节, 更多关于战略规划。我们将引导你决定是否需要从头开始训练,以及应该构建什么模型。 如果你已经深思熟虑过”为什么”和”训练什么”, 可以直接跳到 “每个大模型都从一个小型消融实验开始” 进行技术深潜。 但如果你还不确定,在这里多花一些时间,很可能会为你节省大量后续的精力。
为什么:那个没人想回答的问题
让我们直言不讳地说说实际发生的情况。某人(如果幸运的话)获得了一个 GPU 集群的访问权限——也许通过研究经费,也许通过公司的闲置算力——思维过程大致是这样的:“我们有 100 块 H100,用三个月。我们来训练一个模型吧!“模型大小被随意确定,数据集由手头现有的东西拼凑而成。训练开始了。六个月后,在烧掉了算力预算和团队士气之后,最终的模型无人问津——因为从来没有人问过 为什么。
以下是一些不应该训练模型的理由:
“我们训练了自己的模型”这种诱惑是强大的,但在投入大量时间和资源之前,问清楚这个问题是有意义的:我们为什么需要训练这个模型?
以下流程图引导了在启动大型预训练项目之前应该经历的思考过程。从技术角度来看,你应该首先找出是否存在一个现有模型,可以通过提示(prompt)或微调(fine-tune)来完成任务。
基本上有三个常见领域,自定义预训练是合理的:你想做前沿研究、你的生产用例有非常特定的需求,或者你想填补开放模型生态系统中的空白。让我们快速看看每一个。
研究:你想理解什么?
LLM 领域有大量研究工作可以做。LLM 研究项目的共同点是,你通常从一个明确定义的问题开始:
- 能否将这个新优化器的训练扩展到 100 亿+参数的模型?(参见 “Muon is Scalable for LLM Training.”)
- 仅凭强化学习(reinforcement learning),不经过 SFT(监督微调),能否产生推理能力?(参见 “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.”)
- 能否在纯合成教科书数据上训练出优秀的小模型?(参见 “Textbooks Are All You Need.”)
- 能否通过仅在开放许可数据上训练来实现有竞争力的性能?(参见 “The Common Pile v0.1: An 8TB Dataset of Public Domain and Openly Licensed Text.”)
让假设尽可能具体,并思考必要的实验规模,能够增加成功的概率。
生产:为什么不能使用现有模型?
公司无法将现成模型用于其用例,主要有三个原因。其中两个是技术原因,另一个是治理原因。
训练自己模型的第一个原因是 领域专一性(domain specificity):当你的数据或任务涉及高度专业化的词汇或结构,而现有模型无法很好地处理时。例如,你可能想训练:
- 一个具有独特词汇表和长程依赖的 DNA 模型
- 一个需要深度熟悉领域专用术语和逻辑的法律或金融模型
第二个相关原因是 部署约束(deployment constraints):当你需要一个针对特定硬件、延迟或隐私要求定制的模型时。这里的例子可能包括在无人机上运行的 LLM,或者使用 FPGA 等定制硬件的本地部署系统。
这里有一个简单的测试:花几天时间在 Qwen3、Gemma 3 或其他当前 SOTA(最先进)模型的基础上构建。你能否通过 prompting(提示)、工具使用或后训练达到你的性能目标?如果不能,那大概是时候训练自己的模型了。
即使满足你的需求所需的后训练预算是巨大的,它仍然可能比从头开始更划算。为你的模型进行 1 万亿 token 的微调,比从头开始训练 10 万亿+ token 更经济。
构建自己的内部语言模型的第三个原因是 安全与治理(safety and governance):你需要对训练数据、模型行为和更新周期有完全的控制,因为你处于受监管的行业或高风险的应用场景中。你需要 确切 知道模型中包含了什么,并能够向监管机构证明。在某些情况下,你可能没有其他选择,只能构建自己的模型。
这些是公司训练内部模型的主要原因——那么发布开放模型的公司或组织呢?
战略性开源:你能填补某个空白吗?
有经验的 AI 实验室发布新开放模型的最常见原因之一,是他们发现了开源生态系统中一个特定的空白或新的 AI 用例。
这种模式通常是这样的:你注意到一个尚未被充分探索的领域——也许没有强大的支持超长上下文的设备端(on-device)模型,或者多语言模型存在但在低资源语言上表现薄弱,或者该领域正在向 Genie 3 这样的交互式世界模型发展,但还没有好的开放权重模型存在。
你有理由相信自己能做得更好:也许你整理了更好的训练数据,开发了更好的训练方案,或者有算力在别人无法做到的地方进行过度训练。你的目标是具体的:不是”有史以来最好的模型”,而是”最佳的 30 亿参数设备端模型”或”首个拥有 100 万 token 上下文窗口的小模型”。
这是一个真实的目标,成功能创造价值:开发者采用你的模型,它成为他人的基础设施,或者建立起技术可信度。但成功需要经验。你需要知道什么是真正可行的,以及如何在竞争激烈的空间中可靠地执行。为了让这一点更具体,让我们看看 Hugging Face 是如何思考这个问题的。
Hugging Face 的历程
那么,Hugging Face 为什么要训练开放模型?答案很简单:我们构建对开源生态系统有用的东西,填补很少有人在填补的空白。
这包括数据集、工具链和模型训练。我们启动的每一个 LLM 训练项目,都始于发现一个空白并相信我们能够贡献一些有意义的东西。
我们在 GPT-3 (Brown et al., 2020) 发布后开始了第一个 LLM 项目。当时,感觉没有其他人在构建开放的替代品,我们担心这些知识会被锁在少数几个行业实验室里。于是我们启动了 BigScience 研讨会,旨在训练 GPT-3 的开放版本。最终的模型是 BLOOM,由数十名贡献者历时一年,构建训练堆栈、tokenizer(分词器)和预训练语料库,预训练了一个 1750 亿参数的模型。
BLOOM 的继任者是 2022 年的 StarCoder (Li et al., 2023)。OpenAI 为 GitHub Copilot 开发了 Codex (Chen et al., 2021),但它是闭源的。构建一个开源替代品显然会为生态系统提供价值。于是,在 ServiceNow 的合作下,在 BigCode 的旗帜下,我们构建了 The Stack 数据集,并训练了 StarCoder 15B 来复现 Codex。StarCoder2 (Lozhkov et al., 2024) 则来自于我们意识到可以训练更长时间,并认识到更小的模型训练更长时间可能比一个大模型更有价值。我们在数万亿 token 上训练了一个模型家族(30 亿/70 亿/150 亿参数),远超当时任何开放代码模型的训练量。
SmolLM 家族 遵循了类似的模式。我们注意到强大的小模型非常稀少,而我们刚刚构建了 FineWeb-Edu (Penedo et al., 2024),这是一个强大的预训练数据集。SmolLM(1.35 亿/3.6 亿/17 亿参数)是我们的第一个版本。SmolLM2 (Allal et al., 2025) 专注于更好的数据和更长时间的训练,在多个方面达到了 SOTA 性能。SmolLM3 将参数规模扩展到 30 亿,同时增加了混合推理(hybrid reasoning)、多语言能力(multilinguality)和长上下文(long context)——这些都是社区在 2026 年重视的特性。
这种模式延伸到了预训练之外:我们训练了 Zephyr (Tunstall et al., 2023) 以证明 DPO(直接偏好优化)在规模上有效,启动了 Open-R1 来复现 DeepSeek-R1 的蒸馏 pipeline(流水线),并发布了 OlympicCoder 用于竞争性编程,在国际信息学奥林匹克竞赛中达到 SOTA 性能。我们还探索了其他模态,包括用于视觉的 SmolVLM (Marafioti et al., 2025) 和用于机器人的 SmolVLA (Shukor et al., 2025)。
希望本章已经让你相信,深入思考为什么要训练模型是有价值的。
对于本指南的其余部分,我们将假设你已经完成了这番自省,并有充分的理由进行训练。
训练什么:将目标转化为决策
现在你知道了 为什么 要训练,那 应该 训练什么?“训练什么”是指模型类型(dense(稠密)、mixture of experts(专家混合)、hybrid(混合)或其他新型架构)、模型大小、架构细节和数据混合。一旦确定了”为什么”,就可以推导出”训练什么”。例如:
- 设备端的快速模型 → 小型高效模型
- 多语言模型 → 大型 tokenizer(分词器)词汇表
- 超长上下文 → 混合架构
除了由用例驱动的决策之外,还有一些选择可以优化训练本身,使其更稳定、更高效或更快。这些决策并不总是那么明确,但你可以大致将决策过程分为以下几个阶段:
- 规划(Planning): 在运行实验之前,将你的用例映射到需要决定的组件。你的部署环境决定了模型大小的约束。你的时间线决定了你可以承担哪些架构风险。你的目标能力决定了数据集要求。这个阶段是将”为什么”中的每个约束条件与”训练什么”中的具体规格联系起来。
- 验证(Validation): 一旦有了起点和潜在修改列表,就要系统地测试。由于测试代价高昂,要专注于能够有意义地改善你用例性能或优化训练的变更。这就是消融实验(ablation)发挥作用的地方,在 “每个大模型都从一个小型消融实验开始” 中会详细介绍。
在无关紧要的选择上进行完美的消融实验,和在重要选择上进行马虎的消融实验,浪费的算力是一样多的。
在接下来的章节中,你将了解定义模型的所有选项,以及如何通过系统化实验缩小选择范围。在深入之前,我们想分享一些关于如何组建团队和推进项目的经验——这些经验来自我们自己训练模型以及观察其他优秀团队构建伟大 LLM 的过程。
核心优势:速度与数据
当然,条条大路通罗马,但我们发现,迭代速度 是成功的 LLM 训练团队始终如一的制胜法宝。训练 LLM 本质上是一门”从做中学”的学问:你训练的次数越多,你的团队就会越强。所以,在每年训练一个模型的团队和每季度训练一个模型的团队之间,后者的进步速度要快得多。看看 Qwen 和 DeepSeek 的团队就知道了——如今已是家喻户晓的名字,他们有着以快速节奏持续发布新模型的长期记录。
除了迭代速度,迄今为止对 LLM 训练影响最大的方面是 数据整理(data curation)。人们天然倾向于钻研架构选择来改进模型,但在 LLM 训练中出类拔萃的团队,是那些对高质量数据的痴迷超过一切的团队。
另一个与迭代速度密切相关的方面是 团队规模。对于主要的预训练任务,你只需要少数几个人,加上足够的算力来执行。要在今天预训练一个类似 Llama 3 的模型,你可能只需要两三个人。一旦你开始涉足更多样化的训练和下游任务(多模态、多语言、后训练等),你需要增加更多人来在每个领域出类拔萃。
所以,从一个精干、装备齐全的小团队开始,每两三个月发布一个新模型,在短时间内你就能跻身顶尖。本指南的其余部分将专注于这个团队的日常技术工作!
每个大模型都从小规模消融实验起步
在开始训练 LLM(大语言模型)之前,我们需要做出许多决策,这些决策将决定模型的性能和训练效率。哪种架构最适合我们的使用场景?该用什么 optimizer(优化器)和学习率调度?应该混合哪些数据源?
这些决策是如何做出的,是个常被问到的问题。人们有时期待这需要深思熟虑。诚然,战略性思考至关重要——正如我们在上一节中所讲——但光靠推理是不够的。LLM 领域并不总是符合直觉,对”应该有效”的假设有时在实践中行不通。
举个例子,使用看起来”质量最高的数据”并不总能带来更强的模型。以 arXiv 为例,它汇集了人类大量的科学知识。直觉上,训练如此丰富的 STEM(科学、技术、工程、数学)数据应该能产出更优秀的模型,对吗?但实践中并非如此,尤其对于较小的模型,这甚至可能损害性能 (Shao et al., 2024)。为什么?arXiv 论文虽然知识丰富,但高度专业化,写作风格狭窄,与模型最擅长学习的多样化通用文本差异较大。
那么,如果死盯着问题苦思冥想没有用,我们怎么知道什么有效?我们像优秀的实证主义者一样,大量做实验!机器学习不是纯粹的数学,它本质上是一门实验科学。
由于这些实验将指导我们许多关键决策,把它们设置好真的非常重要。我们对实验基本上有两个核心要求:
- 速度: 实验要尽可能快,这样我们才能频繁迭代。能跑的消融实验越多,能验证的假设就越多。
- 可靠性: 实验应具备强判别力。如果我们观察的指标无法在早期有意义地区分不同设置,消融实验可能就没什么收获(如果指标噪声太大,我们还可能在追逐噪声!)。更多细节请参考我们关于将 FineWeb 扩展到 1000+ 种语言的博客文章。
在设置消融实验之前,我们需要先对架构类型和模型规模做出一些基础性选择。这些决策——由我们的指南针引导——影响着我们选用哪个训练框架、如何分配算力预算,以及从哪个基线出发。
对于 SmolLM3,我们选择了 3B 参数的密集型 Llama 风格架构,因为我们的目标是小型设备端模型。但正如你将在”设计模型架构”中看到的,mixture of experts(专家混合,MoE)或 hybrid model(混合模型)可能更适合你的使用场景,不同的模型规模也有不同的权衡取舍。我们稍后会深入探讨这些选择,并告诉你如何做决定。现在,让我们从最实际的第一步开始:选择你的基线。
选择你的基线
每个成功的模型都建立在经过验证的基础上,并针对自身需求进行修改。当 Qwen 训练其第一个模型系列时 (Bai et al., 2023),他们以 Llama 的架构为起点。当 Meta 训练 Llama 3 时,他们以 Llama 2 为起点。Kimi K2 则从 DeepSeek-V3 的 MoE 架构出发。这不仅适用于架构,也适用于训练超参数和优化器。
为什么?设计良好的架构和训练设置需要许多组织经过多年迭代。标准 transformer(变换器)和 Adam 等优化器经过了数千次实验的打磨。人们发现了它们的失效模式,调试了不稳定性,优化了实现方式。从经过验证的基础出发意味着继承了所有这些积累的知识。从头开始则意味着要自己重新踩每一个坑。
一个好的起点架构应该:
- 符合你的约束条件 ,与你的部署目标和使用场景对齐
- 经过规模验证 (在相似或更大规模的万亿 token 训练中得到验证)
- 文档完善 ,具有已知的、在开放模型中被证明有效的超参数
- 具有良好的框架支持 (理想情况下,应在你考虑的训练框架和计划使用的推理框架中得到支持)
以下是截至撰写本文时(2026 年初)各类架构的强力 2025 基线选项(非穷举列表):
| Architecture Type | Model Family | Sizes |
|---|---|---|
| Dense | Llama 3.1 | 8B, 70B |
| Dense | Llama 3.2 | 1B, 3B |
| Dense | Qwen3 | 0.6B, 1.7B, 4B, 14B, 32B |
| Dense | Gemma 3 | 12B, 27B |
| Dense | SmolLM2, SmolLM3 | 135M, 360M, 1.7B, 3B |
| MoE | Qwen3 MoE | 30B-A3B, 235B-A122B |
| MoE | gpt-oss | 21B-A3B, 117B-A5B |
| MoE | Kimi Moonlight | 16B-A3B |
| MoE | Kimi K2 | 1T-A32B |
| MoE | DeepSeek-V3 | 671B-A37B |
| Hybrid | Zamba2 | 1.2B, 2.7B, 7B |
| Hybrid | Falcon-H1 | 0.5B, 1.5B, 3B, 7B, 34B |
| MoE + hybrid | Qwen3-Next | 80B-A3B |
| MoE + hybrid | MiniMax-01 | 456B-A46B |
| MoE + hybrid | MiMo-V2-Flash | 309B-A15B |
找到你的架构类型,选择一个参数量接近你目标的基线。不必想太多,因为你起步的架构并非一成不变。在下一节中,你将看到如何从基线出发,得到最适合你的最终架构。
修改你的基线:去风险化的纪律
现在你有了一个有效且适合你使用场景的基线。你可以到此为止,直接训练它,假如数据混合足够好,很可能也能得到一个不错的模型。很多成功项目就是这么做的。但基线并非针对你的特定约束进行了优化;它们是为构建者自己的使用场景和部署目标而设计的。这意味着可能存在值得做的修改,以更好地与你的目标对齐。然而,每一次架构变更都伴随着风险:可能提升性能,可能拖垮性能,也可能毫无效果而白白消耗消融算力。
让你保持正轨的纪律叫做 去风险化(derisking) :未经测试证明有效的改动,一律不要采用。
当测试表明某项改动能提升目标能力的性能, 或在不超出可接受损失范围的前提下带来有意义的收益 (例如,更快的推理速度、更低的内存占用、更好的稳定性), 则认为该改动已完成去风险化。
棘手之处在于,你的基线和训练设置有许多可以修改的组件:attention mechanism(注意力机制)、positional encoding(位置编码)、activation function(激活函数)、optimizer(优化器)、训练超参数、normalization scheme(归一化方案)、模型布局等等。每一项都代表一个潜在的实验,而这些组件往往以非线性方式相互作用。你既没有时间也没有算力测试所有内容或探索所有交互。
因此,先针对当前基线测试有潜力的改动。当某项改动有效时,将其整合以创建新基线,然后再针对该基线测试下一项改动。如果你的算力预算允许,可以逐一测试每项改动并进行留一法分析。不要陷入对每个超参数进行穷举网格搜索、或测试每一个新出现的架构变体的陷阱。
知道如何运行实验还不够;你还需要知道哪些实验值得运行。 在测试任何修改之前,先问自己两个问题:
- 这对我的特定使用场景有帮助吗?
- 这能优化我的训练吗?
如果一项修改没有明确针对上述任一目标,跳过它。
现在你已经知道如何通过战略性规划识别有潜力的方向,是时候进入实证验证阶段了。在接下来的几节中,我们将展示如何在实践中测试这些改动。我们将介绍如何建立可靠的实验、解读结果,以及避免常见陷阱。然后,在后续章节中,我们将通过具体示例演示如何测试流行的架构、数据、基础设施和训练决策。
选择训练框架
我们需要做的第一个决定是使用哪个框架来训练模型,进而用于所有消融实验。
这一选择涉及三个关键考量之间的平衡:
- 框架必须支持我们的目标架构,或者允许我们轻松扩展它。
- 它需要稳定且生产就绪,不会在训练中途莫名其妙地崩溃。
- 它应提供强大的 throughput(吞吐量),让我们能快速迭代并充分利用算力预算。
在实践中,这些要求可能相互拉扯,产生权衡取舍。让我们看看一些可用选项:
| Framework | Features | Battle-Tested | Optimized | Lines of Code (Core / Total) | Extensibility & Debugging |
|---|---|---|---|---|---|
| Megatron-LM | ✅ Extensive | ✅ Kimi K2, Nemotron | ✅ Pioneers of 3D parallelism | 93k / 269k | ⚠️ Hard for beginners |
| DeepSpeed | ✅ Extensive | ✅ BLOOM, GLM | ✅ Pioneers of ZeRO & 3D parallelism | 94k / 194k | ⚠️ Hard for beginners |
| TorchTitan | ⚡ Growing feature set | ⚠️ Newer but tested by PyTorch team | ⚡Optimized for dense models, MoE improvements underway | 7k / 9k | ⚡ Moderate: requires parallelism know-how |
| Nanotron | 🎯 Minimal, tailored for HF pretraining | ✅ Yes (StarCoder, SmolLM) | ✅ Optimized (UltraScale Playbook) | 15k / 66k | ⚡ Moderate: requires parallelism know-how |
该表格总结了主流框架之间的关键权衡。前三个框架的代码行数来自 TorchTitan 技术报告 (Liang et al., 2025)。让我们更详细地讨论每一个:
- NVIDIA 的 Megatron-LM 已经存在多年,久经实战检验。它是 Kimi K2 (Team et al., 2025) 等模型的训练引擎;吞吐量出色,拥有我们所需的大部分生产特性。但成熟带来了复杂性:对新手来说,代码库可能难以导航和修改。
- DeepSpeed 属于类似的类别。它是 ZeRO 优化的先驱,支撑了 BLOOM 和 GLM 等模型的训练。与 Megatron-LM 一样,它经过了广泛的实战检验和优化,但同样面临复杂性挑战。庞大的代码库(共 194k 行)在入门时可能令人望而生畏,尤其是在实现自定义功能或调试意外行为时。
- 另一方面,PyTorch 最近推出的 TorchTitan 库则轻量得多,由于代码库紧凑且模块化,更易于导航。它具备预训练所需的核心功能,非常适合快速实验。然而,由于相对较新,它不如前者经受过广泛实战检验,并且在积极开发中可能仍有些不稳定。
- Nanotron 是我们从头构建的框架。这给了我们充分的灵活性和对大规模预训练的深入理解——这些洞察后来演变为 Ultra-Scale Playbook。自从我们开源这个库以来,也获得了社区的宝贵反馈,尽管大多数情况下我们需要先自己进行实战检验。该框架现在支持训练所需的所有生产特性,但我们仍在完善 MoE 支持等领域。
在我们的场景下从头构建是合理的,但这需要团队在专业知识和时间上的大量投入,用于调试问题和补充缺失功能。一个强有力的替代方案是 fork 一个现有框架并针对你的需求进行增强。例如,Thinking Machines Lab 将他们的内部预训练库构建为 TorchTitan 的一个 fork。
最终,你的选择将取决于团队的专业知识、目标功能,以及你愿意在开发投入与使用最生产就绪选项之间如何取舍。
如果多个框架都能满足你的需求,请在你的特定硬件上比较它们的吞吐量。对于快速实验和速度测试,更简洁的代码库往往更胜一筹。
消融实验设置
选定框架之后,我们需要设计消融实验方案。我们需要的实验既要足够快以便快速迭代,又要足够大以提供有意义的信号并能迁移到最终模型。
建立我们的消融实验框架
消融实验的目标是在小规模下运行实验,并获得可以自信地外推到最终生产运行的结果。
主要有两种方法。第一种,我们可以取目标模型大小,用较少的 token 对其进行训练。对于 SmolLM3 的消融实验,我们在 100B token 上训练了完整的 3B 模型,而非最终的 11T。第二种,如果我们的目标模型太大,可以训练一个更小的代理模型用于消融实验。例如,当 Kimi 开发其具有 32B 激活参数的 1T 参数 K2 模型时,对所有消融实验使用完整尺寸的代价过于高昂,因此他们在一个具有 0.5B 激活参数的 3B MoE 上运行了部分消融实验 (Team et al., 2025)。
一个关键问题是,这些小规模发现是否真的能够迁移。根据我们的经验,如果某件事在小规模下损害了性能,你可以自信地在大规模下将其排除。但如果某件事在小规模下有效,你需要确保已经训练了合理数量的 token,才能以较高概率得出这些发现会外推到更大规模的结论。训练时间越长,消融模型越接近最终模型,效果越好。
我们决定对所有消融实验使用一个基线 vanilla transformer(标准变换器)。我们的主要设置是一个遵循 Llama 3.2 1B 架构的 1B transformer,在 45B token 上训练。使用此 Nanotron 配置在八张 H100 的节点上大约需要一天半时间(每 GPU 每秒 42k token)。
我们的基线 1B 配置以结构化的 YAML 格式捕获了所有关键训练细节。以下是关键部分:
## Datasets and mixing weights
data_stages:
- data:

    dataset:
      dataset_folder:
      - fineweb-edu
      - stack-edu-python
      - finemath-3plus

      dataset_weights:
      - 0.7
      - 0.2
      - 0.1

## Model architecture, Llama 3.2 1B configuration
model:
  model_config:
    hidden_size: 2048
    num_hidden_layers: 16
    num_attention_heads: 32
    num_key_value_heads: 8
    intermediate_size: 8192
    max_position_embeddings: 4096
    rope_theta: 50000.0
    tie_word_embeddings: true

## Training hyperparameters, AdamW with cosine schedule
optimizer:
  clip_grad: 1.0
  learning_rate_scheduler:
    learning_rate: 0.0005
    lr_decay_starting_step: 2000
    lr_decay_steps: 18000
    lr_decay_style: cosine
    lr_warmup_steps: 2000
    lr_warmup_style: linear
    min_decay_lr: 5.0e-05
  optimizer_factory:
    adam_beta1: 0.9
    adam_beta2: 0.95
    adam_eps: 1.0e-08
    name: adamW

## Parallelism, 1 node
parallelism:
  dp: 8  # Data parallel across 8 GPUs
  tp: 1  # No tensor or pipeline parallelism needed at 1B scale
  pp: 1

## Tokenizer
tokenizer:
  tokenizer_max_length: 4096
  tokenizer_name_or_path: HuggingFaceTB/SmolLM3-3B

## Batch size, sequence length and total training for 30B tokens
tokens:
  batch_accumulation_per_replica: 16
  micro_batch_size: 3 # GBS (global batch size)=dp * batch_acc* MBS * sequence=1.5M tokens
  sequence_length: 4096
  train_steps: 20000 # GBS * 20000 = 30B

...
在我们的消融实验中,我们将根据测试内容修改不同的部分,同时保持其他所有内容不变:model 部分用于架构选择,optimizer 部分用于优化器和训练超参数,data_stages 部分用于数据整理。
每次消融实验只改变一个变量,保持其他所有条件相同。 如果你同时改变多个变量而性能提升了,你将无法知道 是什么导致了提升。逐一测试修改,然后将成功的改动 组合起来,重新评估。
在运行消融实验时,一些架构改动会显著改变参数数量。例如,从 tied embedding(共享嵌入)切换到 untied embedding(独立嵌入)会使嵌入参数翻倍,而使用 grouped query attention(分组查询注意力)或 multi-query attention(多查询注意力)代替 multi-head attention(多头注意力)会大幅减少注意力参数(我们很快将详细讨论所有这些内容)。
为了确保公平比较,我们需要跟踪参数数量,并偶尔调整其他超参数(如 hidden size 或层数)以保持模型规模大致相同。以下是我们用来估算不同配置参数数量的一个简单函数:
from transformers import LlamaConfig, LlamaForCausalLM

def count_parameters(
    tie_embeddings=True,
    num_key_value_heads=4,
    num_attention_heads=32,
    hidden_size=2048,
    num_hidden_layers=16,
    intermediate_size=8192,
    vocab_size=128256,
    sequence_length=4096,
):
    config = LlamaConfig(
        hidden_size=hidden_size,
        num_hidden_layers=num_hidden_layers,
        num_attention_heads=num_attention_heads,
        num_key_value_heads=num_key_value_heads,
        intermediate_size=intermediate_size,
        vocab_size=vocab_size,
        max_position_embeddings=sequence_length,
        tie_word_embeddings=tie_embeddings,
    )
    model = LlamaForCausalLM(config)
    return f"{sum(p.numel() for p in model.parameters())/1e9:.2f}B"
我们还提供了一个交互式工具,用于可视化密集型 transformer 的 LLM 参数分布。在做出架构决策或为消融实验设置配置时,这非常实用。
理解什么有效:评估
一旦我们启动消融实验,如何知道什么有效,什么无效?
训练模型的人的第一直觉可能是看 loss(损失),是的,这很重要。你希望看到它平稳下降,没有剧烈波动或不稳定。对于许多架构选择,loss 与下游性能的相关性良好,有时就足够了 (Y. Chen et al., 2025)。然而,仅看 loss 并不总是可靠的。以数据消融为例,你会发现在 Wikipedia 上训练比在网页上训练得到更低的 loss(下一个 token 更容易预测),但这并不意味着你会得到更有能力的模型。同样,如果我们在不同运行之间更换 tokenizer(分词器),损失值之间无法直接比较,因为文本的切分方式不同。一些改动可能专门影响某些能力,如推理和数学,但会被平均 loss 掩盖。最后,模型可以在预训练 loss 收敛后继续在下游任务上提升 (Liu et al., 2022)。
我们需要更细粒度的评估来了解全貌,理解这些微妙的效果。一个自然的方法是使用下游评估来测试知识、理解、推理以及对我们重要的任何其他领域。
对于这些消融实验,专注于能提供良好早期信号并避免嘈杂 benchmark(基准测试)的任务很有用。在 FineTasks 和 FineWeb2 中,可靠的评估任务由四个关键原则定义:
- 单调性: 随着模型训练时间增加,benchmark 分数应持续提升。
- 低噪声: 当我们用相同设置但不同随机种子训练模型时,benchmark 分数不应剧烈波动。
- 高于随机的性能: 许多能力只在训练后期才涌现,因此在较长时间内仍处于随机水平的任务对消融实验没有用。例如,多选格式的 MMLU 就是这种情况,我们稍后会解释。
- 排名一致性: 如果一种方法在早期阶段优于另一种,这种顺序应在训练持续过程中保持稳定。
任务的质量也取决于任务表述方式(我们如何向模型提问)和指标选择(我们如何计算答案得分)。
三种常见的任务表述是 multiple choice format(MCF,多选格式) 、cloze formulation(CF,完形填空表述) 和 free-form generation(FG,自由生成) 。MCF 要求模型从明确呈现在提示中并以 A/B/C/D 为前缀的选项中选择一个(如 MMLU 的做法)。CF 中,我们比较不同选项的可能性,以确定哪个更可能,而无需在提示中提供这些选项。FG 中,我们查看给定提示的 greedy generation(贪婪生成)的准确性。FG 需要模型有大量的潜在知识,通常难度过大,对于在完整训练运行前的短暂预训练消融实验来说实用性不足。因此,我们在运行小规模消融实验时专注于多选表述(MCF 或 CF)。
对于经过后训练(post-trained)的模型,FG 成为主要表述形式, 因为我们在评估模型是否能实际生成有用的回复。 我们将在”超越基础模型——后训练”中介绍这些模型的评估。
研究还表明,模型在训练早期难以应对 MCF,因此 CF 对于早期信号更好 (Du et al., 2025; Gu et al., 2025; J. Li et al., 2025)。因此,我们对小规模消融实验使用 CF,并在主运行中整合 MCF(因为 MCF 在训练后期提供更好的信号)。为了在序列似然评估(如 CF)中给模型答案打分,我们将准确率计算为正确答案具有最高 log probability(对数概率,按字符数归一化)的问题百分比。这种归一化可以防止对较短答案的偏好。
我们的消融实验评估套件包含来自 FineWeb 消融实验的 benchmark,但不包括我们发现噪声过大的 SIQA。我们添加了 GSM8K 和 HumanEval 等数学和代码 benchmark,以及用于长上下文消融实验的长上下文 benchmark RULER。这一任务聚合测试了各种格式下的世界知识、推理和常识,如下表所示。为了以增加少量噪声为代价加速评估,我们对每个 benchmark 只评估 1,000 道题(GSM8K、HumanEval 和 RULER 除外,在 3B SmolLM3 消融实验中我们使用完整版本,但在 1B 实验中省略)。我们使用 CF 来评估所有多选 benchmark,如前文所述。请注意,对于多语言消融实验和实际训练,我们会添加更多 benchmark 来测试多语言能力,详见后文。这些评估使用 LightEval 运行。以下是每个 benchmark 关键特性的摘要:
| Benchmark | Domain | Task Type | Questions | What It Tests |
|---|---|---|---|---|
| MMLU | Knowledge | Multiple choice | 14k | Broad academic knowledge across 57 subjects |
| ARC | Science & reasoning | Multiple choice | 7k | Grade school science reasoning |
| HellaSwag | Common-sense reasoning | Multiple choice | 10k | Common-sense reasoning about everyday situations (narrative completion) |
| WinoGrande | Common-sense reasoning | Binary choice | 1.7k | Pronoun resolution requiring world knowledge |
| CommonSenseQA | Common-sense reasoning | Multiple choice | 1.1k | Common-sense reasoning about everyday concepts |
| OpenBookQA | Science | Multiple choice | 500 | Elementary science facts with reasoning |
| PIQA | Physical common sense | Binary choice | 1.8k | Physical common sense about everyday objects |
| GSM8K | Math | Free-form generation | 1.3k | Grade school math word problems |
| HumanEval | Code | Free-form generation | 164 | Python function synthesis from docstrings |
让我们看几道示例题,以具体了解这些评估实际测试的内容:
你可以在交互版本中浏览示例,了解每个 benchmark 中的题目类型。请注意,MMLU 和 ARC 以多选形式测试事实知识,GSM8K 需要计算数学问题的数值答案,而 HumanEval 则需要生成完整的 Python 代码。这种多样性确保我们在整个消融实验过程中测试了模型能力的不同方面。
消融实验的数据混合方案?
对于 架构消融实验 ,我们在一个固定的高质量数据集混合上进行训练,这些数据集能在各类任务上提供早期信号。我们使用英语(FineWeb-Edu)、数学(FineMath)和代码(Stack-Edu-Python)。架构发现应该能很好地外推到其他数据集和领域,包括多语言数据,因此我们可以保持数据混合简单。
对于 数据消融实验 ,我们采取相反的方法:我们固定架构,系统地改变数据混合,以了解不同数据源如何影响模型性能。
扎实的消融实验设置的真正价值不仅仅是构建一个好模型。当主训练运行中出现问题时(无论我们做多少准备,这都会发生),我们希望对每个决定都有信心,并能快速识别哪些组件未经测试。这种准备可以节省调试时间,保护我们未来的心理健康。
估算消融实验成本
消融实验很棒,但需要 GPU 时间。了解这些实验的成本是值得的。下表显示了我们 SmolLM3 预训练的完整算力明细:主运行(含偶发停机时间)、训练前后的消融实验,加上因意外扩展问题而被迫重启和一些调试所消耗的算力(我们稍后将详细说明)。
| Phase | GPUs | Days | GPU Hours |
|---|---|---|---|
| Main pretraining run | 384 | 30 | 276,480 |
| Ablations (pretraining) | 192 | 15 | 69,120 |
| Ablations (mid-training) | 192 | 10 | 46,080 |
| Training reset / debugging | 384 / 192 | 3 / 4 | 46,080 |
| Total cost | - | - | 437,760 |
这些数字揭示了一个重要事实:消融实验和调试共消耗了 161,280 GPU 小时,超过我们主训练运行成本的一半(276,480 GPU 小时)。在 SmolLM3 的开发过程中,我们进行了超过 100 次消融实验:预训练消融实验花费了 20 天,中间训练消融实验花费了 10 天,从上述意外训练问题中恢复花费了 7 天。
这凸显了为什么消融实验成本必须纳入你的算力预算:计划时要将训练成本加上消融实验,再加上一个应对意外的缓冲。如果你的目标是达到 SOTA(最先进)性能、实现新架构改动,或者还没有经过验证的配方,消融实验就会成为一个重要的成本中心,而非小打小闹的实验。
在我们开始设计模型架构之前,让我们建立一些每个运行实验的人都应该遵守的基本规则。
参与规则
TL;DR(太长不读):保持偏执。
验证你的评估套件。 在训练任何模型之前,确保你的评估套件能够复现你将与之比较的模型的已发布结果。如果任何 benchmark 是生成式的(例如 GSM8k),要格外谨慎,手动检查几个样本,确保提示格式正确,以及任何后处理都能正确提取信息。由于评估将指导每一个决定,把这一步做对对项目的成功至关重要!
测试每一个变更,无论多小。 不要低估那个看似无害的库升级或”只改了两行”的提交的影响。这些小变化可能引入细微的 bug 或性能偏移,从而污染你的结果。你需要一个在对你重要的情况下有强大测试套件的库,以避免回归。
每次只改一件事。 实验之间保持其他所有条件完全相同。某些变化可能以意想不到的方式相互作用,因此你需要先评估每个变化的单独贡献,然后尝试组合它们以查看整体影响。
训练足够多的 token 并使用充分的评估。 正如我们前面提到的,你需要确保评估套件有良好的覆盖率,并训练足够长的时间以获得可靠信号。在这里走捷径会导致嘈杂的结果和错误的决策。
遵循这些规则可能感觉过于谨慎,但替代方案是花数天时间调试神秘的性能下降,结果发现是几天前一个不相关的依赖项更新造成的。黄金原则:一旦你有了一个好的设置, 任何变更都不应未经测试就投入使用!
设计模型架构
现在我们的实验框架已经到位,是时候做出定义模型的重大决策了。我们做出的每一个选择——从模型规模到注意力机制(attention mechanism)再到分词器(tokenizer)——都会产生约束和机遇,影响模型训练和使用。
请记住训练罗盘:在做任何技术选择之前,我们需要对为什么和是什么有清晰的认识。我们为什么要训练这个模型,它应该是什么样的?
这听起来显而易见,但正如我们之前解释的那样,在这里保持深思熟虑会塑造我们的决策,并使我们不至于迷失在无尽的实验空间中。我们的目标是打造一个英文领域的 SOTA 模型吗?长上下文是优先考虑的吗?还是我们在尝试验证一种新架构?这些情况下的训练循环可能看起来相似,但我们运行的实验和接受的权衡会有所不同。早早回答这些问题有助于我们决定如何在数据和架构工作之间分配时间,以及在开始训练之前在每个方面进行多少创新。
因此,让我们以身作则,回顾一下指导 SmolLM3 设计的目标。我们希望构建一个适用于设备端应用的强大模型,具备有竞争力的多语言性能、扎实的数学和编程能力,以及强健的长上下文处理能力。如我们之前所提到的,这促使我们选择了拥有 3B 参数的密集模型(dense model):足够大以具备强大能力,但又足够小以能舒适地运行在手机上。考虑到边缘设备的内存限制和我们的项目时间线(大约三个月),我们选择了密集 Transformer 而非混合专家模型(MoE)或混合架构。
我们有一个在较小规模(1.7B 参数)下针对英文的 SmolLM2 成熟方案,但扩展规模意味着需要重新验证所有内容,并应对新挑战,如多语言性和扩展上下文长度。明确的目标塑造了我们的方法。例如,在 SmolLM2 中,我们在预训练结束时难以扩展上下文长度,因此对于 SmolLM3,我们从一开始就做出了架构选择——例如使用 NoPE 和文档内掩码(intra-document masking,详见后文)——以最大化我们成功的机会,而这果然奏效了。
一旦目标明确,我们就可以开始做出将其付诸实践的技术决策。在本章中,我们将介绍对这些核心决策的系统性方法:架构、数据和超参数。将此视为战略规划阶段——把这些基础搞对,将使你在实际的训练马拉松中免于代价高昂的错误。
架构选择
如果你看看 Qwen3、Gemma 3 或 DeepSeek-V3 等近期模型,你会发现尽管它们之间存在差异,但都共享同一基础:2017 年提出的 Transformer 架构 (Vaswani et al., 2023)。其基本结构多年来变化不大,但其核心组件已有所改进。无论你是在构建密集模型、混合专家模型(mixture of experts model),还是混合架构,你都是在使用相同的构建模块。
这些改进来自于各团队对更好性能的追求,以及对特定挑战的应对:推理时的内存约束、大规模训练的不稳定性、处理更长上下文的需求。一些改动,如从多头注意力(multi-head attention)转向计算效率更高的分组查询注意力(grouped query attention,GQA (Ainslie et al., 2023)),已被广泛采用。另一些,如不同的位置编码(positional encoding)方案,仍在讨论之中。最终,今天的实验将会凝结成明天的基线。
那么,大型语言模型(LLM)今天实际在用什么?让我们看看领先模型已经收敛到了什么方案。遗憾的是,并非所有模型都公开了其训练细节,但我们从 DeepSeek、OLMo、Kimi 和 SmolLM 等模型家族中获得了足够的透明度,可以看到当前的全貌:
| Model | Architecture | Parameters | Training Tokens | Attention | Context Length (Final) | Positional Encoding | Precision | Init (Std) | Optimizer | Max LR | LR Schedule | Warmup Steps | Batch Size |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DeepSeek LLM 7B | Dense | 7B | 2T | GQA | 4k | RoPE | BF16 | 0.006 | AdamW | 4.2×10⁻⁴ | Multi-step | 2k | 9.4M |
| DeepSeek LLM 67B | Dense | 67B | 2T | GQA | 4k | RoPE | BF16 | 0.006 | AdamW | 3.2×10⁻⁴ | Multi-step | 2k | 18.9M |
| DeepSeek-V2 | MoE | 236B (21B active) | 8.1T | MLA | 128k | Partial RoPE | - | 0.006 | AdamW | 2.4×10⁻⁴ | Multi-step | 2k | 9.4M→37.7M (warmup 225B) |
| DeepSeek-V3 | MoE | 671B (37B active) | 14.8T | MLA | 128k | Partial RoPE | FP8 | 0.006 | AdamW | 2.2×10⁻⁴ | Multi-step + cosine | 2k | 12.6M→62.9M (warmup 469B) |
| MiniMax-01 | MoE + hybrid | 456B (45.9 active) | 11.4T | Linear attention + GQA | 4M | Partial RoPE | - | Xavier init with DeepNorm scaling | AdamW | 2×10⁻⁴ | Multi-step | 500 | 16M→32M→64M→128M |
| Kimi K2 | MoE | 1T (32B active) | 15.5T | MLA | 128k | Partial RoPE | BF16 | Likely 0.006 | MuonClip | 2×10⁻⁴ | WSD | 500 | 67M |
| OLMo 2 7B | Dense | 7B | 5T | MHA | 4k | RoPE | BF16 | 0.02 | AdamW | 3×10⁻⁴ | Cosine | 2k | 4.2M |
| SmolLM3 | Dense | 3B | 11T | GQA | 128k | NoPE | BF16 | 0.02 | AdamW | 2×10⁻⁴ | WSD | 2k | 2.3M |
如果你还不理解其中一些术语,例如 MLA、NoPE 或 WSD,不用担心;我们将在本节中逐一解释。现在,只需注意其中的多样性:不同的注意力机制(MHA、GQA、MLA)、位置编码(RoPE、NoPE、partial RoPE)和学习率调度(cosine、multi-step、WSD)。
面对这一长串架构选择,甚至很难知道从哪里开始。和大多数此类情况一样,我们将一步一步来,逐渐积累所有必要的知识。我们将首先关注最简单的基础架构(密集模型),并详细研究每个架构方面。之后,我们将深入探讨 MoE 和混合模型,并讨论何时使用它们是个好选择。最后,我们将探索分词器(tokenizer)——一个经常被忽视和低估的组件。我们应该使用现有的还是训练自己的?我们又如何评估我们的分词器是否优质?
在本章的其余部分,我们通过消融实验(ablation)来验证大多数架构选择,使用上一章描述的实验设置:我们的 1B 基线模型(遵循 Llama 3.2 1B 架构),在来自 FineWeb-Edu、FineMath 和 Python-Edu 混合数据集的 45B tokens 上训练。对于每个实验,我们同时展示训练损失曲线和下游评估分数,以评估每项修改的影响。你可以在 HuggingFaceTB/training-guide-nanotron-configs 中找到所有运行的配置文件。
我们将从每个 LLM 的核心开始:注意力机制。
注意力机制(Attention)
Transformer 架构中最活跃的研究领域之一是注意力机制。尽管前馈层(feedforward layer)在预训练期间主导了计算量,但注意力在推理时(尤其是长上下文时)成为主要瓶颈,推高了计算成本和 GPU 内存需求,降低了吞吐量。让我们简要了解主要的注意力机制及其在能力与速度之间的权衡。
我的注意力需要多少个头(head)?
多头注意力(Multi-head attention,MHA) 是随原始 Transformer 架构引入的标准注意力机制 (Vaswani et al., 2023)。其核心思想是拥有 N 个注意力头(attention head),每个头独立执行相同的检索任务:将隐藏状态转换为查询(queries)、键(keys)和值(values),然后使用当前查询通过与键(K)的匹配来检索最相关的 token,最后转发与匹配 token 关联的值(V)。在推理时,我们不需要重新计算过去 token 的 KV 值;我们可以复用它们。存储过去 KV 值的内存被称为 KV 缓存(KV cache)。随着上下文窗口增长,这个缓存可能迅速成为推理瓶颈,消耗大量 GPU 内存。以下是一个简单的计算,用于估算采用 MHA 的 Llama 3 架构在序列长度为 8,192 时的 KV 缓存大小 :
请注意,前导因子 2 来自于同时存储键和值的缓存。如你所见,缓存大小随序列长度线性增长——但上下文窗口已呈指数级增长,现已达到数百万 token。提高缓存效率将使在推理时扩展上下文变得容易得多。
一个自然的问题是:我们真的需要为每个头提供新的 KV 值吗?可能不需要,多查询注意力(multi-query attention,MQA) (Shazeer, 2019) 和 分组查询注意力(grouped query attention,GQA) (Ainslie et al., 2023) 都解决了这个问题。最简单的选项是在所有头之间共享 KV 值,从而将 KV 缓存大小除以 (对于 Llama 3 70B 来说减少了 64 倍)!这就是 MQA 的思路,它被一些模型(如 StarCoder)用作 MHA 的替代方案。然而,这种方法可能会放弃我们不愿舍弃的一些注意力容量。另一个选项是在头的组之间共享 KV 值——例如,可能有四个头共享相同的 KV 值。这就是 GQA 方法,它在 MQA 和 MHA 之间取得了中间地带。
更近期,DeepSeek-V2 引入了多头潜在注意力(multi-head latent attention,MLA) (DeepSeek-AI et al., 2024),使用了不同的策略来压缩缓存(V3 中也使用了该策略):它不是减少 KV 值的数量,而是减少其大小,仅存储一个可在运行时解压缩为 KV 值的潜在变量(latent variable)。通过这种方法,DeepSeek 设法将缓存减少到相当于 GQA 2.25 组的大小,同时实现了比 MHA 更强的性能!为了使其与 RoPE(旋转位置嵌入,Rotary Positional Embedding)协同工作,需要一个带有额外小潜在向量的小调整。对于 DeepSeek-V2,主潜在变量选择了 ,RoPE 部分选择了 ,总计 。这同时用于 K 和 V,从而去掉了前导因子 2。
以下图形展示了每种注意力机制的可视化说明:
下表比较了本节中讨论的注意力机制。为简单起见,我们比较每个 token 使用的参数量;如果要计算总内存,只需乘以每个参数的字节数(通常为 2)和序列长度。
| 注意力机制 | 每个 Token 的 KV 缓存参数量 |
|---|---|
| MHA | |
| MQA | |
| GQA | |
| MLA |
现在让我们看看这些注意力机制在实际实验中的表现!
消融实验——GQA 优于 MHA
我们的基线模型使用 32 个查询头和 8 个 KV 头,对应于比率为 32 / 8 = 4 的 GQA。如果我们使用 MHA,或者使用更少的 KV 头和更高的 GQA 比率,性能会如何变化?
更改 KV 头的数量会影响参数数量,尤其是在 MHA 的情况下。为了保持一致性,我们为 MHA 运行调整了层数,因为否则会存在 100M+ 的参数差异;对于其余情况,我们保持默认的 16 层。我们将比较 MHA、MQA 以及四种 GQA 设置(比率 2、4、8、16)。你可以在此处找到 Nanotron 配置文件。
| 注意力类型 | 查询头数 | KV 头数 | 层数 | 参数量 | 备注 |
|---|---|---|---|---|---|
| MQA | 32 | 1 | 16 | 1.21B | |
| GQA (ratio 16) | 32 | 2 | 16 | 1.21B | |
| GQA (ratio 8) | 32 | 4 | 16 | 1.22B | 我们的基线 |
| GQA (ratio 4) | 32 | 8 | 16 | 1.24B | |
| GQA (ratio 2) | 32 | 16 | 15 | 1.22B | 减少了层数 |
| MHA | 32 | 32 | 14 | 1.20B | 减少了层数 |
| GQA (ratio 2) | 32 | 16 | 16 | 1.27B | 太大——未消融 |
| MHA | 32 | 32 | 16 | 1.34B | 太大——未消融 |
观察消融实验结果,我们发现 MQA 和仅 16 组的 GQA(分别只使用 1 和 2 个 KV 头)的性能明显弱于 MHA。另一方面,具有 2、4 和 8 组的 GQA 配置大致匹配 MHA 性能:
这些结果在损失曲线和下游评估中均保持一致。我们在 HellaSwag、MMLU 和 ARC 等基准测试中观察到这一点非常清晰,而 OpenBookQA 和 WinoGrande 等基准测试则显示出一些噪声。
根据这些消融实验,GQA 是 MHA 的可靠替代方案。它在保留性能的同时,推理效率更高。一些近期模型已采用 MLA 以实现更大的 KV 缓存压缩,尽管它尚未被广泛采用。由于在进行消融实验时 MLA 尚未在 Nanotron 中实现,我们没有对其进行消融。对于 SmolLM3,我们使用了 4 组的 GQA。
除了注意力架构本身之外,我们在训练期间使用的注意力模式也很重要。让我们来看看。
文档掩码(Document Masking)
我们如何在训练序列中应用注意力,既影响计算效率,也影响模型性能。这引出了文档掩码以及数据加载器中如何组织训练样本这一更广泛问题。
在预训练期间,我们使用固定的序列长度进行训练,但我们的文档长度是可变的。一篇研究论文可能有 10k token,而一个简短的代码片段可能只有几百个。我们如何将可变长度的文档放入固定长度的训练序列中?用填充(padding)将较短的文档填充到目标长度会在无意义的填充 token 上浪费计算量。取而代之,我们使用打包(packing):将文档随机打乱并用序列结束(EOS)token 连接起来,然后将结果分割成与序列大小匹配的固定长度块。
以下是实践中的效果:
File 1: "Recipe for granola bars..." (400 tokens) <EOS>
File 2: "def hello_world()..." (300 tokens) <EOS>
File 3: "Climate change impacts..." (1000 tokens) <EOS>
File 4: "import numpy as np..." (3000 tokens) <EOS>
...

After concatenation and chunking into 4k sequences:
Sequence 1: [File 1] + [File 2] + [File 3] + [partial File 4]
Sequence 2: [rest of File 4] + [File 5] + [File 6] + ...
如果一个训练序列足够长以填充我们的 4k 上下文,它可能包含一个完整的文件,但大多数文件比这短,因此序列通常包含多个随机文件的拼接。
在标准因果掩码(causal masking)下,token 可以注意到打包序列中所有之前的 token。在上面的例子中,文件 4 Python 脚本中的一个 token 可以注意到 granola bars 菜谱、函数定义和气候变化文章。
让我们看看一个典型的 4k 预训练上下文包含什么内容。一项快速分析表明,Common Crawl 和 GitHub 数据集中相当大比例(约 80–90%)的文件少于 2k token。以下图表检查了本指南中使用的更新数据集的 token 分布:
FineWeb-Edu、DCLM、FineMath 和 Python-Edu 中超过 80% 的文档也包含少于 2k token。这意味着,使用 2k 或 4k 训练序列和标准因果掩码时,绝大多数 token 会将计算量花费在注意力指向打包在一起的无关文档上。
虽然大多数基于网络的数据集由短文档组成,但基于 PDF 的数据集包含大量较长内容。FinePDFs 文档平均比网络文本长 2 倍,将它们与 FineWeb-Edu 和 DCLM 文档混合可以提高性能。
除了计算效率低下的问题之外,@zhao2024 还发现这种方法引入了来自无关内容的噪声,可能会降低性能。他们建议使用文档内掩码(intra-document masking),我们修改注意力掩码,使 token 只能注意到同一文档中的之前 token。以下可视化说明了其区别。
Zhu et al. (2025) 在 SkyLadder 中发现了文档内掩码的类似好处,但他们提供了不同的解释:他们发现较短的上下文长度在训练中效果更好,而文档内掩码有效地减少了平均上下文长度。
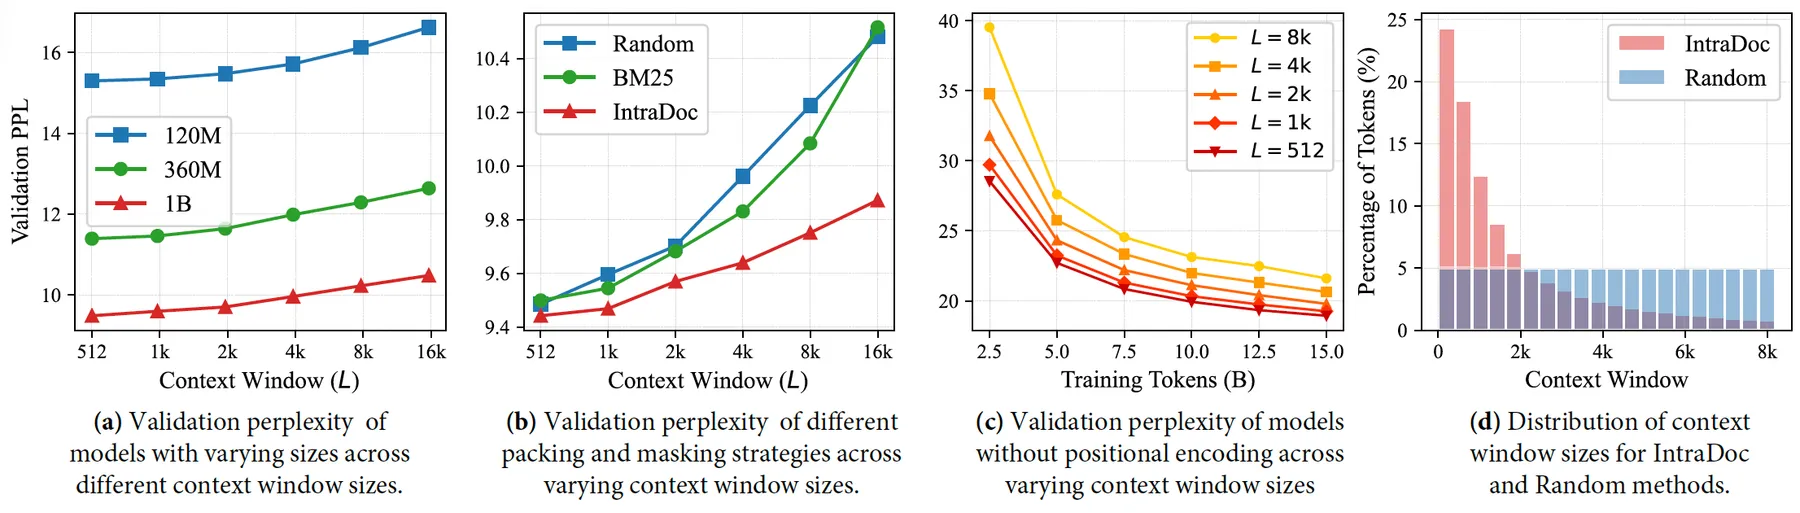
Meta 在训练 Llama 3 (Grattafiori et al., 2024) 时也使用了文档内掩码;他们发现在短上下文预训练期间影响有限,但在长上下文扩展时有显著好处,因为那时注意力开销变得更加显著。此外,ProLong 论文 (Gao et al., 2025) 表明,在持续预训练中使用文档掩码来扩展 Llama 3 8B 的上下文,对长上下文和短上下文基准测试都有益。
我们决定在 1B 基线模型上运行消融实验,测试文档掩码是否影响短上下文性能。你可以在此处找到配置文件。要在 Nanotron 中启用文档掩码,只需将 _use_doc_masking 标志设置为 true:
model_config:
  _attn_implementation: flash_attention_2
  _fused_rms_norm: true
  _fused_rotary_emb: true
- _use_doc_masking: false
+ _use_doc_masking: true
结果显示,与标准因果掩码相比,损失曲线和下游评估分数完全相同,如以下图表所示。
与 Llama 3 一样,我们没有观察到对短上下文任务的明显影响,除了在 PIQA 上有小幅改善。然而,文档掩码在扩展到长序列以加速训练时变得至关重要。这对于我们的长上下文扩展尤其重要,我们在那里将上下文从 4k 扩展到 64k token(详见”训练马拉松”)。因此,我们在 SmolLM3 的整个训练过程中采用了它。
在本节中,我们介绍了注意力如何处理序列。现在让我们看看 Transformer 中另一个主要参数块:嵌入(embeddings)。
嵌入共享(Embedding Sharing)
如果你查看我们基线消融模型的配置文件,与标准 Transformer 不同的一点是嵌入共享,由 tie_word_embeddings 标志启用。
LLM 有两个嵌入组件:输入嵌入(input embeddings),作为 token 到向量的查找表(大小为 vocab_size × hidden_dim);以及输出嵌入(output embeddings),即将隐藏状态映射到词汇表 logit 的最终线性层(hidden_dim × vocab_size)。在这两者为独立矩阵的经典情况下,嵌入参数总量为 2 × vocab_size × hidden_dim。因此,在小型语言模型中,嵌入可以占总参数数量的很大一部分,尤其是在词汇表较大的情况下。这使得嵌入共享(在输出中复用输入嵌入)成为小型模型的自然优化方案。
较大的模型通常不使用这种技术,因为嵌入在其参数预算中占比较小。例如,如以下饼图所示,在 Llama 3.2 8B 中,未共享的总嵌入仅占参数的 13%,在 Llama 3.1 70B 中仅占 3%。
消融实验——绑定嵌入的模型与更大的非绑定变体性能相当
让我们评估嵌入共享对我们消融模型的影响。我们将从 MobileLLM 在 125M 规模下对这一技术进行的全面消融中获得见解,该消融证明共享使参数数量减少了 11.8%,而精度损失极小。
由于非绑定嵌入(untied embeddings)将我们的参数数量从 1.2B 增加到 1.46B,我们将训练另一个具有非绑定嵌入但层数更少的模型,使其参数数量与基线 1.2B 模型相匹配。然后,我们将比较两个 1.2B 模型——我们具有绑定嵌入的基线(16 层)和具有 12 层的非绑定版本——以及具有非绑定嵌入且层数与基线相同的 1.46B 模型作为额外参考点。你可以在此处找到 Nanotron 配置文件。
损失和评估结果表明,尽管参数少了 18%,我们的基线 1.2B 绑定嵌入模型在所有基准测试(WinoGrande 除外)上都达到了与 1.46B 非绑定等效模型相当的性能。具有非绑定嵌入和减少层数(12 层 vs. 16 层)的 1.2B 模型在两种配置中表现均不如,呈现出更高的损失和更低的下游评估分数。这表明,在等效参数预算下,增加模型深度比解除嵌入绑定带来更大的收益。
根据这些结果,我们在 SmolLM3-3B 模型中保留了绑定嵌入。
然而,仅靠嵌入无法捕获序列中 token 的顺序;提供这一信息是位置编码(positional encoding)的职责。在下一节中,我们将探讨位置编码策略的演变,从标准 RoPE 到 NoPE(无位置嵌入,No Positional Embedding)等更新方法,后者能够更有效地对长上下文建模。
位置编码(Positional Encoding)与长上下文
当 Transformer 处理文本时,它们面临一个根本性挑战:它们天然地没有词序感,因为它们通过并行注意力操作同时处理整个序列。这使得训练效率很高,但也带来了问题。如果没有明确的位置信息,从模型的角度来看,“Adam beats Muon” 与 “Muon beats Adam” 看起来是一样的。
解决方案是位置嵌入(positional embeddings):为序列中每个 token 赋予唯一”地址”的数学编码。但随着我们向越来越长的上下文推进——从早期 BERT 的 512 token 到今天的数百万 token 模型——位置编码的选择对性能和计算效率都变得越来越关键。
位置编码的演进
早期 Transformer 使用简单的绝对位置嵌入(absolute positional embeddings),本质上是将每个位置(1、2、3……)映射到一个向量并添加到 token 嵌入上的学习查找表 (Vaswani et al., 2023)。这对短序列效果很好,但有一个主要限制:模型的最大输入序列长度受限于其训练时的最大输入序列长度。它们没有开箱即用的能力来泛化到更长的序列。
该领域因此向*相对位置嵌入(relative positional embeddings)*演进,这种方法捕获 token 之间的距离,而非其绝对位置。这在直觉上很有意义:两个词之间相差 3 个位置,比它们分别处于位置 (5,8) 还是 (105,108) 更重要。
ALiBi(带线性偏置的注意力,Attention with Linear Biases)(Press et al., 2022) 特别地根据 token 距离修改注意力分数。两个 token 相距越远,通过应用于注意力权重的简单线性偏置,其注意力受到的惩罚就越大。你可以在 labml.ai 找到 ALiBi 的详细实现。
然而,主导近期大型语言模型的技术是 RoPE (Su et al., 2023)。
RoPE:将位置表示为旋转
RoPE 的核心思想是在高维空间中将位置信息编码为旋转角度。RoPE 不是将位置向量添加到 token 嵌入,而是根据查询和键向量的绝对位置,按相应角度旋转它们。
其直觉是,我们将嵌入中的每对维度视为圆上的坐标,并通过以下因素确定的角度旋转它们:
- token 在序列中的位置
- 我们正在处理哪个维度对(不同的对以不同的频率旋转,这些频率是基础/参考频率的指数)
import torch

def apply_rope_simplified(x, pos, dim=64, base=10000):
    """
    Rotary Positional Embedding (RoPE)

    Idea:
    - Each token has a position index p (0, 1, 2, ...).
    - Each pair of vector dimensions has an index k (0 .. dim/2 - 1).
    - RoPE rotates every pair [x[2k], x[2k+1]] by an angle θ_{p,k}.


    Formula:
      θ_{p,k} = p * base^(-k / (dim/2))

    - Small k (early dimension pairs) → slow oscillations → capture long-range info.
    - Large k (later dimension pairs) → fast oscillations → capture fine detail.

    """
    rotated = []
    for i in range(0, dim, 2):
        k = i // 2  # index of this dimension pair

        # Frequency term: higher k → faster oscillation
        inv_freq = 1.0 / (base ** (k / (dim // 2)))
        theta = pos * inv_freq  # rotation angle for position p and pair k

        cos_t = torch.cos(torch.tensor(theta, dtype=x.dtype, device=x.device))
        sin_t = torch.sin(torch.tensor(theta, dtype=x.dtype, device=x.device))

        x1, x2 = x[i], x[i+1]

        # Apply 2D rotation
        rotated.extend([x1 * cos_t - x2 * sin_t,
                        x1 * sin_t + x2 * cos_t])

    return torch.stack(rotated)

## Q, K: [batch, heads, seq, d_head]
Q = torch.randn(1, 2, 4, 8)
K = torch.randn(1, 2, 4, 8)

## 👉 apply RoPE to Q and K *before* the dot product
Q_rope = torch.stack([apply_rope(Q[0,0,p], p) for p in range(Q.size(2))])
K_rope = torch.stack([apply_rope(K[0,0,p], p) for p in range(K.size(2))])

scores = (Q_rope @ K_rope.T) / math.sqrt(Q.size(-1))
attn_weights = torch.softmax(scores, dim=-1)
这段代码看起来可能比较复杂,我们用一个具体的例子来拆解。以短语 “The quick brown fox” 中的单词 “fox” 为例。在我们的基准 1B 模型中,每个注意力头处理的是一个 64 维的 query(查询)/key(键)向量。RoPE(旋转位置编码)将该向量分组为 32 对:(x₁, x₂)、(x₃, x₄)、(x₅, x₆),依此类推。我们按对处理,是因为我们在二维空间中绕圆旋转。为简单起见,我们只关注第一对 (x₁, x₂)。“fox” 在短语中出现在第 3 个位置,因此 RoPE 会将这第一个维度对旋转:
rotation_angle = position × θ₀
                = 3 × (1/10000^(0/32))
                = 3 × 1.0
                = 3.0 radians
                = 172° degrees
我们的基础频率(base frequency)是 10,000,但对于第一个维度对(k=0),指数为 0,因此基础频率不影响计算(我们将其指数化为 0 次方)。下面的可视化图示展示了这一点。
现在,当两个 token(词元)通过注意力机制发生交互时,神奇的事情就发生了。它们旋转后的表示之间的点积,通过旋转角度之间的相位差直接编码了相对距离(其中 m 和 n 是 token 的位置):
dot_product(RoPE(x, m), RoPE(y, n)) = Σₖ [xₖ * yₖ * cos((m-n) * θₖ)]
注意力模式只取决于(m-n),因此相距五个位置的 token 之间的角度关系始终相同,与它们在序列中的绝对位置无关。这样,模型就能学习到基于距离的模式,这些模式在序列的任意绝对位置都有效,也能泛化到更长的序列。
配置 RoPE(旋转位置编码)频率
在实践中,大多数 LLM 预训练都以相对较短的上下文长度(2–4k tokens)开始,使用 10k 或 50k 等 RoPE 基础频率。从一开始就使用很长的序列进行训练,由于注意力机制随序列长度呈二次方扩展,以及长上下文数据(超过 4k 上下文长度的样本)的有限性,计算成本会非常高,正如我们在 文档遮蔽 部分看到的那样。研究也表明,这可能损害短上下文的性能 (Zhu et al., 2025)。模型通常首先学习词语之间的短程关联,因此长序列在初期帮助不大。典型的做法是:大部分预训练使用较短的序列,然后进行持续预训练,或在最后数千亿 tokens 阶段切换到更长的序列。然而,随着序列长度的增加,与 token 位置成正比的旋转角度也会增大,这可能导致远处 token 的注意力分数衰减过快 (Rozière et al., 2024; Xiong et al., 2023):
θ = position x 1 / (base^(k/(dim/2)))
解决方案是在序列长度增加时相应增大基础频率,以防止这种衰减,常用方法包括 ABF 和 YaRN。
RoPE ABF(带调整基础频率的 RoPE) (Xiong et al., 2023b) 通过增大 RoPE 公式中的基础频率来解决长上下文中的注意力衰减问题。这种调整减慢了 token 位置之间旋转角度的变化速度,防止远处 token 的注意力分数衰减过快。ABF 可以分单阶段(直接提升频率)或多阶段(随上下文增长逐步提升)应用。该方法实现简单,并以更高的粒度分布嵌入向量,使模型更容易区分远距离位置。
虽然 ABF 简单有效,但其对所有维度的统一缩放对于极长上下文可能并不最优。 YaRN(Yet another RoPE extensioN,另一种 RoPE 扩展) (Peng et al., 2023) 则采用更复杂的方式,使用斜坡函数或缩放函数对 RoPE 各维度的频率进行不均匀插值。与 ABF 的统一调整不同,YaRN 对不同频率分量施加不同的缩放因子,从而优化扩展后的上下文窗口。它还包含动态注意力缩放和注意力 logit 温度调整等技术,有助于在极大上下文规模下保持性能。YaRN 支持高效的”短序列训练,长序列测试”策略,实现稳健外推所需的 tokens 更少、微调量也更少。与 ABF 相比,YaRN 对极长上下文通常能提供更好的实测性能,因为它提供更平滑的缩放并缓解了灾难性注意力损失问题。它也可以仅在推理阶段使用,无需任何微调。
这些频率调整方法减缓了注意力分数的衰减效应,并保持了远处 token 的贡献。例如,Qwen3 的训练过程中,随着序列长度从 4k 扩展到 32k 上下文窗口,频率从 10k 增加到 1M(使用 ABF),之后团队应用 YaRN 将上下文扩展到 131k,达到 4× 外推。需要注意的是,目前对最优值尚无强共识,通常在上下文扩展阶段尝试不同的 RoPE 值,找到适合特定配置和评估基准的最佳设置,是一个好习惯。
目前,大多数主流模型都使用 RoPE:Llama、Qwen、Gemma 及其他许多模型。这项技术已被证明在不同模型规模和架构(密集、MoE、混合)中都表现稳健。
混合位置编码方案
然而,随着模型向越来越大的上下文迈进 (Meta AI, 2025; Yang et al., 2025),即便是 RoPE 也开始面临性能挑战。在比 Needle in a Haystack(NIAH)(Kamradt, 2023) 更难的长上下文基准(如 RULER 和 HELMET (Hsieh et al., 2024; Yen et al., 2025))上评估时,在长上下文扩展阶段增大 RoPE 频率的标准方法存在局限性。为此,一些新技术被引入以提供帮助。
我们在本节开头提到,transformer(变换器)需要位置信息来理解 token 顺序,但近期研究对这一假设提出了挑战。如果显式位置编码根本不是必需的,又会怎样?
NoPE (Kazemnejad et al., 2023) 在不使用任何显式位置编码的情况下训练 transformer,允许模型通过因果遮蔽(causal masking)和注意力模式隐式学习位置信息。作者表明,与 ALiBi 和 RoPE 相比,这种方法展示出更好的长度泛化能力。由于没有显式位置编码需要在训练长度之外进行外推,NoPE 天然能处理更长的上下文。然而在实践中,NoPE 模型在短上下文推理和知识任务上往往弱于 RoPE 模型 (B. Yang et al., 2025)。这表明,尽管显式位置编码可能限制外推,但它们为训练上下文长度以内的任务提供了有益的归纳偏置(inductive biases)。
鉴于这些权衡,@rnope 认为结合不同位置编码策略可能是有趣的方向。他们引入的混合方法 RNoPE,在模型各层之间交替使用 RoPE 和 NoPE 层。RoPE 层提供显式位置信息,并通过近时偏置(recency bias)处理局部上下文,而 NoPE 层则改善了长距离的信息检索。这项技术最近被用于 Llama 4、Command A 和 SmolLM3。
为简化起见,本指南后续将 RNoPE 称为”NoPE”。(在讨论长上下文模型时,你经常会看到人们用”NoPE”来指代”RNoPE”。)
消融实验——NoPE 在短上下文文档上与 RoPE 相当
让我们来测试混合 NoPE 方案。我们将对比一个纯 RoPE 的 1B 消融基线、每四层去除一次位置编码的 NoPE 变体,以及第三种将 NoPE 与文档遮蔽结合的配置,以测试这两项技术之间的交互效果。我们的基本问题是:能否在获得长上下文能力的同时保持强短上下文性能?
损失和评估结果在三种配置下均表现相近,表明 NoPE 在保持强短上下文能力的同时,也为更好的长上下文处理奠定了基础。基于这些结果,我们在 SmolLM3 中采用了 NoPE + 文档遮蔽的组合方案。
另一个互补的思路是仅在模型隐藏维度的子集上应用 RoPE。与 RNoPE 在整个层级之间交替使用 RoPE 和 NoPE 不同, partial RoPE(部分 RoPE) 在同一层内将两者混合。GLM‑4.5 (5 Team et al., 2025) 和 MiniMax-01 (MiniMax et al., 2025) 等近期模型采用了这一策略,但它也存在于 GPT-J (Wang & Komatsuzaki, 2021) 等较早的模型中。所有使用 MLA(多头潜在注意力)的模型中也都有部分 RoPE,因为这对于合理的推理成本来说是必须的。
MLA 通过投影吸收(projection absorption)使推理高效:它不存储每个头的键 ,而是缓存一个小型共享潜在向量 ,并合并头的 query/key 映射,使每次计算的评分代价很低。令 ,,定义 ,可得:
然后用 与小型缓存 计算(不存储每个头的 )。RoPE 打破了这一机制,因为它在两个映射之间插入了一个位置相关的旋转。全维度 RoPE 下,
因此无法将 和 预先合并为固定的 。部分 RoPE 提供了解决方案:将头的维度拆分为 ,对大块不施加旋转(如前所述进行吸收:),仅对小块应用 RoPE。
限制长上下文的注意力范围
到目前为止,我们探讨了如何处理长上下文的位置信息:激活 RoPE、禁用它(NoPE)、在部分层(RNoPE)或部分隐藏维度(partial RoPE)上应用它,或调整其频率(ABF、YaRN)。这些方法通过修改模型编码位置的方式来处理比训练时更长的序列。但还有一种互补策略:与其调整位置编码,不如限制哪些 token 之间可以相互关注。
为了理解这为何重要,设想一个在 8 个 token 的序列上预训练的模型。在推理时,我们希望处理 16 个 token(超过训练长度)。位置 8–15 对于模型的位置编码来说是分布之外的。虽然 RoPE ABF 等技术通过调整位置频率来解决这一问题,注意力范围方法则采用不同的路径:它们有策略地限制哪些 token 之间可以相互关注,将注意力模式保持在熟悉的范围内,同时仍然处理完整序列。这同时降低了计算成本和内存需求。
下图比较了在预训练窗口为 8 的情况下处理 16 个 token 序列的五种策略。
分块注意力(Chunked attention) 将序列分成固定大小的块,token 只能在其所在块内进行关注。在我们的示例中,16 个 token 被分成两个 8 token 的块(0 到 7,以及 8 到 15)。注意,token 8 到 15 完全无法回顾前一个块。这造成了在块边界处重置的孤立注意力窗口。Llama 4 (Meta AI, 2025) 在 RoPE 层(每四个解码器层中的三个)使用 8,192 token 块的分块注意力,而 NoPE 层则保持完整的上下文访问。这通过限制每层的 KV 缓存大小来降低内存需求,但一个块中的 token 无法关注前一个块,这可能影响某些长上下文任务。
滑动窗口注意力(Sliding Window Attention,SWA) 由 Mistral 7B (Child et al., 2019; Jiang et al., 2023) 推广,基于”近期 token 最为相关”的直觉采用不同方法。每个 token 不再有硬性块边界,而是只关注最近的 N 个 token。如图所示,每个 token 可以向前回顾至多 8 个位置,形成一个在整个序列中连续滑动的窗口。注意 token 15 可以关注位置 8 到 15,而 token 10 则关注位置 3 到 10。窗口向前滑动,在整个序列中保持局部上下文,而没有分块的人为屏障。Gemma 3 将 SWA 与全注意力以交替层的形式结合,类似于混合位置编码策略混合不同技术的方式。
双块注意力(Dual Chunk Attention,DCA) (An et al., 2024) 是一种无需训练的方法,在扩展分块注意力的同时保持跨块信息流。在我们的示例中,使用块大小 s=4,将 16 个 token 分成 4 个块(想象沿对角线排列的 4×4 方块)。DCA 结合三种机制:
- 块内注意力:token 在其块内正常关注(对角线模式)
- 块间注意力:query(查询)使用位置索引 c−1=7 来关注前一个块,创建上限为 7 的相对位置
- 相邻块注意力:局部窗口 w=3,保持相邻块之间的局部性
这使所有相对位置都保持在训练分布内(0 到 7),同时在块边界处实现平滑过渡。DCA 使 Qwen2.5 等模型能够在推理时支持超长上下文窗口(最多 100 万 tokens),而无需在百万 token 序列上进行持续训练。
在具有长上下文的 transformer 模型中,一个有趣的现象出现了:即使序列中的初始 token 语义上并不重要,模型也会为其分配异常高的注意力分数。这些初始 token 作为注意力分布的稳定机制,充当注意力可以积聚的”汇点”(Xiao et al., 2024)。
实践启示是:在上下文超过缓存大小时,仅保留最初几个 token 的 KV 缓存以及近期 token 的滑动窗口,基本上就能维持性能。这一简单的修改使模型无需微调也能处理更长的序列,同时不会出现性能下降。
现代实现以不同方式利用注意力汇聚。原始研究建议在预训练期间添加一个专用占位符 token,作为显式的注意力汇聚点。最近,gpt-oss 等模型将注意力汇聚实现为可学习的逐头偏置 logit(learned per-head bias logits),附加到注意力分数上,而不是在输入序列中插入实际的 token。这种方式实现了同样的稳定效果,而无需修改 tokenized 输入。
有趣的是,gpt-oss 还在注意力层本身中使用了偏置单元——这种设计选择自 GPT-2 之后鲜有出现。虽然这些偏置单元通常被认为对标准注意力操作是多余的(Dehghani et al. 的实验结果表明其对测试损失影响微乎其微),但它们可以发挥实现注意力汇聚的专用功能。关键洞见在于:无论是作为特殊 token、可学习偏置还是逐头 logit 来实现,注意力汇聚都为长上下文场景中的注意力分布提供了稳定的”锚点”,使模型能够存储关于整个序列的普遍有用信息,即使上下文任意增长也不例外。
我们现在已经涵盖了注意力机制的核心组件:平衡内存与计算的不同头部配置(MHA、GQA、MLA),帮助模型理解 token 顺序的位置编码策略(RoPE、NoPE 及其变体),以及使长上下文变得可行的注意力范围技术(滑动窗口、分块和注意力汇聚)。我们还研究了嵌入层应如何配置和初始化。这些架构选择决定了模型如何处理和表示序列。
但拥有正确的架构只是成功的一半。即使设计良好的模型也可能遭受训练不稳定的问题,尤其是在大规模时。让我们来看看一些有助于保持训练稳定的技术。
提升稳定性
我们现在将转向 LLM 预训练中最大的挑战之一:不稳定性。这类问题通常表现为 loss spike(损失尖峰)或训练损失的突然跳跃,在大规模时尤为常见。
虽然我们将在”训练马拉松”部分深入探讨不同类型的尖峰及处理方法(涵盖浮点精度、优化器和学习率等话题),但某些架构和训练技术也能帮助我们减少不稳定性,因此让我们花时间研究一下它们。我们将介绍近期大规模训练运行(例如 OLMo 2 (OLMo et al., 2025) 和 Qwen3 (A. Yang, Li, et al., 2025))中用于提升稳定性的几种简单技术:Z-loss、从嵌入中移除权重衰减,以及 QK-norm。
Z-loss
Z-loss (Chowdhery et al., 2022) 是一种正则化技术,通过在损失函数中添加惩罚项来防止最终输出 logit 过大。该正则化鼓励 logit 上 softmax 分母保持在合理范围内,有助于在训练期间保持数值稳定性:
在 1B 模型上的消融实验结果表明,添加 Z-loss 不会影响训练损失或下游性能。对于 SmolLM3,我们最终没有使用它,因为我们的 Z-loss 实现引入了一些在训练开始前尚未优化的训练开销。
从嵌入中移除权重衰减
权重衰减(weight decay)通常作为正则化技术应用于所有模型参数,但 OLMo et al. (2025) 发现,将嵌入层排除在权重衰减之外可以提升训练稳定性。原因是权重衰减会导致嵌入的范数(norm)在训练过程中逐渐减小,这可能导致早期层的梯度变大,因为层归一化(layer normalization)的 Jacobian 与输入范数成反比 (Takase et al., 2025)。
我们通过训练三种配置测试了这一方法:使用标准权重衰减的基准、不对嵌入使用权重衰减的变体,以及结合了所有已采用修改(不对嵌入使用权重衰减 + NoPE + 文档遮蔽)的第三种配置,以确保各技术之间没有负面交互。三种配置的损失曲线和评估结果几乎相同,因此我们在 SmolLM3 训练中采用了所有三项修改。
QK-norm
QK-norm (Dehghani et al., 2023) 在计算注意力之前对 query 和 key 向量都应用层归一化。这项技术有助于防止注意力 logit 变得过大,许多近期模型使用它来提升稳定性。
然而,@rnope 发现 QK-norm 会降低长上下文任务的性能。他们的分析揭示,QK-norm 导致相关 token(needle)上的注意力权重减少,无关上下文上的注意力权重增加。他们认为这是因为归一化操作去除了 query-key 点积中的量级信息,使注意力 logit 在量级上更接近。出于这个原因,我们没有在 SmolLM3 中使用 QK-norm。(此外,作为一个 3B 参数的小模型,与那些 QK-norm 证明最为有益的更大规模模型相比,它面临训练不稳定的风险也更小。)
其他注意事项
除了我们目前涵盖的组件之外,还有一些其他值得为完整性而提及的架构决策。
在参数初始化方面,现代模型通常使用截断正态初始化(truncated normal initialization,均值=0,标准差=0.02 或 0.006),或 μP (G. Yang & Hu, 2022) 等初始化方案(例如 Cohere 的 Command A (Cohere et al., 2025))。这也是可以进行消融实验的另一个话题。
在激活函数方面,SwiGLU 已成为现代 LLM 的事实标准(除了 Gemma 2 使用 GeGLU,以及 NVIDIA 使用 ReLU^2 (Nvidia et al., 2024; NVIDIA et al., 2025)),取代了 ReLU 或 GELU 等旧有选择。
从更宏观的层面来看,架构布局的选择也在塑造模型行为方面起着作用。虽然总参数量在很大程度上决定了语言模型的容量,但这些参数如何分布在深度和宽度上同样重要。@petty2024impactdepthcompositionalgeneralization 发现,在语言建模和组合泛化任务上,更深的模型优于同等规模但更宽的模型,直到收益趋于饱和。这种”深而窄”的策略在 MobileLLM 的消融实验 (Z. Liu et al., 2024) 中对十亿参数以下的 LLM 效果良好,而更宽的模型由于较高的并行性往往提供更快的推理速度。正如 Sebastian Raschka 在其 LLM 架构对比文章 中所指出的,现代架构以不同方式体现了这种权衡。
我们现在已经涵盖了密集 transformer(dense transformer)架构中值得针对训练运行进行优化的最重要方面。然而,最近还出现了其他一些关乎模型整体的架构干预,包括 MoE(专家混合)和混合模型。让我们来看看它们能提供什么,首先从 MoE 开始。
走向稀疏:MoE
专家混合模型(Mixture of Experts,MoE)的直觉是,我们不需要对每个 token 预测都使用完整模型,就像我们的大脑会根据任务激活不同区域一样(例如视觉皮层或运动皮层)。对于 LLM 来说,这可能意味着在模型执行翻译任务时,学习了编程语法的部分不需要被激活。如果能做到这一点,我们可以节省大量计算,因为这意味着在推理时我们只需运行完整模型的一部分。
从技术层面来说,MoE 有一个简单的目标:在不增加每个 token”激活”参数数量的前提下,扩大总参数量。简单来说,总参数量影响模型的整体学习容量,而激活参数量决定训练成本和推理速度。这就是为什么如今许多前沿系统(例如 DeepSeek-V3、Kimi K2,以及 Gemini、Grok 等闭源模型)都采用 MoE 架构。以下来自 Ling 1.5 论文 (L. Team et al., 2025) 的图表比较了 MoE 和密集模型的缩放规律(scaling laws)。
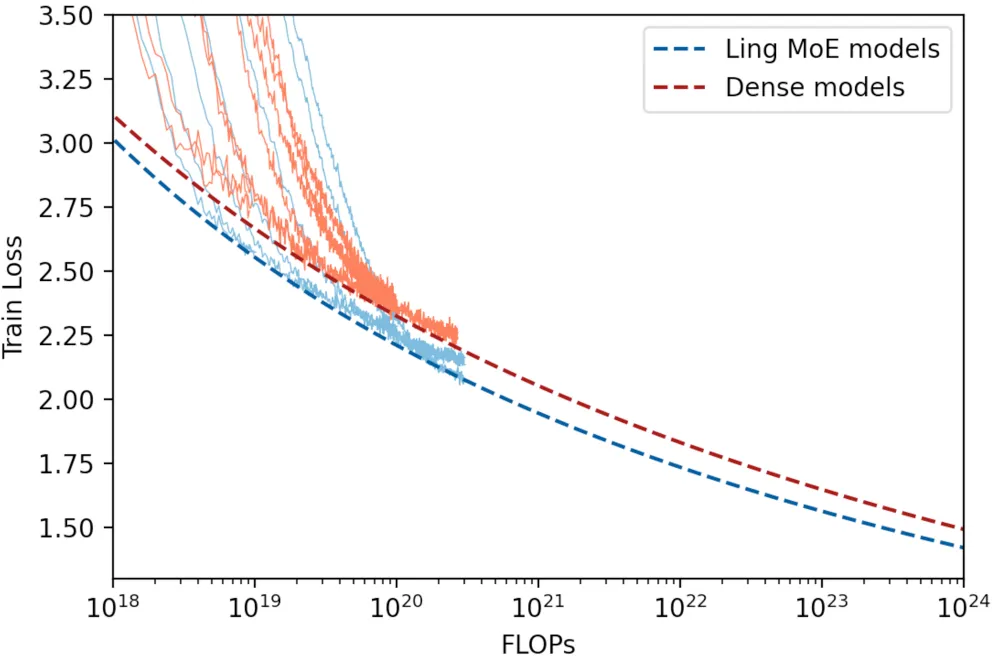
如果你是第一次接触 MoE,不用担心,其机制并不复杂。我们从标准密集架构出发,看看 MoE 需要做哪些改动(图示来自 Sebastian Raschka):

在 MoE 中,我们将单一的多层感知机(MLP,multilayer perceptron)替换为多个 MLP(“专家”),并在 MLP 之前添加一个可学习的路由器。对于每个 token,路由器选择一小部分专家来执行。这就是总参数量与激活参数量之间差异的来源:模型拥有许多专家,但任何给定的 token 只使用其中几个。
设计 MoE 层会引发几个核心问题:
- 专家形状与稀疏性: 应该使用许多小专家还是较少的大专家?每个 token 应激活多少个专家,总共需要多少个专家(即稀疏度或”top-k”)?是否应该有一些全局专家始终处于激活状态?
- 利用率与专业化: 如何选择路由的专家,并保持它们被充分使用(即避免空闲容量),同时还鼓励它们专业化?在实践中,这是一个负载均衡问题,对训练和推理效率有重大影响。
在这里,我们关注一个目标:在固定计算预算的情况下,如何选择一种能最小化损失的 MoE 配置?这与纯粹的系统效率(吞吐量/延迟)是不同的问题,我们稍后会回到这个问题。
本节的大部分内容遵循蚂蚁集团 MoE 缩放规律论文 (Tian et al., 2025) 中的分析。我们将使用他们的 效率杠杆(efficiency leverage,EL) 概念。简单来说,EL 衡量需要多少密集计算才能匹配某个 MoE 设计所达到的损失,计量单位是浮点运算次数(FLOPs)。更高的 EL 意味着与密集训练相比,该 MoE 配置在每单位计算量上带来了更多的损失改善。
让我们更仔细地了解如何设置 MoE 的稀疏性以提升效率杠杆。
稀疏性/激活比
TL;DR:稀疏性越高 → FLOPs 效率越好 → 在极高稀疏性时收益递减 → 最佳点取决于计算预算。
本节的目标是找出哪种 MoE 设置最好。从渐近的角度来看,很容易看出两种极端都不理想。一方面,始终激活所有专家使我们回到了所有参数都一直被使用的密集设置。另一方面,如果激活参数量极低(极端情况下,想象只有一个参数被激活),显然即使在狭窄的领域内也不足以解决任务。因此我们需要找到某个中间值。在深入寻找最优设置之前,定义两个量会很有用,即 激活比(activation ratio) 及其倒数 稀疏度(sparsity):
从计算角度来看,成本由激活参数量驱动。如果固定激活专家的数量(和大小),并增加专家总数,你的推理/训练 FLOPs 预算基本不变,但增加了模型容量,因此只要训练足够长,模型通常应该会更好。
如果调研近期的 MoE 论文,会发现一些有趣的经验性结论:固定激活专家的数量和大小,增加专家总数(即降低激活比/提高稀疏度)能改善损失,但一旦稀疏度变得非常高,收益开始递减。
请看以下图表:
- Kimi K2 的图表 (K. Team et al., 2025) 展示了两种效应:更高的稀疏度改善了性能,但随着稀疏度的增长,收益趋于平缓。
- 蚂蚁集团的图表 (Tian et al., 2025) 得出了相同的结论,并补充说明:更高稀疏度的 MoE 从增加计算量中获益更多。
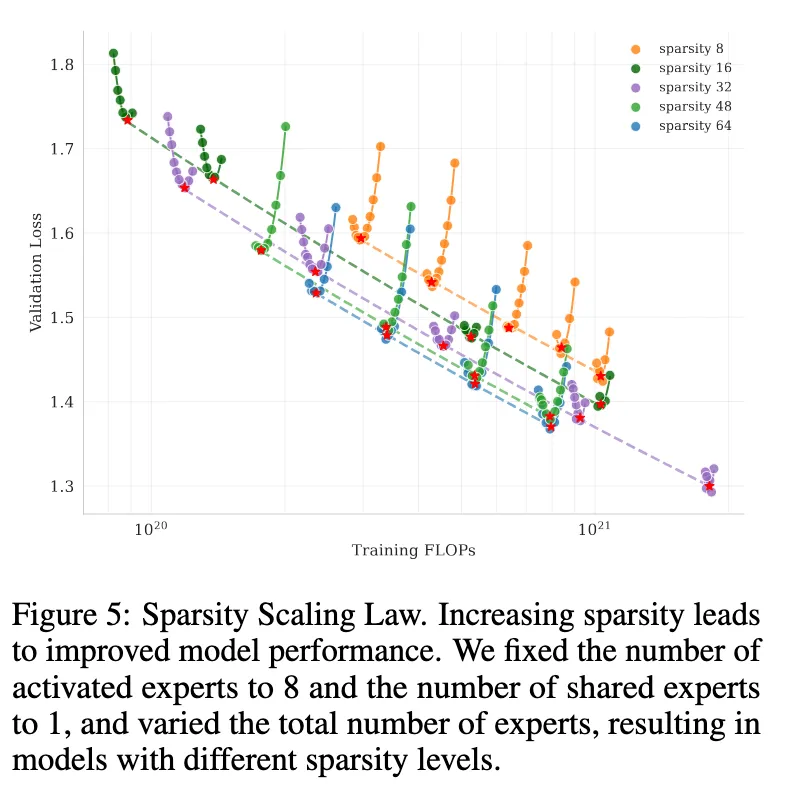
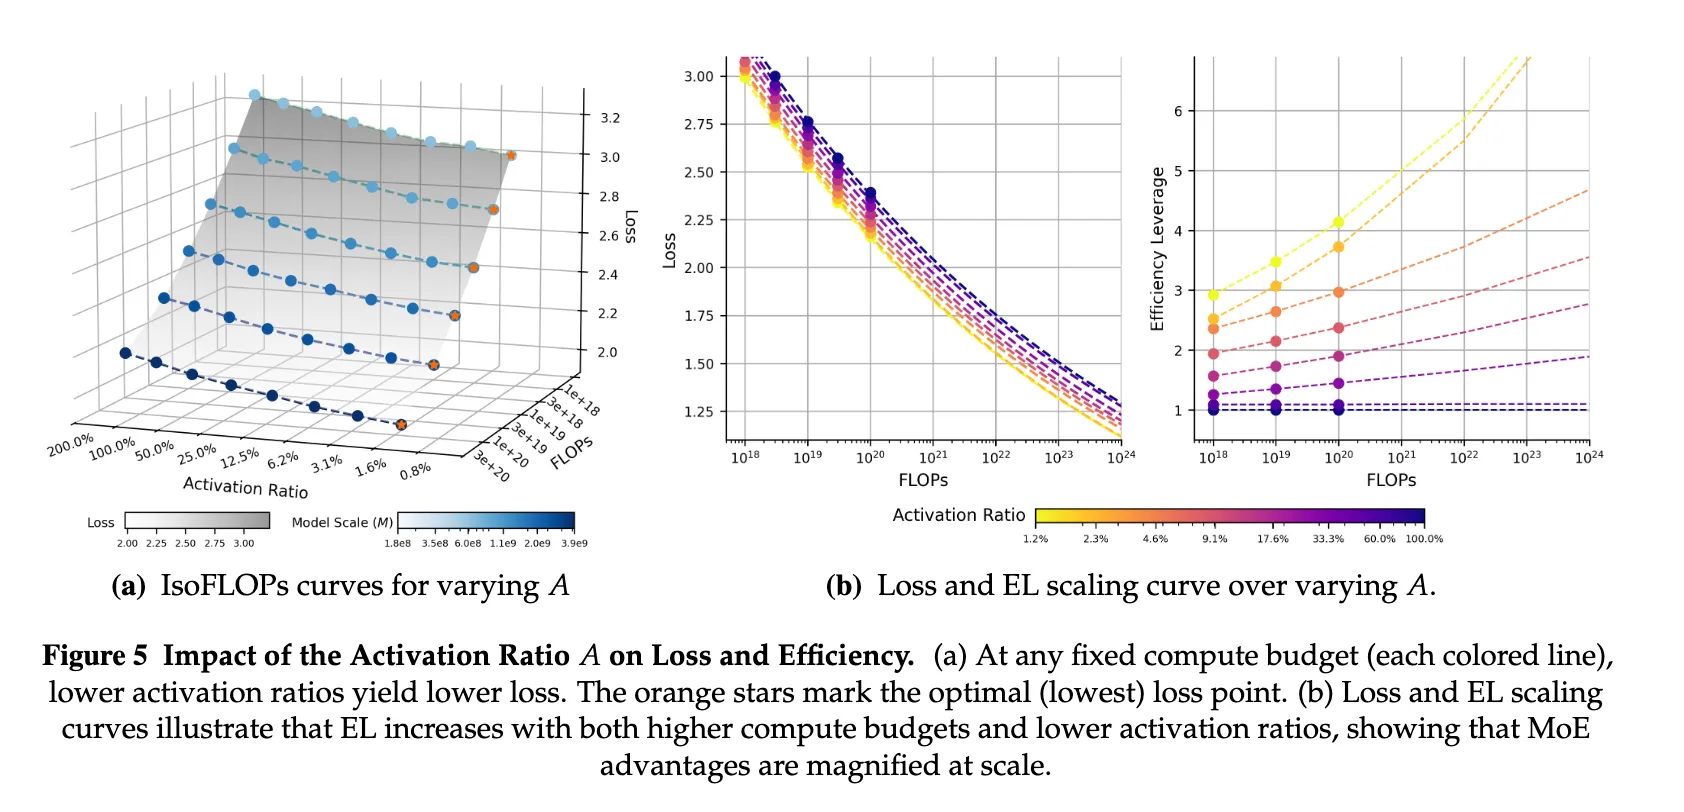
下表列出了一些 MoE 模型的稀疏度:
| 模型 | 专家总数 | 每 Token 激活数(含共享专家) | 稀疏度 |
|---|---|---|---|
| Mixtral-8×7B | 8 | 2 | 4.0 |
| Grok-1 | 8 | 2 | 4.0 |
| Grok-2 | 8 | 2 | 4.0 |
| OLMoE-1B-7B-0924 | 64 | 8 | 8.0 |
| gpt-oss 20b | 32 | 4 | 8 |
| Step-3 | 48 路由 + 1 共享 = 49 | 3 路由 + 1 共享 = 4 | 12.25 |
| GLM-4.5-Air | 128 路由 + 1 共享 = 129 | 8 路由 + 1 共享 = 9 | 14.3 |
| Qwen3-30B-A3B | 128 | 8 | 16.0 |
| Qwen3-235B-A22B | 128 | 8 | 16.0 |
| GLM-4.5 | 160 路由 + 1 共享 = 161 | 8 路由 + 1 共享 = 9 | 17.8 |
| DeepSeek-V2 | 160 路由 + 2 共享 = 162 | 6 路由 + 2 共享 = 8 | 20.25 |
| DeepSeek-V3 | 256 路由 + 1 共享 = 257 | 8 路由 + 1 共享 = 9 | 28.6 |
| gpt-oss 120b | 128 | 4 | 32 |
| Kimi K2 | 384 路由 + 1 共享 = 385 | 8 路由 + 1 共享 = 9 | 42.8 |
| Qwen3-Next-80B-A3B-Instruct | 512 路由 + 1 共享 = 513 | 10 总激活 + 1 共享 = 11 | 46.6 |
近期趋势非常明显:MoE 模型正变得越来越稀疏。尽管如此,最优稀疏度仍然取决于硬件和端到端效率。例如,Step-3 以峰值效率为目标,有意没有将稀疏度最大化,以适配特定的硬件和带宽约束,而 gpt-oss-20b 由于设备内存约束而具有较低的稀疏度(被动专家仍然占用一定内存)。
粒度(Granularity)
除了稀疏度,我们还需要决定每个专家的规模。这由 粒度 来衡量,这是蚂蚁集团引入的一个指标。让我们明确这个术语的含义,因为各论文的术语不尽相同,有些使用略微不同的公式。在这里,我们将使用与我们引用的图表相匹配的定义:
更高的粒度值对应于拥有更多更小维度的专家(在参数总量固定的情况下)。这个指标是专家维度()与模型维度()之间的比率。
在密集模型中,一个常用的经验法则是将 MLP 的维度设置为 。如果 (遵循 @krajewski2024scalinglawsfinegrainedmixture),可以大致将粒度理解为需要多少个专家才能匹配密集 MLP 的宽度()。
这种解释只是一个粗略的启发式方法:现代 MoE 设计通常分配的总容量远超单个密集 MLP,因此一一对应在实践中并不成立。蚂蚁集团团队选择了 ,这只是一种不同的归一化选择。为保持一致性,我们采用这一约定并沿用下去。
下表列出了近期部分 MoE 发布版本的不同取值:
| 模型 | 年份 | |||
|---|---|---|---|---|
| Mixtral-8x7B | 4,096 | 14,336 | 0.571 | 2023 |
| gpt-oss-120b | 2880 | 2880 | 2.0 | 2025 |
| gpt-oss-20b | 2880 | 2880 | 2.0 | 2025 |
| Grok 2 | 8,192 | 16,384 | 1.0 | 2024 |
| StepFun Step-3 | 7,168 | 5,120 | 2.8 | 2025 |
| OLMoE-1B-7B | 2,048 | 1,024 | 4.0 | 2025 |
| Qwen3-30B-A3B | 2,048 | 768 | 5.3 | 2025 |
| Qwen3-235B-A22B | 4,096 | 1,536 | 5.3 | 2025 |
| GLM-4.5-Air | 4,096 | 1,408 | 5.8 | 2025 |
| DeepSeek-V2 | 5,120 | 1,536 | 6.6 | 2024 |
| GLM-4.5 | 5,120 | 1,536 | 6.6 | 2025 |
| Kimi K2 | 7,168 | 2,048 | 7.0 | 2025 |
| DeepSeek-V3 | 7168 | 2048 | 7.0 | 2024 |
| Qwen3-Next-80B-A3B | 2048 | 512 | 8.0 | 2025 |
让我们来讨论粒度如何影响行为。来自蚂蚁集团论文:
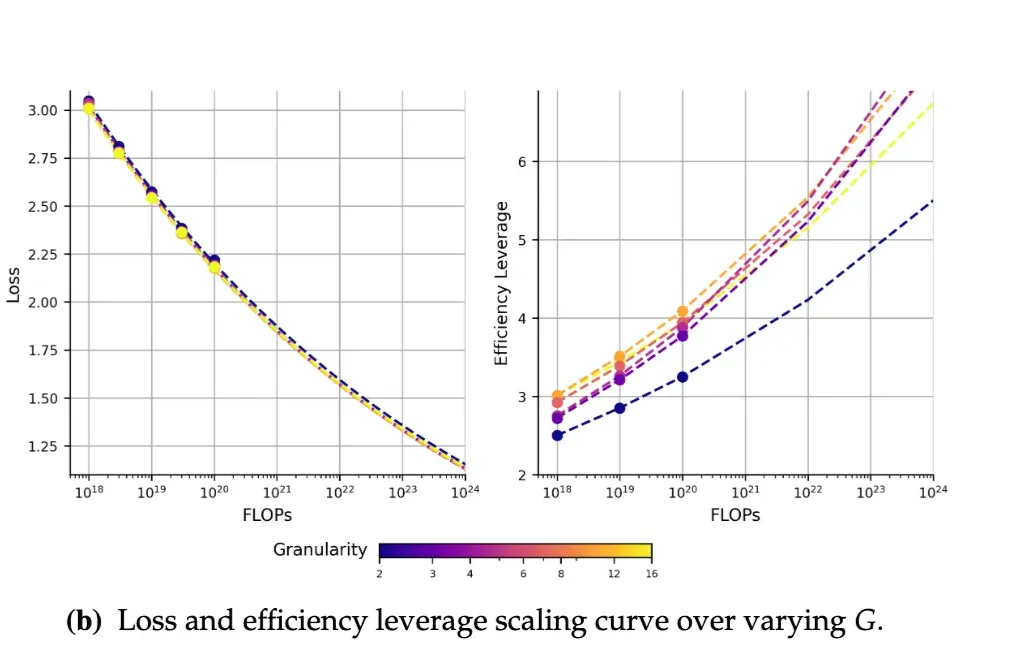
粒度看起来并不是 EL 的主要驱动因素——它有帮助,尤其是当取值超过 2 时,但它不是决定损失的主导因素。并且存在一个甜蜜点:提高粒度在某一点之前有帮助,之后收益趋于平缓。因此,粒度是一个有用的调整旋钮,在近期发布版本中明显趋向更高值,但不应孤立地对其进行优化。
另一种广泛用于改善 MoE 的方法是 共享专家(shared experts) 的概念。我们来看看!
共享专家
共享专家设置将每个 token 路由到一小组始终激活的专家。这些共享专家吸收数据中的基本、反复出现的模式,从而使其余专家能够更激进地专业化。在实践中,通常不需要太多共享专家;模型设计者通常选择一个,最多两个。随着粒度的增加(例如,从 Qwen3 风格的设置转移到更接近 Qwen3-Next 的设置),共享专家往往变得更有用。从 Tian et al. (2025) 的以下图表来看,总体影响是适度的;它不会显著改变 EL。一个简单的经验法则在大多数情况下效果良好:只使用一个共享专家。这与 DeepSeek-V3、Kimi K2 和 Qwen3-Next 等模型的选择一致,并且在不增加不必要复杂性的情况下倾向于最大化效率。
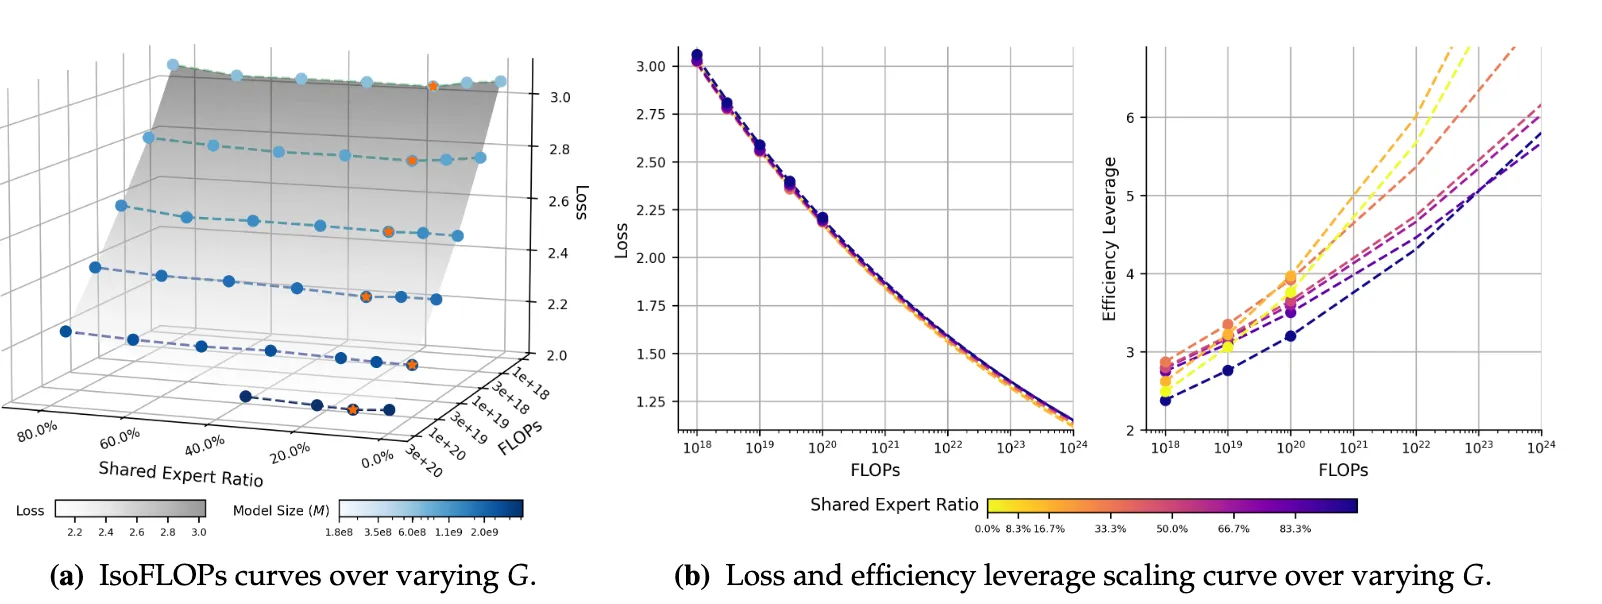
所以,共享专家是所有 token 都会被路由经过的专家。那其他的专家呢?我们如何学习何时路由到每个专家,并确保我们不会只使用少数几个专家而让其他专家闲置?接下来我们将讨论负载均衡(load balancing),这正是要解决的问题。
负载均衡
负载均衡是 MoE 中的关键部分。如果设置不当,它可能会削弱所有其他设计选择。为了理解为什么糟糕的负载均衡会给我们带来很多麻烦,设想一个非常简单的分布式训练设置:我们有四块 GPU,将模型的四个专家均匀分布在这些 GPU 上。如果路由崩溃,所有 token 都被路由到专家 1,这意味着只有四分之一的 GPU 被利用,对训练和推理效率来说非常糟糕。模型的有效学习容量也会下降,因为并非所有专家都被激活。
为了解决这个问题,我们可以在路由器中添加一个额外的损失项。下面是基于标准辅助损失的负载均衡:
这个简单的公式只使用三个因素:系数 决定损失的强度, 是流量分数(通过专家 的 token 比例), 是概率质量,即通过该专家的 token 概率之和。两者都是必要的: 对应实际的均衡效果,而 是平滑且可微的,允许梯度流动。
如果我们实现完美的负载均衡,则 。但我们需要谨慎调整 :如果太小,我们对路由的引导不足;如果太大,路由均匀性会比主要的语言模型损失更重要。
也可以在不使用显式损失项的情况下实现均衡。DeepSeek-V3 (DeepSeek-AI et al., 2025) 引入了一个简单的偏置项,将其添加到进入路由 softmax 的亲和力分数中。如果某个路由器过载,该分数会略微降低(降低一个常数因子 ),从而使其被选中的可能性降低;如果某个专家利用不足,则其分数会增加 。这个简单的自适应规则实现了负载均衡。
一个关键细节是计算路由统计数据的范围: 和 是按本地批次(每个 worker 的 mini-batch)还是全局(跨 worker/设备聚合)计算的?Qwen 团队的分析 (Qiu et al., 2025) 表明,当每个本地批次的 token 多样性不足时,本地计算会损害专家专业化(路由健康状况的良好代理)和整体模型性能。专家专业化是指一个或多个专家对特定领域的激活频率高于其他专家的现象。换言之,如果一个本地批次比较单一,其路由统计数据就会变得嘈杂/有偏差,无法实现良好的均衡。这意味着我们应该在可行的情况下使用全局统计数据(或至少进行跨设备聚合)。值得注意的是,在该论文发表时,许多框架——包括 Megatron——默认都是在本地计算这些统计数据。
以下来自 Qwen 论文的图表展示了 micro-batch(微批次)与全局批次聚合之间的差异及其对性能和专业化的影响:
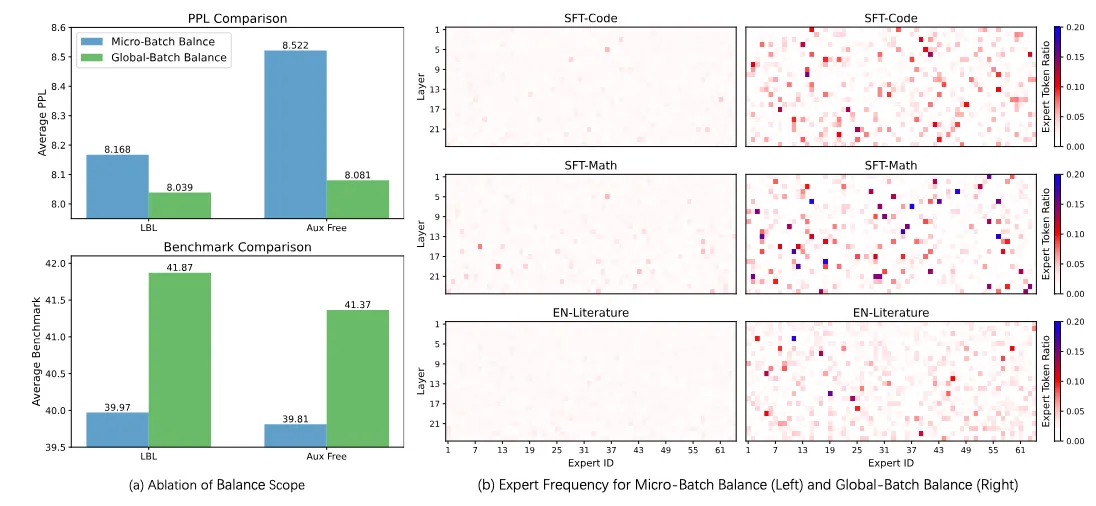
通常,围绕 MoE 的架构选择进行消融实验比较棘手,因为许多方面之间存在相互作用。例如,共享专家的有用性可能取决于模型的粒度。值得花时间确保你有一套好的实验方案,以真正获得你所寻求的洞察!
我们已经涵盖了 MoE 的基础知识,但还有更多值得探索的内容。以下是一份非详尽的可能值得研究的项目列表:
-
零计算专家、MoE 层重缩放和训练监控(LongCat-Flash 论文)
-
正交损失负载均衡(如 ERNIE 4.5)
-
在训练过程中对负载均衡系数进行调度
-
MoE 的架构/优化交互,例如:
- 优化器排名是否在 MoE 中改变
- 如何将 μP 应用于 MoE
- 如何为 MoE 调整学习率(因为专家每批次看到的 token 数量不同)
-
开头的密集层数量
我们将留给好奇的读者继续深入探索,同时我们继续讨论最后一个主要架构选择:混合模型!
扩展阅读:混合模型
近期的一个趋势是用状态空间模型(SSM,state space models)或线性注意力机制来增强标准的密集或 MoE 架构 (MiniMax et al., 2025; Zuo et al., 2025)。这类新型模型尝试解决 transformer 在高效处理超长上下文方面的一些根本性弱点。它们在循环模型(recurrent models)和 transformer 之间取得了中间平衡:循环模型能够以线性缩放处理任意长的上下文,但可能难以充分利用上下文中的模式;而 transformer 在长上下文时计算成本非常高,但能很好地利用上下文中的模式。
已有一些研究旨在理解 SSM 的优势与劣势。例如,@waleffe2024empiricalstudymambabasedlanguage 研究了 Mamba 模型(一种 SSM 形式),发现它们在许多基准上表现良好,但在 MMLU 和其他几个任务上表现不足。他们假设是缺乏上下文内学习(in-context learning)导致了这种差距。将 SSM 与密集或 MoE 模型的模块结合,可以兼得两者的优势,这也是 混合模型(hybrid models) 的名称由来。
这些线性注意力机制的核心思想是重新排列计算顺序,使注意力不再需要 的代价(这在长上下文时变得难以承受)。这是如何实现的?首先,回顾一下推理时的注意力公式。为 token 生成输出看起来是:
现在去掉 softmax:
重新排序得到:
我们定义运行状态(running state):
有简单的更新规则:
因此可以写成:
为什么重新排序很重要?左侧形式 意味着”对于每个过去的 token ,取点积 (一个标量),用它缩放 ,然后将这些 个向量相加”——这在步骤 时需要约 的工作量。右侧形式将其改写为 。你保持一个单一的运行状态矩阵 ,它已经汇总了所有过去的 。每个新 token 以一次外积 更新它,代价为 ;然后输出只需一次矩阵-向量乘法 (也是 )。因此,用左侧形式从头生成 个 token 的代价为 ,而维护 并使用右侧形式的代价为 。直观地说:左侧 = “每步进行许多小的点积缩放相加”;右侧 = “一个预汇总的矩阵乘以 query”,用对维度的依赖替换了对序列长度的依赖。我们这里关注的是推理和循环形式,但在训练中重新排序同样更高效,如以下公式所示:
这现在看起来非常像 RNN 式的结构。我们已经解决了问题,对吧?几乎。在实践中,softmax 发挥着重要的稳定作用,简单的线性注意力在没有某种归一化的情况下可能不稳定。为此,已经提出了一些实用的变体。
Lightning Attention
基于 NormAttention 的思想 (Qin et al., 2022)——用基于范数的缩放替换 softmax 归一化以控制注意力量级并提升稳定性——Lightning Attention 变体 专注于使实现快速高效,并包含了一些重要的架构改进。以下是各自的公式:
NormAttention:
Lightning Attention:
步骤 1:QKV 投影 + SiLU
步骤 2:衰减因子和( 在之前的记号中)
步骤 3:RMSNorm + 门控
根据 MiniMax et al. (2025) 的实测,带有 Lightning Attention 的混合模型在大多数任务上能匹配 softmax 注意力。
有趣的是,在 NIAH 等检索任务上,它的表现可以远远优于全 softmax 注意力,这可能表明 softmax 层和线性层之间存在某种协同效应。
令人惊讶的是,最近发布的 MiniMax-M2 并没有使用混合或线性注意力。根据该团队预训练负责人的说法,虽然早期 MiniMax-M1 在较小规模下使用 Lightning Attention 的实验在当时流行的基准(MMLU、BBH、MATH)上看起来很有希望,但他们发现在较大规模下”在复杂的多跳推理任务上存在明显的不足”。他们还将强化学习(RL)训练期间的数值精度问题和基础设施成熟度列为主要障碍,并得出结论:在大规模上设计新架构是一个多变量问题,由于对其他参数(数据分布、优化器等)的敏感性,难度大且计算密集。然而,他们承认”随着 GPU 算力增长放缓而数据长度持续增加,线性和稀疏注意力的优势将逐渐显现”。这既突出了架构消融实验的复杂性,也揭示了研究与生产现实之间的差距。
现在,让我们来看一些其他的注意力方法,并了解如何在一个统一的框架内理解它们。
高级线性注意力
循环模型给我们的一个有用启示是,让状态偶尔”放手”忘掉过去。在实践中,这意味着为前一个状态引入一个门控 :
几乎所有最近的线性注意力机制都有这个门控组件,只是对 的实现方式不同。以下是来自 Yang et al., 2024 的门控变体及其对应架构列表。
| 模型 | 参数化方式 | 可学习参数 |
|---|---|---|
| Mamba (A. Gu & Dao, 2024) | ||
| Mamba-2 (Dao & Gu, 2024) | ||
| mLSTM (Beck et al., 2025; H. Peng et al., 2021) | ||
| Gated Retention (Sun et al., 2024) | ||
| DFW (Mao, 2022; Pramanik et al., 2023) | ||
| GateLoop (Katsch, 2024) | ||
| HGRN-2 (Qin et al., 2024) | ||
| RWKV-6 (B. Peng et al., 2024) | ||
| Gated Linear Attention (GLA) (Yang et al., 2024) |
一个值得关注的变体是 Mamba-2 (Dao & Gu, 2024);它被用于多个混合模型,如 Nemotron-H (NVIDIA, :, Blakeman, et al., 2025)、Falcon H1 (Zuo et al., 2025) 和 Granite-4.0-h (IBM Research, 2025)。然而,目前还处于早期阶段,在扩展到大型混合模型时有重要的细微差别需要考虑。
虽然这些注意力机制展现出潜力,但 MiniMax 在 M2 上的经验表明,在小规模上的优势并不总能转化到大规模生产系统。尽管如此,混合模型发展迅速,仍然是前沿训练的可靠选择。Qwen3-Next(包含门控 DeltaNet 更新 (Qwen Team, 2025))报告称,其在长上下文推理速度更快、训练速度更快,且在标准基准上表现更好。我们也期待 Kimi 的下一个模型,它很可能会使用他们新的 Kimi Delta Attention。还应提及稀疏注意力(Sparse Attention),它通过仅对选定的块或查询计算注意力来解决长上下文缩放问题。一些例子包括 Native Sparse Attention (Yuan et al., 2025)、DeepSeek Sparse Attention (DeepSeek-AI, 2025) 和 InfLLM v2 (M. Team et al., 2025)。
现在你已经了解了架构选项,如何在它们之间做出选择?在讨论分词器之前,让我们先把这个问题解决掉。
用不用 MoE:选择基础架构
是否使用密集、MoE 还是混合模型,通常取决于几个核心因素:模型的部署位置、团队专业知识,以及你的时间线。让我们简要回顾每种选项的优缺点,并建立一个简单的决策树来做出选择。
密集 transformer(Dense transformers) 是标准的仅解码器 transformer 架构,每个 token 都会激活所有参数。参见 Harvard NLP 的博客文章 “The Annotated Transformer” 了解数学原理,以及 Jay Alammar 的 “The Illustrated Transformer” 建立直觉。
优点:广泛支持、理解透彻、训练稳定、每参数性能良好。
缺点:计算随规模线性扩展;70B 模型的成本约为 3B 的 23 倍。
这通常是内存受限场景或 LLM 训练新手的默认选择。
专家混合(Mixture of Experts,MoE) 模型将 transformer 中的前馈层替换为多个”专家”。一个门控网络将每个 token 路由到少数几个专家。结果是以一小部分计算量实现了大型网络的容量。例如,Kimi K2 拥有 1T 总参数,但每个 token 只有 32B 参数处于活跃状态。代价是所有专家都必须加载到内存中。关于直观理解,请参阅 Maarten Grootendorst 的博客文章。
优点:在训练和推理方面,每单位计算量的性能更好。
缺点:高内存需求(所有专家都必须加载)以及比密集 transformer 更复杂的训练。框架支持正在改善,但不如密集模型成熟,且分布式训练因专家放置、负载均衡和全对全通信(all-to-all communication)的挑战而更加复杂。
当你不受内存限制且希望在每单位计算量上获得最大性能时使用。
混合模型(Hybrid models) 将 transformer 与 Mamba 等状态空间模型结合,为某些操作提供线性复杂度,而非注意力的二次方扩展。这里有一些有用的资源:Sasha Rush 的博客文章以及 Maarten Grootendorst 关于 Mamba 和 SSM 的直观指南。
优点:潜在的更好长上下文处理能力,对超长序列更高效。
缺点:比密集和 MoE 架构更不成熟,经过验证的训练方案更少。框架支持有限。
如果你希望扩展到非常大的上下文,同时减少标准 transformer 的推理开销,则使用此方案。
要做出决定,首先要问模型将部署在哪里。然后考虑团队的专业知识和训练时间线,评估你能承担多少探索。
对于 SmolLM3,我们希望构建一个用于设备端部署的强大小型模型,时间线大约为三个月,且过去我们主要训练密集模型。这排除了 MoE(内存限制)和混合架构(探索时间线短,密集模型足以支持 128k tokens 的目标上下文长度),因此我们选择了密集的 Llama 风格模型。
有了模型架构,现在让我们将注意力转向分词器(tokenizer),它是数据与模型之间的桥梁。
分词器(Tokenizer)
分词方案很可能是任何语言模型中最被低估的组件之一。可以把它看作人类语言与模型所处的数学世界之间的翻译器。尽管架构创新往往占据聚光灯,但就像任何翻译器一样,翻译质量很重要。那么,我们如何为自己的需求构建或选择正确的分词器?
分词器基础
从本质上说,分词器通过将连续文本分割成称为 token(词元)的独立可处理单元,将原始文本转换为模型可以处理的数字序列。在深入技术细节之前,我们应该首先回答一些将指导分词器设计的基本问题:
- 我们希望支持哪些语言? 如果我们正在构建一个多语言模型,但分词器只见过英语,那么当模型遇到非英语文本时效率会很低,非英语文本将被分割成比必要情况多得多的 token。这直接影响性能、训练成本和推理速度。
- 哪些领域对我们重要? 除语言外,数学和代码等领域需要仔细表示数字。
- 我们的目标数据混合是什么? 如果我们计划从头开始训练分词器,理想情况下应该在能反映最终训练混合的样本上进行训练。
一旦回答了这些问题,我们就可以审视主要的设计决策。
词汇量大小(Vocabulary Size)
词汇表(vocabulary)本质上是一个字典,列出我们的模型能识别的所有 token(最小文本单位,如单词、子词或符号)。
较大的词汇表通常能更高效地压缩文本,因为每个句子生成的 token 更少,但存在计算权衡:词汇量大小直接影响嵌入矩阵的大小。如果词汇量为 V,隐藏维度为 h,则输入嵌入有 V × h 个参数,输出层还有另外 V × h 个参数。对于较小的模型,这可能占总参数量的相当大比例(正如我们在”嵌入共享”部分看到的那样),但随着模型规模增大,相对成本会缩小。
最佳点取决于目标覆盖范围和模型规模。对于纯英语模型,约 50k tokens 通常就足够了,但多语言模型通常需要 100k+ 才能高效处理各种书写系统和语言。Llama 3 等现代最先进模型已采用 128k+ 范围的词汇表,以提高跨语言的 token 效率。同一系列中较小的模型通过嵌入共享来降低嵌入参数比例,同时仍能受益于更大的词汇表。
Dagan et al. (2024) 分析了词汇量大小对压缩、推理和内存的影响。他们观察到,更大词汇表带来的压缩收益呈指数递减,这表明存在一个最优大小。对于推理,较大的模型受益于更大的词汇表,因为压缩节省的前向传递成本超过了额外嵌入 token 在 softmax 中的代价。对于内存,最优大小取决于序列长度和批大小:由于 KV 缓存节省,较长的上下文和大批次受益于更大的词汇表。
分词算法
既然我们已经了解了定义分词器的关键参数,我们面临一个实际决策:应该使用现有的分词器还是从头开始训练一个?答案取决于覆盖范围,即现有分词器是否能以我们目标词汇量大小很好地处理我们的语言和领域。
在现有分词器中,字节对编码(BPE,Byte-Pair Encoding)(Sennrich et al., 2016) 仍然是最流行的选择。还有其他算法,如 WordPiece 和 SentencePiece,但它们的采用率较低。(还有越来越多的研究兴趣集中在无分词器方法上,这些方法直接处理字节或字符,可能完全消除分词步骤。)
关于覆盖范围的问题,请看下图,它比较了 GPT-2 的纯英语 BPE 分词器 (Radford et al., 2019) 和 Gemma 3 的多语言 SentencePiece 分词器 (G. Team et al., 2025) 如何分割相同的英语和阿拉伯语句子。
虽然两个分词器在英语上的表现似乎相近,但对于阿拉伯语,差异变得非常显著:GPT-2 将文本分割成一百多个片段,而 Gemma 3 由于其多语言训练数据和更大、更具包容性的词汇表,生成的 token 要少得多。
但要评估分词器的质量,我们不能只看几个分词示例就下结论,就像我们不能在没有运行消融实验的情况下凭直觉进行架构更改一样。我们需要具体的指标。
衡量分词器质量
为了评估分词器的性能,我们可以使用 FineWeb2 (Penedo et al., 2025) 中采用的两个关键指标:
- 生育率(Fertility) 衡量编码一个单词平均需要多少 token(词对 token 的比率)。较低的生育率意味着更好的压缩,从而转化为更快的训练和推理速度。
- 续词比例(Proportion of continued words) 告诉我们有多少百分比的单词被分割成多个部分。百分比越低越好,因为这意味着更少的单词被碎片化,从而实现更高效的分词。
生育率指标围绕”词”的概念定义,因为在合适的分词工具可用时(例如 Spacy 或 Stanza),它提供了有意义的跨语言比较 (Penedo et al., 2025)。对于单一语言内的分词器比较,可以使用字符数或字节数代替词数,得到字符对 token 比率或字节对 token 比率 (Dagan et al., 2024)。然而,这些指标在跨语言比较中有局限性。字节可能有偏差,因为不同脚本的字符需要不同的字节表示(例如,中文字符在 UTF-8 中使用 3 字节,而拉丁字符使用 1 或 2 字节)。类似地,使用字符数没有考虑到跨语言单词长度差异很大的事实。例如,中文词通常比德语合成词短得多。
我们可以如下实现这些指标:
import numpy as np

def compute_tokenizer_metrics(tokenizer, word_tokenizer, text):
    """
    Computes fertility and proportion of continued words.

    Returns:
        tuple: (fertility, proportion_continued_words)
            - fertility: average tokens per word (lower is better)
            - proportion_continued_words: percentage of words split into 2+ tokens (lower is better)

    """
    words = word_tokenizer.word_tokenize(text)
    tokens = tokenizer.batch_encode_plus(words, add_special_tokens=False)
    tokens_per_word = np.array(list(map(len, tokens["input_ids"])))

    fertility = np.mean(tokens_per_word).item()
    proportion_continued_words = (tokens_per_word >= 2).sum() / len(tokens_per_word)

    return fertility, proportion_continued_words
但对于代码和数学等专业领域,除了生育率之外,我们还需要深入了解分词器如何处理特定领域的模式。大多数现代分词器使用单个数字分割,因此 “123” 变成 [“1”, “2”, “3”] (Chowdhery et al., 2022; DeepSeek-AI et al., 2024)。将数字拆开看起来可能有些反直觉,但实际上它有助于模型更有效地学习算术模式。如果 “342792” 被编码为一个不可分割的 token,模型必须记忆当该特定 token 与每个其他数字 token 进行加、减或乘法运算时会发生什么,但当它被拆分后,模型就能学习数字级别的运算规律。一些分词器,如 Llama 3 的 (Grattafiori et al., 2024),将 1 到 999 的数字编码为唯一 token,其余数字由这些 token 组合而成。
评估分词器
为了跨不同语言比较分词器,我们将使用 FineWeb2 分词器分析 (Penedo et al., 2025) 中的设置,以维基百科文章作为评估语料库。对于每种语言,我们将抽样 100 篇文章以获得有意义的样本,同时保持计算量可管理。
首先,让我们安装依赖项并定义要比较的分词器和语言:
pip install transformers datasets sentencepiece 'datatrove[multilingual]'
## we need datatrove to load word tokenizers
tokenizers = [
    ("Llama3", "meta-llama/Llama-3.2-1B"),
    ("Gemma3", "google/gemma-3-1b-pt"),
    ("Mistral (S)", "mistralai/Mistral-Small-24B-Instruct-2501"),
    ("Qwen3", "Qwen/Qwen3-4B")
]

languages = [
    ("English", "eng_Latn", "en"),
    ("Chinese", "cmn_Hani", "zh"),
    ("French", "fra_Latn", "fr"),
    ("Arabic", "arb_Arab", "ar"),
]
现在让我们加载维基百科样本。我们使用流式传输以避免下载整个数据集:
from datasets import load_dataset

wikis = {}
for lang_name, lang_code, short_lang_code in languages:
	wiki_ds = load_dataset("wikimedia/wikipedia", f"20231101.{short_lang_code}", streaming=True, split="train")
	wiki_ds = wiki_ds.shuffle(seed=42, buffer_size=10_000)
	# Sample 100 articles per language
  ds_iter = iter(wiki_ds)
  wikis[lang_code] = "\n".join([next(ds_iter)["text"] for _ in range(100)])
数据准备好后,我们可以对每种分词器和语言组合进行评估。对于每种组合,我们从 DataTrove 加载相应的词语分词器并计算两个指标:
from transformers import AutoTokenizer
from datatrove.utils.word_tokenizers import load_word_tokenizer
import pandas as pd

results = []

for tokenizer_name, tokenizer_path in tokenizers:
    tokenizer = AutoTokenizer.from_pretrained(tokenizer_path, trust_remote_code=True)

    for lang_name, lang_code, short_lang_code in languages:
        word_tokenizer = load_word_tokenizer(lang_code)

        # Compute metrics on Wikipedia
        fertility, pcw = compute_tokenizer_metrics(tokenizer, word_tokenizer, wikis[lang_code])

        results.append({
            "tokenizer": tokenizer_name,
            "language": lang_name,
            "fertility": fertility,
            "pcw": pcw
        })

df = pd.DataFrame(results)
print(df)
      tokenizer    language  fertility       pcw
0        Llama3     English   1.481715  0.322058
1        Llama3     Chinese   1.601615  0.425918
2        Llama3      French   1.728040  0.482036
3        Llama3     Spanish   1.721480  0.463431
4        Llama3  Portuguese   1.865398  0.491938
5        Llama3     Italian   1.811955  0.541326
6        Llama3      Arabic   2.349994  0.718284
7        Gemma3     English   1.412533  0.260423
8        Gemma3     Chinese   1.470705  0.330617
9        Gemma3      French   1.562824  0.399101
10       Gemma3     Spanish   1.586070  0.407092
11       Gemma3  Portuguese   1.905458  0.460791
12       Gemma3     Italian   1.696459  0.484186
13       Gemma3      Arabic   2.253702  0.700607
14  Mistral (S)     English   1.590875  0.367867
15  Mistral (S)     Chinese   1.782379  0.471219
16  Mistral (S)      French   1.686307  0.465154
17  Mistral (S)     Spanish   1.702656  0.456864
18  Mistral (S)  Portuguese   2.013821  0.496445
19  Mistral (S)     Italian   1.816314  0.534061
20  Mistral (S)      Arabic   2.148934  0.659853
21        Qwen3     English   1.543511  0.328073
22        Qwen3     Chinese   1.454369  0.307489
23        Qwen3      French   1.749418  0.477866
24        Qwen3     Spanish   1.757938  0.468954
25        Qwen3  Portuguese   2.064296  0.500651
26        Qwen3     Italian   1.883456  0.549402
27        Qwen3      Arabic   2.255253  0.660318
结果揭示了一些赢家和权衡,具体取决于你的优先级。
Gemma 3 的分词器在多种语言上实现了较低的生育率和单词分割率——尤其在英语、法语和西班牙语上——这可以通过其多语言训练数据和非常大的词汇量(262k tokens,约为 Llama 3 的 128k 的两倍)来解释。Qwen3 的分词器在中文上表现出色,但在英语、法语和西班牙语上落后于 Llama 3。Mistral Small 的分词器 (Mistral AI, 2025) 在阿拉伯语上表现最好,但在英语和中文上落后于其他分词器。
在现有分词器和自定义分词器之间选择
目前,有很好的一批强大分词器可供选择。许多近期模型从 GPT-4 的分词器 (OpenAI et al., 2024) 开始,并添加额外的多语言 token 来增强它。Llama 3 的分词器在多语言文本和代码方面的平均表现良好,而 Qwen2.5 的分词器在中文和一些低资源语言上表现特别出色。如何决定是使用现有选项还是训练自己的?以下是一些帮助你选择的指南:
- 何时使用现有分词器: 如果你的目标用例与上面比较的分词器的语言或领域覆盖相匹配,这些都是经过充分验证的可靠选择。对于 SmolLM3 训练,我们选择了 Llama 3 的分词器:它在我们目标语言(英语、法语、西班牙语、葡萄牙语、德语和意大利语)上提供了具有竞争力的分词质量,词汇量为 128k,这对于我们的小模型规模来说是合理的——足够大以实现多语言效率,但又不至于大到用嵌入权重使我们的 3B 参数量膨胀。对于嵌入参数占总参数比例较小的更大模型,Gemma3 的效率优势会变得更具吸引力。
- 何时训练自己的分词器: 如果你正在为低资源语言训练,或者有独特的数据混合,你很可能需要训练自己的分词器以确保良好的覆盖范围。在这种情况下,重要的是在你认为最终训练混合会是什么样子的数据集上训练分词器。这造成了一个有些鸡生蛋蛋生鸡的问题,因为你需要分词器来运行数据消融实验并找到合适的混合,但你可以在启动最终运行之前重新训练分词器,并验证下游性能是否有所提升,以及生育率是否仍然良好。
你对分词器的选择可能看起来像是一个技术细节,但它会影响模型性能的方方面面。不要害怕在这上面投入时间,把它做好。
SmolLM3
现在我们已经探索了架构领域并运行了一些消融实验,让我们看看这一切如何在 SmolLM3 这样的模型中实践结合起来。
SmolLM 系列旨在突破小型模型的可能边界。SmolLM2 在 135M、360M 和 1.7B 参数下提供了三个能力出色的模型,均被设计为能在设备端高效运行。对于 SmolLM3,我们希望在保持小到足以在手机上运行的同时提升性能,并解决 SmolLM2 的薄弱环节:多语言能力、超长上下文处理和强大的推理能力。我们选择 3B 参数作为这种平衡的最佳点。
由于我们是在扩展一个经过验证的方案,我们自然而然地倾向于密集 transformer。Nanotron 中尚未实现 MoE,而且我们已经具备训练强大小型密集模型的专业知识和基础设施。更重要的是,对于边缘设备部署,我们受内存限制;即使只有少数参数处于激活状态,拥有许多参数的 MoE 仍然需要将所有专家加载到内存中,这使得密集模型成为更实际的选择。
我们以 SmolLM2 1.7B 的架构作为基础,然后使用 Qwen2.5-3B 的布局在 100B tokens 上训练了一个 3B 消融模型。这为我们提供了一个坚实的基准,以单独测试每项修改。每项架构更改都需要在英语基准上改善损失和下游性能,或者在不降低质量的情况下提供可量化的好处(如推理速度)。
以下是我们在启动最终通过验证的运行之前测试的内容:
- 分词器: 在深入架构修改之前,我们需要选择一个分词器。我们找到了一批涵盖我们目标语言和领域的优质候选分词器。基于我们的生育率分析,Llama 3.2 的分词器为我们在六种目标语言上的性能提供了最佳权衡,同时将词汇量保持在 128k——足够大以实现多语言效率,但不至于用嵌入权重使我们的 3B 参数量膨胀。
- 分组查询注意力(GQA): 我们重新确认了早期发现:4 组 GQA 的性能与 MHA 相当,但这次是在 3B 规模上使用 100B tokens 进行验证的。KV 缓存效率的提升实在诱人,尤其是对于内存宝贵的设备端部署。
- NoPE 用于长上下文: 我们实现了混合位置编码方案,每四层应用一次 NoPE,其余层使用 RoPE。我们的 3B 消融实验确认了之前的发现:NoPE 在不牺牲短上下文性能的情况下改善了长上下文处理能力。
- 文档内注意力遮蔽: 我们在非常长的序列上训练时防止了跨文档注意力,以帮助提升训练速度和稳定性。我们再次发现这不影响下游性能。
- 模型布局优化: 我们比较了文献中近期 3B 模型的布局,有些优先考虑深度,有些优先考虑宽度。我们在训练设置上测试了 Qwen2.5-3B(3.1B)、Llama 3.2-3B(3.2B)和 Falcon3-H1-3B(3.1B)的布局,其中深度和宽度有所不同。结果很有趣:尽管 Qwen2.5-3B 实际上参数量更少,但所有布局的损失和下游性能几乎相同。然而,Qwen2.5-3B 更深的架构与研究表明网络深度有益于泛化的结论一致 (Petty et al., 2024)。因此,我们选择了更深的布局,押注它随着训练的进行会有所帮助。
- 稳定性改进: 我们保留了 SmolLM2 中的参数绑定嵌入,但增加了一个受 OLMo 2 启发的新技巧:从嵌入中移除权重衰减。我们的消融实验表明这不会损害性能,同时降低了嵌入范数,有助于防止训练发散。
系统性消融实验方法的优点在于,我们可以自信地组合所有这些修改,因为每一项都已单独得到验证。
在实践中,我们逐步测试变更:一旦某个特性被验证,它就成为测试下一个特性的基准的一部分。测试顺序很重要。从经过充分验证的特性开始(参数绑定嵌入 → GQA → 文档遮蔽 → NoPE → 移除权重衰减)。
参与规则
TL;DR:你的用例驱动你的选择。
让部署目标指导架构决策。 在评估新的架构创新时,考虑你的模型将如何以及在哪里实际运行。
在创新与务实之间取得正确平衡。 我们不能忽视重大架构进步——在存在更好替代方案(如 GQA)的情况下使用 MHA 将是一个糟糕的技术选择。保持对最新研究的了解,并采用那些提供清晰、经过验证的规模效益的技术。但要抵制追逐每一篇承诺边际收益的新论文的诱惑(除非你有资源这样做,或者你的目标是架构研究)。
系统性胜过直觉性。 验证每一项架构变更,无论它在纸面上看起来多么有前途。在组合之前单独测试修改,以了解它们的影响。
规模效应是真实的——在可能的情况下,在目标规模上重新进行消融实验。 不要假设你的小规模消融实验将在目标模型规模上完美保持。如果你有计算资源,请尝试重新确认它们。
在你实际的领域上验证分词器效率。 跨目标语言和领域的生育率指标比追随最新模型的做法更重要。如果你不覆盖那么多语言,50k 的英语分词器无法胜任认真的多语言工作,但你也不需要 256k 的词汇表。
现在模型架构已经确定,是时候处理将驱动学习过程的优化器和超参数了。
优化器与训练超参数
各项准备工作正在就绪。我们已完成消融实验、确定了模型架构并选定了 tokenizer(分词器)。但在真正启动训练之前,还有一些关键决策需要做出:该使用哪种优化器(optimizer)?学习率(learning rate)和批量大小(batch size)应设为多少?训练过程中学习率应如何调度?
这里的诱人做法是直接借用文献中某个强大模型的参数值。毕竟,对大型实验室有效的配置,对我们应该同样有效,对吧?在许多情况下,如果我们参考的是规模和架构相近的模型,这种方法确实可行。
然而,不针对我们的具体设置调优这些参数,就有可能白白损失性能。文献中报告的超参数是针对特定数据和约束条件优化得到的,而这些约束条件有时甚至与性能无关——也许学习率是在早期开发阶段确定后就再也没有重新审视过的。即便模型作者做了充分的超参数搜索,那些最优值也是针对他们自己的架构、数据和训练机制的特定组合找到的,而不是针对我们的。文献中的参数始终是一个很好的起点,但是否能在其附近找到更优的值,还是值得探索的。
在本节中,我们将研究最新的优化器(并看看值得信赖的老牌 AdamW (Kingma, 2014) 是否仍然经受住了时间的考验),深入探讨超越标准 cosine decay(余弦衰减)的学习率调度策略,并弄清楚在给定模型和数据规模的情况下,应如何调优学习率和批量大小。
让我们从优化器之争开始。
优化器:AdamW 及其他
优化器是整个大语言模型训练操作的核心。它根据历史更新、当前权重以及从损失中计算出的梯度,决定每个参数的实际更新步骤。与此同时,它也是一头内存和算力的消耗大户,因此会影响所需 GPU 数量和训练速度。
我们不遗余力地总结了当前用于大语言模型预训练的优化器格局:
| 模型 | 优化器 |
|---|---|
| Kimi K2, GLM 4.5 | Muon |
| 其他所有模型 | AdamW |
您可能会好奇,为什么大家都在使用 AdamW?
撰写本指南这部分内容的作者认为,这是因为”人们太懒了”(你好,我是 Elie),但其他人可能更现实地说,AdamW 在不同规模下长期以来表现良好/优于竞争对手,而改变如此核心的组件总是令人有些担忧——尤其是当测试其在超长训练运行中的表现既困难(即昂贵)时。
此外,公平地比较优化器比看起来更难。规模的变化会以难以在小型消融实验中模拟的方式改变动态,因此超参数调优十分复杂。您可能会说:“没关系,我已经花了好几周调优 AdamW,我可以直接复用相同的超参数进行比较!“我们多希望这是真的。但遗憾的是,对于每种优化器,您都需要进行合理的超参数搜索(1D?2D?3D?),这使得优化器研究既困难又昂贵。
那么,让我们从这个经典优化器开始——它也是 Durk Kingma 令人生畏的 Google Scholar 统治地位的基石:AdamW。
AdamW
Adam(自适应动量估计,Adaptive Momentum Estimation)是一种一阶优化技术,这意味着它只使用梯度。它通过从历史梯度中导出的动量(momentum)来为每个参数自适应地调整学习率。
细心的读者可能会问:等等,你难道少写了一个 W 吗?确实!我们特别加上 W(weight decay,权重衰减),因为在标准随机梯度下降(SGD)中,我们可以简单地在损失函数中加入 (其中 是权重)来应用 L2 正则化,但如果对 Adam 也这样做,自适应学习率同样会影响 L2 正则化。这意味着正则化强度会依赖于梯度幅度,从而削弱其效果。这不是我们想要的;AdamW 通过将权重衰减从主优化循环中解耦来修复这一问题。
有趣的是,过去几年来 AdamW 的超参数几乎没有变化:
- β₁ = 0.9, β₂ = 0.95
- 梯度范数裁剪(Grad norm clipping)= 1.0
- 权重衰减(Weight decay)= 0.1(Llama 3 405B 将其降至 0.01)
同样的三元组在 Llama 1、2、3 以及 DeepSeek-V1、V2、V3-671B 中被重复使用,没有任何变化。Durk Kingma 从一开始就是对的,还是我们可以做得更好?
Muon 一句话介绍
Adam 是一种一阶方法,因为它只使用梯度。Muon 是一种二阶优化器,作用于参数张量的矩阵视图:
看到这些方程,您可能会疑惑:这怎么是二阶方法——我只看到梯度,没有高阶项!二阶优化实际上发生在 Newton Schulz 步骤内部,我们在此不作进一步展开。有大量高质量的资源对 Muon 进行了深入解释,我们将只介绍三个关键思想:
- 矩阵级几何 vs. 参数级更新: AdamW 对每个参数进行预条件处理(对角二阶矩)。Muon 将每个权重矩阵视为一个整体对象,并沿 方向进行更新,从而捕捉行/列子空间结构。
- 通过正交化实现各向同性步长: 利用奇异值分解(SVD)将 分解,可以将幅度()与方向(左/右子空间 )分离。用 替换 会丢弃奇异值,使步长在活跃子空间中各向同性。这乍看起来有些反直觉,因为丢弃 似乎是在丢失信息,但它减少了轴对齐偏差,并鼓励探索那些本来会被极小奇异值所抑制的方向。这种探索方式是否会在模型中积累出仅凭损失值并不明显的不同能力,目前仍是一个开放问题。
- 对更大批量大小的经验性容忍度: 实践中,Muon 通常能容忍更大的批量大小。我们将在批量大小部分详细讨论这一点,但这可能是 Muon 被采用的一个关键动机!
多年来,社区大多沿用 AdamW,而前沿实验室的优化器方案通常保密(例如 Qwen 从不公开他们的方案),但最近 Muon 已在高知名度发布中得到采用(例如 Kimi K2 和 GLM-4.5)。希望未来我们能看到更多开放且可靠的使用方案。
优化器领域犹如一座野生动物园,研究人员在将各种动量与导数结合方面的创造力,丝毫不逊于他们为这些方法取名的才能:Shampoo、SOAP、PSGD、CASPR、DION、Sophia、Lion……甚至 AdamW 本身也有变体,如 NAdamW、StableAdamW 等。深入探讨所有这些优化器值得单独写一本指南,但我们将留待他日。与此同时,我们强烈推荐 Stanford Marin 团队的精彩论文 (Wen et al., 2025),他们对许多不同的优化器进行了基准测试,以展示在进行比较时超参数调优的重要性。
与几乎每种优化器选择密切相关的一个问题是权重更新的强度应有多大。这由学习率决定,学习率通常在优化器方程中以一个标量的形式出现。这看似是个简单的话题,但正如您将在下一节中看到的,它有许多方面。
学习率
学习率(LR)是我们必须设定的最重要超参数之一。在每个训练步骤中,它控制着我们根据计算出的梯度对模型权重进行多大程度的调整。学习率过低会使训练慢得令人痛苦,并有陷入糟糕局部极小值的风险。损失曲线会看起来一片平坦,我们的计算预算将被消耗殆尽却没有实质性进展。另一方面,学习率设置过高会导致优化器迈出巨大步伐,越过最优解而无法收敛(或者发生难以想象的事情:损失发散并直冲云霄)。
但最佳学习率甚至不是恒定的,因为训练动态会在过程中发生变化。高学习率在早期、距良好解较远时效果好,但在收敛附近会引发不稳定。这正是学习率调度(learning rate schedule)发挥作用的地方:从零开始预热以避免早期混乱,然后衰减以稳定到一个好的极小值。这些模式(例如预热 + 余弦衰减)多年来已在神经网络训练中得到验证。
大多数现代大语言模型使用固定数量的预热步数(例如 2,000 步),与模型大小和训练时长无关,如”架构选择”部分开头的表格所示。对于非常短的训练运行,使用 1–5% 的训练步数作为预热步数很常见。对于更长的训练运行,我们发现增加预热步数通常不会影响性能。
让我们来看一些常见的调度策略,然后讨论如何选取峰值。
学习率调度:超越余弦衰减
多年前人们就已知道,改变学习率有助于收敛 (Smith & Topin, 2018),而长期以来余弦衰减 (Loshchilov & Hutter, 2017) 一直是训练大语言模型的首选调度策略:在预热后从峰值学习率开始,然后沿余弦曲线平滑地降低。这种方法简单且效果良好。其主要缺点是缺乏灵活性;我们需要预先知道要训练多少步,因为余弦周期长度必须与总训练时长相匹配。这在几种常见场景中会成为问题,例如:模型尚未收敛时您获得了更多算力想继续训练,或者您正在进行 scaling law(规模定律)实验并需要在不同 token 数量上训练同一模型。余弦衰减迫使您从头开始。
许多团队现在使用不需要在预热后立即开始衰减的调度策略。如下图所示,预热–稳定–衰减(WSD,warmup–stable–decay) (Hu et al., 2024) 和多步(multi-step) (DeepSeek-AI, :, et al., 2024) 变体就是这种情况:在大部分训练过程中保持恒定的高学习率,然后在 WSD 的最后阶段急剧衰减(通常是最后 10–20% 的 token),或者通过离散的降幅(步进)来降低学习率。例如,DeepSeek LLM 使用多步学习率调度,分别在 80% 和 90% 的训练进度处进行降幅。
这些调度策略相比余弦衰减具有实际优势。我们可以在训练中途扩展训练时长而无需重启,可以提前进行衰减以更清晰地了解训练进度,还可以在单次主训练运行内针对不同 token 数量运行 scaling law 实验。此外,研究表明 WSD 和多步方法都与余弦衰减的性能相当 (DeepSeek-AI, :, et al., 2024; Hägele et al., 2024),同时对于实际训练场景更为实用。
但您可能已经注意到,与余弦衰减相比,这些调度策略引入了新的超参数。WSD 中的衰减阶段应持续多长时间?多步变体中每一步应持续多长时间?
- 对于 WSD: 达到与余弦衰减相当性能所需的冷却持续时间随训练时长的增加而减少。通常建议将总 token 数的 10–20% 分配给衰减阶段 (Hägele et al., 2024)。我们将在下一节的消融实验中确认此设置与余弦衰减相当。
- 对于多步方法: DeepSeek LLM 的消融实验揭示,虽然他们的基准 80/10/10 分割(稳定至 80%,第一步从 80–90%,第二步从 90–100%)与余弦衰减相当,但通过调整这些比例(例如使用 70/15/15 和 60/20/20 的分割)有可能超越它。
我们甚至可以在学习率调度上更有创意。让我们来看看其他 DeepSeek 模型中使用的调度策略:
DeepSeek LLM 使用了基准多步调度(80/10/10)。DeepSeek V2 (DeepSeek-AI, Liu, et al., 2024) 将比例调整为 60/30/10,为第一个衰减步骤提供了更多时间。DeepSeek V3 (DeepSeek-AI et al., 2025) 采用了最具创意的方法:它不是在恒定学习率后进行两次急剧步进,而是从恒定阶段以余弦衰减的方式过渡(从训练的 67% 到 97%),然后在最后急剧步进之前应用一个短暂的恒定阶段。
DeepSeek-V2 和 V3 的技术报告中不包含这些调度变化的消融实验。对于您的设置,从简单的 WSD 或多步调度开始,然后考虑通过消融实验调优参数。
让我们在此结束对各类学习率调度的调研,去烧一些 GPU 时间来确定什么在实践中真正有效!
消融实验——WSD 与余弦衰减相当
是时候做消融实验了。让我们测试 WSD 是否真的能达到与余弦衰减相当的性能。我们在此不展示多步消融实验,但建议您查阅 DeepSeek LLM 的消融实验,其中显示了不同阶段分割下多步方法与余弦衰减相当的结果。
我们将余弦衰减与两种衰减窗口(10% 和 20%)的 WSD 进行比较。
评估结果表明,三种配置的最终性能相近。观察损失和评估曲线(尤其是 HellaSwag),我们发现一个有趣的模式:余弦衰减在稳定阶段(WSD 衰减开始之前)取得了更好的损失和评估分数。然而,一旦 WSD 进入衰减阶段,损失和下游指标几乎呈线性改善,使 WSD 能够在训练结束时追赶上余弦衰减。
这证实了 WSD 10–20% 的衰减窗口足以达到与余弦衰减相当的最终性能,同时保持了在训练中途扩展训练的灵活性。我们为 SmolLM3 选择了衰减比例为 10% 的 WSD。
如果您在稳定阶段比较余弦衰减和 WSD 的中间检查点,请确保对 WSD 检查点应用衰减后再进行公平比较。
现在我们对常见学习率调度有了很好的了解,下一个问题是:学习率实际上应该设为多少?
寻找最优学习率
为了找到我们特定调度器和训练设置的最优学习率,我们可以像为架构选择所做的那样,在短期消融实验中进行学习率扫描。但最优学习率取决于训练时长:在短期消融实验中收敛最快的学习率,未必是完整训练运行中的最佳选择。而且我们负担不起仅为测试不同学习率就多次运行耗时数周的训练。
让我们先看看一些可以快速排除明显过高或过低学习率的简单扫描。然后我们将讨论超参数的 scaling law。
消融实验——学习率扫描
为了说明学习率的影响,让我们对一个在 45B token 上训练的 1B 消融模型进行扫描。我们将在相同设置下用四种不同学习率训练同一模型:1e-4、5e-4、5e-3、5e-2。结果清楚地展示了两个极端的危险。
学习率 5e-2 几乎立即发散:损失在早期急剧上升且永远无法恢复,导致模型不可用。学习率 1e-4 过于保守;虽然训练稳定,但收敛速度远慢于其他学习率。中间选项学习率 5e-4 和 5e-3 表现出更好的收敛性和相当的性能。
对于 SmolLM3,我们使用 WSD 调度和 AdamW,在 100B token 上训练 3B 模型,比较了多个学习率。我们发现 2e-4 在损失和下游性能上的收敛速度均远快于 1e-4,而 3e-4 仅比 2e-4 略好。3e-4 带来的边际收益伴随着长训练运行中不稳定性增加的风险,因此我们选择 2e-4 作为最佳平衡点。
这些扫描帮助我们排除明显过高(发散)或过低(收敛缓慢)的学习率——但为每种模型规模都进行扫描会很快变得昂贵,更重要的是,这些较短训练运行的结果可能无法准确反映完整训练运行中的情况。这正是 scaling law 变得无价的地方。
不过,在深入讨论超参数的 scaling law 之前,让我们先讨论另一个与学习率相互作用的关键超参数:批量大小。
批量大小
批量大小(batch size)是在更新模型权重之前处理的样本数量。它直接影响训练效率和最终模型性能。如果硬件和训练栈能够良好地跨设备扩展,增大批量大小可以提高吞吐量(throughput)。但超过某个点后,更大的批量会开始损害数据效率(data efficiency):模型需要消耗更多总 token 才能达到相同的损失。发生这一转变的临界点被称为临界批量大小(critical batch size) (McCandlish et al., 2018)。
扩大批量大小有两种方式:
- 在临界值以下增大批量大小: 增大批量大小并重新调优学习率后,您可以用与小批量运行相同数量的 token 达到相同的损失;没有数据被浪费。
- 在临界值以上增大批量大小: 更大的批量开始牺牲数据效率;达到相同损失现在需要更多总 token(因此花费更多金钱),即使实际时间减少了,因为有更多芯片在工作。
让我们思考为什么需要重新调优学习率,并了解如何估算临界批量大小。
当批量大小增大时,每个小批量的梯度成为真实梯度的更好估计。这允许您安全地采取更大的步长(即增大学习率),并在更少的更新次数内达到目标损失。问题是如何进行缩放。
对 个样本求平均:
- 批量梯度:
- 均值不变:
- 但协方差缩小:
SGD 参数更新为:
此更新的方差正比于:
因此,为了保持更新方差大致恒定,如果将批量大小缩放 倍,则需要将学习率缩放 倍。假设您已计算出最优批量大小和学习率,并发现增大到临界批量大小是可行的且能提高吞吐量。您还需要相应地调整最优学习率:
对于 AdamW 或 Muon 等优化器,一个有用的经验法则是随批量大小增长采用平方根 LR 缩放,但其具体工作方式取决于优化器。例如,使用 AdamW 时,与 beta1 / beta2 的交互会引入截然不同的行为。@merrill2025criticalbatchsizerevisited 提出了一种实用替代方案:分叉训练运行持续一个短暂窗口——保持一次原始批量大小的运行,同时以较大批量大小和重新缩放的 LR 启动第二次运行,只有当两条损失曲线在重新缩放后对齐时才采用较大的批量大小。他们在切换批量大小时会对学习率进行预热并重置优化器状态。他们还设定了容差和时间窗口来判断损失是否”匹配”,这两个参数均凭经验选定。他们的结果表明, 估计——本身也有噪声——低估了”实际”临界批量大小。这为您提供了一种快速、低风险的方式来检验新的批量/学习率组合是否能保持训练动态。
临界批量大小不是固定的;它随训练的进行而增大。训练早期,模型在进行大步的梯度更新,因此 很大,这意味着 很小,即模型具有较小的临界批量大小。随后,随着模型更新趋于稳定,更大的批量变得更有效。这就是为什么一些大规模训练运行不保持批量大小恒定,而是使用我们称之为*批量大小预热(batch size warmup)*的策略。例如,DeepSeek-V3 在前约 469B token 使用 12.6M 的批量大小,然后在剩余训练中增加到 62.9M。这样的批量大小预热调度与学习率预热的目的相同:随着梯度噪声规模的增大,它使模型保持在高效边界上,从而在整个训练过程中维持稳定高效的优化。
另一种有趣的方法是将损失作为临界批量大小的代理指标。MiniMax-01 采用了这种方法,并在最后阶段使用了 128M 的批量大小!他们没有增大学习率,因此他们的批量大小调度起到了类似学习率衰减调度的作用。
在实践中,您可以按以下方式选择批量大小和学习率:
- 首先,根据 scaling law(见下一节)或文献中的参数,选择您认为最优的批量大小和学习率。
- 然后调优批量大小,看是否能提高训练吞吐量。
关键洞察是:在您的初始批量大小和临界批量大小之间,通常存在一个范围, 在这个范围内您可以增大批量大小以提高硬件利用率,同时不牺牲数据效率, 但您必须相应地重新调优学习率。 如果吞吐量的提升不显著,或者测试更大批量大小(配以重新缩放的学习率) 后显示出更差的数据效率,则坚持使用之前的值。
如上文注释所述,选择批量大小和学习率起始点的一种方法是通过 scaling law。让我们来了解这些定律的工作原理。
超参数的 Scaling Law
最优学习率和批量大小不仅与模型架构和规模有关;它们还取决于算力预算,而算力预算由模型参数数量和训练 token 数量共同决定。在实践中,这些因素相互作用,决定了我们的更新应该多激进或多保守。这正是 scaling law 的用武之地。
Scaling law 建立了描述模型性能如何随训练规模(无论是更大的模型还是更多训练数据)增加而演变的经验关系(完整历史详见本章末尾)。但它们也可以帮助我们预测随着训练规模扩大,应如何调整关键超参数,如学习率和批量大小,这已在 DeepSeek LLM 和 Qwen2.5 的近期工作中得到证实。这使我们能够设定有据可依的默认值,而不是完全依赖超参数扫描。
要在此背景下应用 scaling law,我们需要一种量化训练规模的方法。标准度量是算力预算,记为 ,可近似为 ,其中 是模型参数数量(例如,1B = 1e9), 是训练 token 数量。这通常以 FLOPs(浮点运算次数)来衡量,这是一种与硬件无关的量化实际计算量的方式。如果 FLOPs 感觉过于抽象,可以这样理解:在 100B token 上训练一个 1B 参数模型所消耗的 FLOPs,约为在 100B token 上训练 2B 参数模型或在 200B token 上训练 1B 参数模型的一半。
常数 6 来自对训练 transformer 所需浮点运算次数的经验估计:每个参数每个 token 大约需要 6 次 FLOPs。
那么,这与学习率有何关系?我们可以推导出 scaling law,预测最优学习率和批量大小作为总算力预算()的函数。它们有助于回答以下问题:
- 当我从 1B 扩展到 7B 参数时,学习率应如何变化?
- 如果我将训练数据翻倍,应该调整学习率吗?
让我们通过回顾 DeepSeek LLM 使用的方法来了解其工作原理。首先,我们选择学习率调度策略,最好是 WSD,因为它具有灵活性。然后,我们在一系列算力预算(例如 1e17、5e17、1e18、5e18、1e19、2e19 FLOPs)下,用不同的批量大小和学习率组合训练模型。更简单地说:我们用不同的 token 数量训练不同规模的模型,测试不同的超参数设置。这正是 WSD 调度大放异彩的地方,因为我们可以将同一训练运行扩展到不同的 token 数量而无需重启。
对于每种设置,我们对学习率和批量大小进行扫描,识别出接近最优性能的配置,通常定义为最佳验证损失(在一个分布与训练集相似的独立验证集上计算)的一个小幅差距以内(例如 0.25%)。每个接近最优的配置都给我们提供一个数据点——一个(算力预算 ,最优学习率 )或(,最优批量大小 )的元组。在对数-对数坐标上绘制时,这些关系通常呈现幂律行为,表现为近似直线(如下图所示)。通过拟合这些数据点,我们可以提取描述最优超参数如何随算力演变的 scaling law。
这一过程中一个重要发现是:对于固定的模型规模和算力预算,性能在大范围超参数设置下保持稳定。这意味着存在一个宽泛的最优区间,而非狭窄的最优点。我们不需要找到完美的值,只需找到足够接近的值,这使整个过程更加实用。
以下是 DeepSeek LLM 推导出的 scaling law 结果,其中每个点代表一个接近最优的设置:
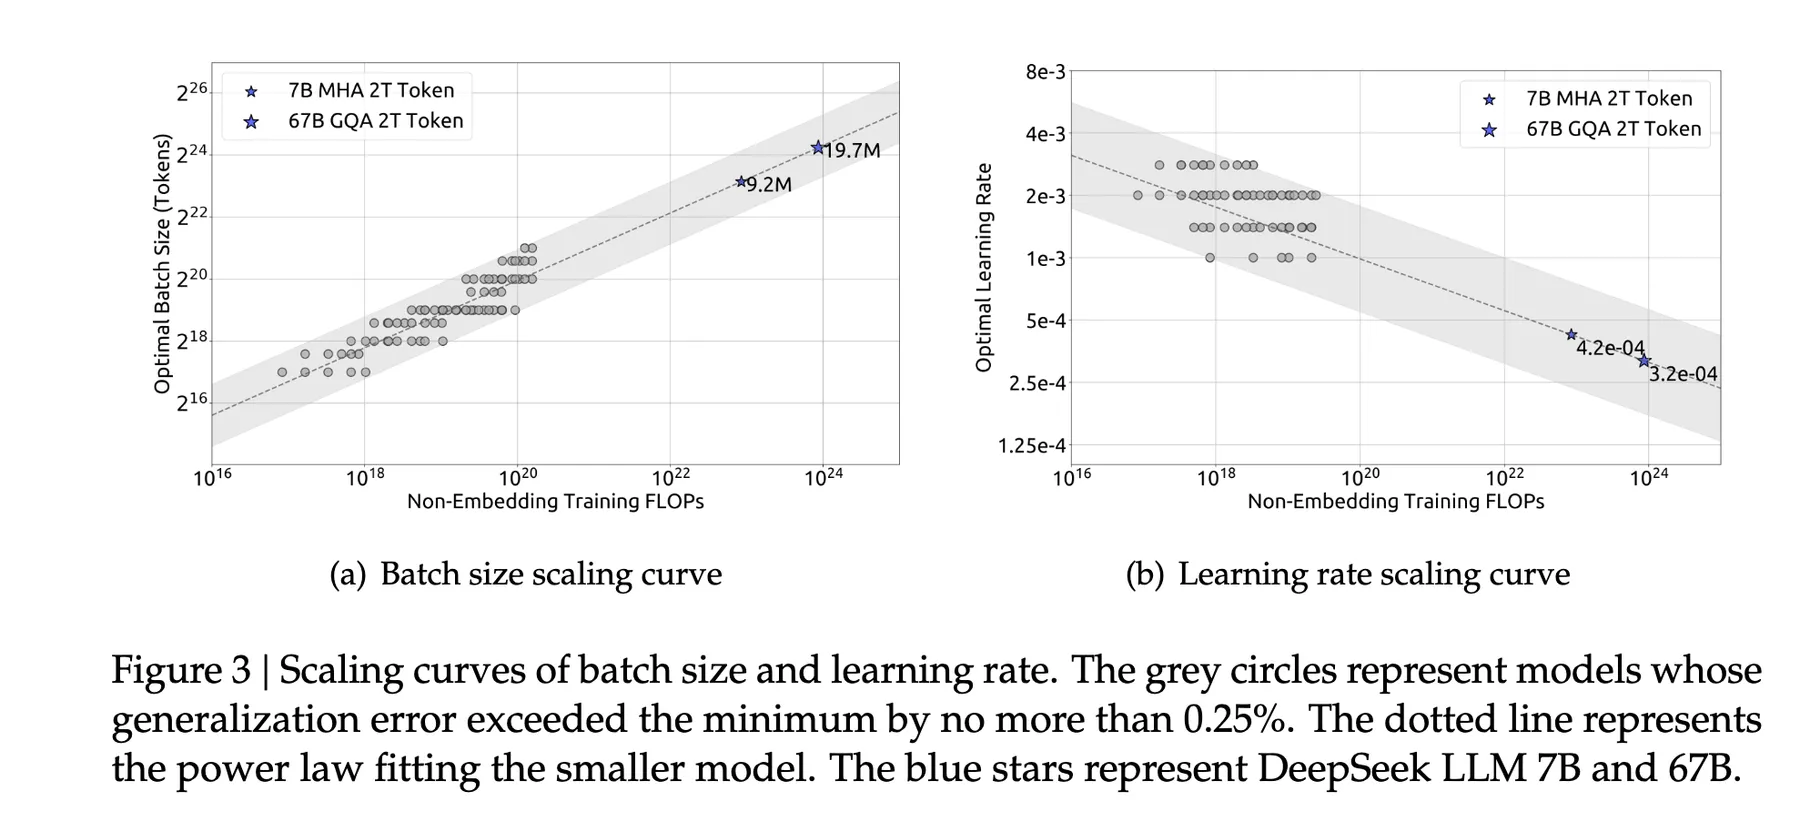
这些结果背后的核心直觉是:随着训练规模变大、训练时间变长,我们希望采用更稳定的更新(更小的学习率)和更高效的梯度估计(更大的批量大小)。
这些 scaling law 为我们提供了学习率和批量大小的起点。但目标不是”每次梯度更新使用最优的样本数”,而是”在时间和 GPU 数量约束下达到更低损失”,同时充分利用每个 token 的信号。
在实践中,您可能能够将批量大小增大到超过预测的最优批量大小,以显著提高吞吐量,而不会明显损害数据效率,直到我们之前讨论的临界批量大小为止。
SmolLM3
那么我们最终为 SmolLM3 使用了什么?在消融实验阶段,我们在 100B token 上训练的 1B 模型上比较了 AdamW、AdEMAMix 和 Muon。经过适当调优后,Muon 能够超越 AdamW,但对学习率敏感且容易发散。AdeMAMix 达到了与 Muon 相近的损失,但敏感性较低。AdamW 最为稳定,但最终损失高于调优后的替代方案。
然而,当我们扩展到 3B 时,Muon 和 AdeMAMix 出现了更频繁的发散。这可能是由于我们在完成消融实验后发现的一个并行化 bug(参见”训练马拉松”章节),但我们尚未确认这一点。我们决定使用 AdamW(beta1: 0.9, beta2: 0.95),权重衰减为 0.1,梯度裁剪为 1。最终,是一套非常朴素的设置。
对于学习率调度,我们选择了 WSD。我们在 SmolLM2 中曾成功使用它,事实证明它是我们在易用性和总训练时长灵活性方面的最佳决策之一,同时还支持运行训练中途衰减实验。我们进行了学习率扫描,最终确定为 2e-4。对于全局批量大小,我们测试了从 2M 到 4M token 的值,但发现对损失或下游性能的影响微乎其微,因此选择了 2.36M token,这是给我们带来最佳吞吐量的大小。
参与规则
TL;DR:平衡探索与执行。完成胜于完美。
我们已经大量讨论了”做什么”(优化器、学习率、批量大小),但同样重要的是”怎么做”。我们如何决定什么值得实验?如何规划时间?何时停止探索,直接开始训练?
明智地分配探索与执行之间的时间。 花数周时间从一种新方法中精化微小改进的价值,不如将同等算力投入更好的数据整理或更彻底的架构消融实验。根据我们的经验,尽管这可能会令架构爱好者失望,但最大的性能提升通常来自数据整理。
当存在疑问时,选择灵活性和稳定性而非峰值性能。 如果两种方法表现同等,选择提供更多灵活性或具有更好实现成熟度和稳定性的那种。像 WSD 这样允许您扩展训练或运行训练中途实验的学习率调度,比一个可能收敛略好但固定死板的调度更有价值。
知道何时停止优化,开始训练。 总是还有一个超参数可以调优,或者一个优化器可以尝试。为探索设定一个截止日期并严格遵守——您真正完成训练的模型,永远胜过那个您从未开始训练的完美模型。
完美是优秀的敌人,在有限算力预算和截止日期的压力下尤其如此。
Scaling Law:多少参数,多少数据?
在深度学习的早期,在语言模型(以及训练它们的集群)变得”大型”之前,训练运行通常不受算力的严格限制。训练模型时,您只需选择适合硬件的最大模型和批量大小,然后训练直到模型开始过拟合或数据耗尽。然而,即使在那些早期日子里,人们已经感受到规模是有益的——例如,Hestness 等人在 2017 年提供了一套全面的结果,表明训练更大的模型更长时间能产生可预测的收益。
在大语言模型时代,我们始终受到算力的限制。为什么?早期的可扩展性概念被 Kaplan 等人在”神经语言模型的 Scaling Law”中的工作正式化,该工作表明语言模型的性能在许多数量级的规模上都具有显著的可预测性。这引发了语言模型规模和训练时长的爆炸式增长,因为它提供了一种准确预测增加规模将如何改善性能的方法。因此,构建更好语言模型的竞赛变成了在越来越大的算力预算下用更大数据量训练更大模型的竞赛,语言模型的发展迅速变得受算力约束。
面对算力限制,最重要的问题是训练更大的模型还是使用更多数据。令人惊讶的是,Kaplan 等人的 scaling law 表明,将更多算力分配给模型规模比以往最佳实践更为有利——这促使了,例如,在相对适中的 token 预算(300B token)上训练庞大的(175B 参数)GPT-3 模型。经重新审视,Hoffman 等人(2022)发现了 Kaplan 等人方法中的一个方法论问题,最终重新推导出 scaling law,表明应将更多算力分配给训练时长——例如,这表明 175B 参数 GPT-3 的算力最优训练应当消耗 3.7T token!Hoffman 等人修订后的 scaling law 被称为 Chinchilla 定律,以激发这一更新的 Chinchilla 模型命名。
这一发展将领域重心从”让模型更大”转向了”训练更长时间、更好”。然而,大多数现代训练运行仍不严格遵循 Chinchilla 定律,因为它们有一个缺陷:它们旨在预测在给定算力预算下能达到最佳性能的模型规模和训练时长,但未能考虑到更大的模型在训练之后运行代价更高的事实。换句话说,我们实际上可能更愿意用给定的算力预算训练一个更小的模型更长时间,即使这不是”算力最优”的,因为这将使推理成本更便宜(Sardana 等人,2025;de Vries,2023)。如果我们预期一个模型将被大量推理使用(例如,因为它是开放发布的 🤗),这就可能是合理的选择。近期,这种将模型训练时长”过度”超出 scaling law 建议的实践已成为标准做法,这也是我们开发 SmolLM3 时采取的方法。
虽然 scaling law 为给定算力预算提供了模型规模和训练时长的建议,但选择过度训练意味着您必须自己决定这些因素。对于 SmolLM3,我们首先选定了 3B 参数的目标模型规模。根据规模相近的近期模型,如 Qwen3-4B、Gemma 3 4B 和 Llama 3.2 3B,我们认为 3B 规模足够大,能让模型具备有意义的能力(例如推理和工具调用),但又足够小,能够实现超快推理和高效的本地使用。为了确定训练时长,我们首先注意到近期模型已经极度过度训练——例如,前述 Qwen3 系列声称已在 36T token 上进行训练!因此,训练时长通常由可用算力决定。我们获得了 384 块 H100,使用约一个月,这提供了在 11T token 上训练的预算(假设模型 FLOPs 利用率约为 30%)。
尽管存在这些偏差,scaling law 在实践中仍然具有重要价值。 它们为实验设计提供基线, 人们通常使用 Chinchilla 最优设置来获得消融实验的信号, 并帮助预测给定模型规模是否能达到目标性能。 正如 Harm de Vries 在 “Go Smol or Go Home” 中所指出的, 通过缩小模型规模,您可以触及临界模型规模:达到给定损失所需的最小容量, 低于该规模您将开始获得递减回报。
既然我们已经确定了模型架构、训练设置、模型规模和训练时长,我们还需要准备两个关键组件:教导模型的数据混合,以及可靠运行训练的基础设施。SmolLM3 的架构确定为 3B 参数后,我们需要整理能够提供强大多语言、数学和代码性能的数据混合,并建立足以支撑 11T token 训练数据的稳健基础设施。将这些基础工作做好至关重要——即使是最好的架构选择,也无法拯救糟糕的数据整理或不稳定的训练系统。
数据筛选的艺术
想象这样一个场景:你花了数周时间完善架构、调整超参数(hyperparameters)、搭建最健壮的训练基础设施。模型收敛得漂亮极了,然后……它却写不出连贯的代码,连基本的数学都磕磕绊绊,甚至会在句子中途切换语言。哪里出了问题?
答案通常藏在数据里。当我们沉迷于花哨的架构创新和超参数扫描时,数据筛选往往才是决定模型是真正有用还是只是又一次昂贵实验的关键。
如果说模型架构决定了你的模型 如何 学习,那么数据就决定了它 学什么,而再多的算力或优化器调优都无法弥补在错误内容上训练的代价。这就像随机网络爬取与精心筛选的高质量数据集之间的差距——后者才能真正教会模型我们想要的技能。但把训练数据做对,不仅仅是拥有好的数据集,更在于组装正确的 混合配比(mixture):在相互冲突的目标之间取得平衡(例如强英文能力 vs. 强多语言鲁棒性),并调整数据比例以对齐性能目标。这个过程与其说是找到一个放之四海而皆准的”最优”配比,不如说是提出正确的问题并制定具体计划来回答它们:
- 我们希望模型擅长什么?
- 哪些数据集最适合每个领域,该如何混合它们?
- 对于目标训练规模,我们是否有足够的高质量数据?
本章将帮助你理清这些问题,综合运用有原则的方法、消融实验(ablation experiments)和一点点”炼金术”,将一堆优质数据集炼制成一个出色的训练混合配比。
什么是好的数据混合配比,它为何如此重要?
我们对语言模型寄予厚望:它们应该能帮我们写代码、给出建议、回答几乎任何问题、使用工具完成任务等等。像网络这样丰富的预训练数据来源,并不能覆盖这些任务所需的全部知识和能力。因此,近期的模型还额外依赖针对特定领域(如数学和编程)的更专业化预训练数据集。我们过去在数据集筛选方面做了大量工作,但对于 SmolLM3,我们主要使用的是已有的数据集。(想了解更多数据集筛选的内容,请参阅我们关于构建 FineWeb and FineWeb-Edu、FineWeb2 以及 Stack-Edu and FineMath 的报告。)
数据混合配比的反直觉本质
如果你刚刚接触语言模型训练,也许会觉得找到好的数据混合配比很简单:确定目标能力、为每个领域收集高质量数据集、然后合并它们。现实却更为复杂,因为某些领域可能会在训练预算上相互竞争。当专注于某项特定能力(如编程)时,人们很容易想要上调与任务相关的数据(如源代码)的比例。然而,上调一个来源实际上隐式地下调了所有其他来源,从而损害语言模型在其他场景的能力。因此,在多个不同来源上训练,本质上需要在下游能力之间找到某种平衡。
此外,在所有这些来源和领域中,往往存在一个”高质量”数据的子集,它对提升语言模型能力尤为有效。为什么不把所有低质量数据都扔掉,只在最高质量的数据上训练呢?对于训练预算很大的模型(如 SmolLM3 的 11T tokens),如此极端的过滤会导致数据被重复多次。先前的研究表明,这种重复可能是有害的 (Muennighoff et al., 2025),所以理想情况下,我们应该能够同时利用高质量和低质量数据,同时最大化模型性能。
为了在各来源之间平衡数据,并确保拥有足够的高质量数据,我们需要仔细设计 混合配比(mixture):来自每个来源的训练文档的相对比例。由于语言模型在任何给定任务或领域上的表现,很大程度上取决于它见过多少与该任务相关的数据,调整混合权重(mixing weights)提供了一种直接平衡模型跨领域能力的方式。由于这些权衡依赖于模型本身且难以预测,消融实验(ablations)至关重要。
此外,混合配比在训练过程中不必一成不变。通过随着训练进展调整配比——即我们所说的 多阶段训练(multi-stage training)或 课程训练(curriculum training)——我们可以更好地利用高质量和低质量数据。
训练课程的演进
在大语言模型训练的早期,标准做法是在整个训练过程中固定使用单一数据混合配比。GPT-3 和早期版本的 Llama 等模型从始至终都在一个静态配比上训练。近年来,该领域已转向多阶段方法 (Allal et al., 2025),在训练过程中改变数据混合配比。其主要动机在于:语言模型的最终行为受训练后期所见数据的强烈影响 (Y. Chen et al., 2025b)。这一洞察促成了一种实用策略:在训练早期上调比例更大的来源,在训练后期混入体量更小、质量更高的来源。
一个常见的问题是:如何决定何时改变配比?没有通用规则,但我们通常遵循以下原则:
- 性能驱动的干预: 在关键基准测试上监控评估指标,并调整数据集配比以解决特定能力瓶颈。例如,如果数学性能停滞不前而其他能力持续提升,这就是引入更高质量数学数据的信号。
- 为后期阶段保留高质量数据: 体量较小的高质量数学和代码数据集,在退火阶段(即最后阶段,伴随学习率衰减)引入时效果最为显著。
既然我们已经确立了配比为何重要以及课程训练如何运作,接下来让我们讨论如何对两者进行调优。
消融实验设置:如何系统性地测试数据配方
测试数据混合配比时,我们的方法与架构消融实验类似,但有一点不同:我们尽量在目标模型规模上运行实验。小模型和大模型的容量不同。例如,一个很小的模型可能难以处理多种语言,而较大的模型则可以吸收这些语言而不牺牲其他方面的性能。因此,在过小的规模下运行数据消融实验,有可能得出关于最优配比的错误结论。
对于 SmolLM3,我们直接在 3B 模型上运行主要数据消融实验,使用了 50B 和 100B tokens 的较短训练轮次。我们还使用了另一种消融实验设置:退火实验(annealing experiments)。我们不从头开始用不同配比训练,而是从主训练轮次的中间检查点(例如在 7T tokens 处)继续训练,使用经过修改的数据组成。这种方法在 SmolLM2、Llama 3 和 OLMo 2 等近期工作中均有使用,允许我们测试多阶段训练的数据配比变化。在评估方面,我们扩展了基准测试套件,在标准英文评估的基础上加入了多语言任务,以确保能够正确评估不同语言比例之间的权衡。
近期研究已提出了寻找最优数据比例的自动化方法。例如:
- DoReMi (Xie et al., 2023) 使用一个小型代理模型来学习使验证损失最小化的领域权重。
- RHO-LOSS (Mindermann et al., 2022) 基于留出集损失(holdout loss)选择单个训练点,优先选择可学习、与任务相关且模型尚未学会的样本。
- RegMix (Q. Liu et al., 2025) 通过正则化回归(regularized regression)确定最优数据混合比例,在多个评估目标和数据领域之间平衡性能。
我们在过去的项目中试验过 DoReMi 和 RHO-LOSS,但发现它们倾向于收敛到大致反映数据集规模自然分布的分布——本质上是建议我们多用我们本来就更多的数据。尽管在理论上很吸引人,但在我们的实验设置下,它们并没有超过精心手动消融实验的表现。近期最先进的模型仍然依赖通过系统消融实验和退火实验进行的手动配比调优,这也是我们为 SmolLM3 所采用的方法。
SmolLM3:筛选数据混合配比
对于 SmolLM3,我们希望打造一个能够处理英文和多语言内容,并在数学和代码方面表现出色的模型。这些内容类型在大多数 LLM 中很常见,但我们在此描述的过程同样适用于训练低资源语言或特定领域(如金融或医疗健康)的模型。方法是一样的:确定优质候选数据集、运行消融实验,并设计一个平衡所有目标领域的配比。
我们不会在这里介绍如何构建高质量数据集,因为我们已经在早期工作中对此进行了详尽说明。本节重点介绍我们如何将这些数据集 组合 成有效的预训练混合配比。
建立在经过验证的基础之上
在预训练数据方面,好消息是我们几乎不必从零开始。开源社区已经为大多数常见领域构建了强大的数据集。有时我们需要创造新的数据集,就像我们在 Fine 系列(FineWeb、FineMath 等)中所做的那样,但更多时候挑战在于选择和组合现有来源,而不是重新发明它们。
这正是我们面对 SmolLM3 时的处境。SmolLM2 已经在 1.7B 参数规模下为英文网页数据确立了一个强大的配方,并确定了我们当时能获取的最佳数学和代码数据集。我们的目标是将这一成功扩展到 3B 参数,同时增加稳健的多语言能力、更强的数学推理和更好的代码生成等新能力。
英文网页数据:基础层
网页文本构成了任何通用 LLM 的骨架,但质量与数量同样重要。
从 SmolLM2 中,我们了解到 FineWeb-Edu 和 DCLM 是训练时最强的开源英文网页数据集。它们合计为我们提供了 5.1T tokens 的高质量英文网页数据。挑战在于确定最优混合比例:FineWeb-Edu 有助于提升教育类和 STEM 基准测试的表现,而 DCLM 则改善常识推理(common-sense reasoning)能力。
沿用 SmolLM2 的方法,我们在 3B 模型上对 100B tokens 进行了扫描,测试了 FineWeb-Edu/DCLM 比例为 20/80、40/60、50/50、60/40 和 80/20 的情况。我们发现 60/40 或 50/50 的混合比例在各基准测试间提供了最佳平衡,与我们的 SmolLM2 发现一致。我们决定在第 1 阶段采用 50/50 的比例。我们还添加了少量其他数据集,如 pes2o、Wikipedia & Wikibooks 和 StackExchange。这对性能没有任何影响,但我们将其纳入是为了提升多样性。
多语言网页数据
在多语言能力方面,我们将目标锁定在另外五种语言:法语、西班牙语、德语、意大利语和葡萄牙语。我们从 FineWeb2-HQ 中选取了这些语言的数据,共计 628B tokens。我们还以较小的比例纳入了另外 10 种语言,如中文、阿拉伯语和俄语——目的并非让这些语言达到最先进的性能,而是让用户能够轻松地在这些语言上对 SmolLM3 进行持续预训练(continual pretraining)。对于 FineWeb2-HQ 不支持的语言,我们使用了 FineWeb2。
关键问题是:我们的网页数据中应有多少比例是非英文的?我们知道,模型看到某种语言或领域的数据越多,它在该语言或领域的表现就越好。然而,固定的算力预算意味着增加一种语言的数据必然减少其他语言(包括英语)的数据。
通过在 3B 模型上进行消融实验,我们发现 12% 的多语言内容(约占整体网页混合的 14%)达到了恰当的平衡,在提升多语言性能的同时不降低英文基准测试的表现。这符合 SmolLM3 的预期使用场景,即英语仍将是主要语言。值得注意的是,非英语数据仅有 628B tokens,而英语数据高达 5.1T tokens,若比例再高,则需要对多语言数据进行更多轮次的重复训练。
代码数据
第 1 阶段的代码来源提取自 StarCoder2 and The Stack v2 训练语料库。我们纳入了:
- The Stack v2(16 种编程语言)作为基础,经过过滤后称为 StarCoder2Data
- StarCoder2 GitHub pull requests,用于真实世界的代码审查推理
- Jupyter 和 Kaggle notebooks,提供可执行的、循序渐进的工作流
- GitHub issues 和 Stack Exchange 线程,提供围绕代码的上下文讨论
Aryabumi et al. (2024) 指出,代码能够提升语言模型在编程之外的表现,例如在自然语言推理和世界知识方面,并建议在训练混合配比中使用 25% 的代码。受此启发,我们将消融实验的起点设为 25% 的代码比例。然而,我们观察到英文基准测试(HellaSwag、ARC-C、MMLU)出现了显著下降。将代码比例降至 10% 后,与 0% 代码相比,我们在英文基准测试套件上并未观察到改善,但我们还是将其纳入了,因为代码生成是模型必须具备的重要能力。
我们将 Stack-Edu——即 StarCoder2Data 经过教育过滤后的子集——推迟到后续阶段再加入,遵循的是将高质量数据留待训练后期以产生最大影响的原则。
数学数据
我们对数学采用了与代码类似的理念。早期阶段,我们使用体量更大、更通用的 FineMath3+ 和 InfiWebMath3+。后期阶段,我们上调了 FineMath4+ 和 InfiWebMath4+ 的比例,并引入了几个新的高质量数据集:
- MegaMath (Zhou et al., 2025)
- 指令和推理数据集,如 OpenMathInstruct (Toshniwal et al., 2024) 和 OpenMathReasoning (Moshkov et al., 2025)
第 1 阶段我们使用了 3% 的数学数据,在 FineMath3+ 和 InfiWebMath3+ 之间均分。由于只有 54B tokens 可用,而第 1 阶段估计需要 8T 到 9T tokens,超过这一比例将需要对数据集进行五轮以上的重复训练。
为新阶段寻找合适的配比
虽然我们从头运行消融实验来确定最佳的第 1 阶段配比,但对于后续阶段(我们有两个后续阶段)的新数据集测试,我们使用了退火消融实验。我们取约 7T tokens 处(第 1 阶段后期)的检查点,并以如下设置进行 50B tokens 的退火实验:
- 40% 基础配比: 我们一直在训练的第 1 阶段精确配比。
- 60% 新数据集: 我们想要评估的候选数据集。
例如,为了测试 MegaMath 是否能提升数学性能,我们运行了由 40% 第 1 阶段数据(维持 75/12/10/3 的领域分割)和 60% MegaMath 数据组成的退火配比实验。
全部三个阶段的组成详情,您可以在下一章中找到。
在数据经过精心筛选、混合配比通过消融实验验证之后,我们准备好踏上实际的训练之旅。接下来要讲述的,是 SmolLM3 长达一个月训练过程的故事:前期准备、意外挑战,以及沿途积累的经验教训。
训练马拉松
恭喜你坚持到了这一步——真正的乐趣即将开始!
此刻,万事俱备:经过验证的架构、最终确定的数据混合方案,以及调优好的超参数(hyperparameters)。剩下的事情就是搭建基础设施,然后按下”训练”按钮。
对于 SmolLM3,我们在 384 块 H100 GPU(48 个节点)上训练了近一个月,处理了 11 万亿个 token(词元)。本节将带你了解一次漫长训练运行中实际发生的一切:预飞行检查、不可避免的意外,以及我们如何保持训练稳定。你将亲眼见证为什么扎实的消融(ablation)实践和可靠的基础设施都至关重要。我们在最后一章中详细介绍了 GPU 硬件、存储系统和吞吐量优化等技术基础设施细节。
我们的团队经历过多次这样的训练:从 StarCoder 和 StarCoder2,到 SmolLM、SmolLM2,再到如今的 SmolLM3。每一次训练都不尽相同。即使你已经训练过十几个模型,每次新的训练都会找到新的方式让你措手不及。我们的目标是向你展示如何让胜算更多地站在你这边,以便随时应对这些意外。
预飞行检查清单:训练开始前必须核实的事项
在按下”训练”之前,我们会逐项检查清单,确保一切都能端到端正常运行。这包括:
-
基础设施就绪性:
- 如果你的集群支持 Slurm 预留(reservation),就使用它。对于 SmolLM3,我们在整个训练期间拥有固定的 48 节点预留。这意味着没有排队延迟、吞吐量持续稳定,并且能够长期追踪节点健康状况。
- 在启动前对 GPU 进行压力测试(我们使用 GPU Fryer 和 DCGM Diagnostics),以发现节流(throttling)或性能下降问题。对于 SmolLM3,我们发现两块 GPU 存在节流现象,并在开始训练前将其更换。
- 避免存储膨胀。我们的系统将每个检查点(checkpoint)上传到 S3,然后在保存下一个检查点后立即删除本地副本,因此快速本地 SSD 上存储的检查点从不超过一个。
-
评估设置: 评估比看上去更耗时。手动运行评估、记录结果、绘制图表可能占用数小时。如果可能的话,将其完全自动化,并在训练开始前确保评估能够正确运行和记录。对于 SmolLM3,每个保存的检查点都会自动在集群上触发一个评估任务,并将结果记录到 Wandb 和 Trackio。
-
检查点与自动恢复系统: 验证检查点保存正确,且训练任务能够从最新检查点恢复,无需人工干预。在 Slurm 上,我们使用
--requeue选项,这样失败的任务会自动重新启动,并从最近的检查点恢复。 -
指标记录: 确认你正在记录所有关心的指标:评估分数、吞吐量(tokens/sec,即每秒词元数)、训练损失(training loss)、梯度范数(gradient norm)、节点健康状况(GPU 利用率、温度、内存使用情况),以及特定于你的训练运行的任何自定义调试指标。
-
训练配置合理性检查: 仔细检查你的训练配置、启动脚本和 Slurm 提交命令。
For detailed guidance on GPU testing, storage benchmarking, monitoring setup, and building resilient training systems, see the Infrastructure chapter.
规模化带来的意外
在针对 SmolLM3 进行了大量消融实验之后,我们已为全规模训练做好了准备。我们在 1000 亿 token 上进行的 3B 消融实验结果很有希望。与 SmolLM2 相比引入的架构变化(详见”架构选择”:GQA、NoPE、文档掩码(document masking)、分词器(tokenizer))要么提升了性能,要么保持了性能持平;我们还找到了在英语、多语言、代码和数学性能之间取得良好平衡的数据混合方案(参见”SmolLM3:精心设计数据混合”)。我们针对 384 块 GPU(48 个节点)优化了配置,使模型浮点运算利用率(MFU,Model FLOPs Utilization)达到约 30%。
我们已为大战做好准备:11 万亿 token。然而现实开始接连抛出变数。
谜题 #1——消失的吞吐量
启动后数小时内,吞吐量(throughput)骤然下降。这是一次急剧的跌落,并伴随着反复出现的急剧骤降。
Throughput measures how many tokens per second our system processes during training. It directly impacts training time—a 50% drop in throughput means our month-long run becomes a two-month run. In the Infrastructure chapter, we’ll show how we optimized throughput for SmolLM3 before starting the run.
这种情况在任何消融实验运行中都没有出现过,那么究竟发生了什么变化?有三点不同:
- 训练数据集的规模。我们现在使用的是完整的约 24 TB 训练数据集,而不是消融实验中使用的较小子集,尽管数据来源本身是相同的。
- 训练步数。我们为 11 万亿 token 设置了真实的步数,而不是 1000 亿 token 消融实验的短期视野。
- 潜在的硬件状态。在消融实验中运行正常的 GPU 可能在持续负载下发生故障,网络连接也可能出现下降。
其他所有内容与吞吐量消融实验完全相同:节点数量、数据加载器(dataloader)配置、模型布局、并行设置……
直觉上,数据集大小和步数都不应导致吞吐量下降,因此我们自然首先怀疑是硬件问题。我们检查了节点监控指标,发现吞吐量的大幅下降与磁盘读取延迟的骤增相关。这直接将矛头指向了我们的数据存储。
Our cluster has three storage tiers for training data:
- FSx: Network-attached storage that uses Weka, a “keep-hot” caching model that stores frequently accessed files locally and evicts inactive “cold” files to S3 as capacity fills up.
- Scratch (Local NVMe RAID): Fast local storage on each node (8 × 3.5 TB NVMe drives in RAID), which is faster than FSx but limited to local node access.
- S3: Remote object storage for cold data and backups.
You can find more details in the Infrastructure chapter.
对于 SmolLM3 的 24 TB 数据集,我们最初将数据存储在 FSx(Weka)中。但 24 TB 的训练数据,加上其他几个团队已占用的存储空间,使 Weka 的存储几乎达到了极限。它开始在训练过程中驱逐(evict)数据集分片(shards),这意味着我们不得不重新获取这些分片,从而造成停顿,这也解释了吞吐量的大幅下降。
修复 #1——更换数据存储
我们找不到在整个 Weka 训练期间将数据集文件夹固定为”热”(hot)状态的方法,因此我们尝试更换存储方式。直接从 S3 流式传输速度太慢,于是我们决定将数据存储在每个节点的本地暂存(scratch)存储上。
这有一个问题:如果某个节点故障并被替换,新的替换 GPU 上没有数据。使用 s5cmd 从 S3 下载 24 TB 数据需要 3 小时。通过使用 fpsync 从另一个健康节点复制而不是走 S3,我们将时间缩短到了 1.5 小时。这更快,因为所有节点都在同一个数据中心。
尽管如此,每次节点故障需要 1.5 小时的停机时间,以及需要立即手动将数据复制到新节点,这仍然令人痛苦。最终让这一切变得可以接受的技巧是:在我们的 Slurm 预留中保留一个预装了数据集的备用节点。如果某个节点故障,我们立即用备用节点替换它,恢复延迟为零。在空闲时,备用节点运行评估或开发任务,因此不会浪费资源。
这解决了谜题 #1……或者我们是这么以为的。
谜题 #2——持续出现的吞吐量骤降
即使在将数据迁移到暂存存储之后,单次的吞吐量骤降仍在持续出现,尽管我们在硬件监控指标中没有发现任何异常。下图将修复存储问题后(橙色)的吞吐量与消融实验期间(蓝色)的吞吐量进行了对比。如你所见,骤降实际上变得更加剧烈了。
仍然怀疑是硬件问题,我们决定在较少节点上进行测试。使用 384 块 GPU 时,某些节点发生故障的概率相当高。令人惊讶的是,无论我们测试哪个具体节点,我们都能在单个节点上复现完全相同的吞吐量骤降。这排除了硬件问题。
还记得与消融实验相比变化了的三件事吗?我们已经通过迁移到本地节点存储解决了数据存储问题,硬件问题现在也被排除了。这只剩下一个变量:步数。我们通过回滚到较小的步数(从 320 万降至 3.2 万)来测试这一假设,结果吞吐量骤降变小了!较大的步数会产生更剧烈、更频繁的骤降。
以下是我们使用的精确配置,其他所有内容保持不变:
## Short run (32k steps)
- "lr_decay_starting_step": 2560000
- "lr_decay_steps": 640000
- "train_steps": 3200000

## Long run (3.2M steps)
+ "lr_decay_starting_step": 26000
+ "lr_decay_steps": 6000
+ "train_steps": 32000
如下图所示,结果非常明确:较短的训练产生小的吞吐量骤降,而较大的步数则产生更剧烈、更频繁的骤降。因此,问题不在于硬件,而是软件瓶颈——考虑到训练中大多数其他组件对每个批次的处理方式与步数无关,瓶颈很可能出在数据加载器上。
这时我们才意识到,我们实际上从未使用 Nanotron 的数据加载器进行过大规模预训练。SmolLM2 使用的是源自 Megatron-LM 的数据加载器(TokenizedBytes),通过围绕 Nanotron 的内部包装器实现,并以稳定的吞吐量完成了训练。对于 SmolLM3,我们切换到了 Nanotron 内置的数据加载器(nanosets)。
经过对其实现的深入分析,我们发现它在朴素地构建一个随每个训练步数增长的巨大索引。对于非常大的步数,这会导致更高的共享内存使用量,从而触发吞吐量骤降。
修复 #2——引入 TokenizedBytes 数据加载器
为了确认数据加载器确实是罪魁祸首,我们使用 TokenizedBytes 数据加载器在我们的内部 SmolLM2 框架上启动了相同的配置。使用相同数据集,在 48 个节点上没有出现任何骤降。
最快的解决方案:将这个数据加载器复制到 Nanotron 中。骤降消失了,吞吐量恢复到目标水平。
我们准备重新启动……直到下一个变数出现。
谜题 #3——嘈杂的损失
使用新数据加载器后,我们没有再遇到吞吐量骤降,但损失曲线(loss curve)看起来更嘈杂了。
nanosets 曾产生更平滑的损失,这一差异让我们想起了一场古老的调试大战:几年前,我们在预训练代码中发现了一个 shuffle(随机打乱)错误,文档被打乱了,但批次内的序列没有,导致出现小幅骤升。
检查我们的新数据加载器证实了这一点:它从每个文档中顺序读取序列。对于短文件来说这没问题,但对于代码等领域,一个单独的长低质量文件可能填满整个批次并导致损失骤升。
修复 #3——在序列级别进行打乱
我们有两个选择:
- 修改数据加载器以进行随机访问(风险:更高的内存使用量)。
- 离线预先打乱词元化序列。
鉴于开始训练的时间压力以及集群预留的倒计时,我们选择了选项 #2 作为更安全、更快速的修复方案。词元化数据已在每个节点上,因此本地重新打乱成本很低(约 1 小时)。我们使用不同的随机种子为每个轮次(epoch)生成了打乱后的序列,以避免在各个轮次之间重复打乱模式。
When facing urgent deadlines, it might be faster to adopt a proven solution or quick workaround than to debug your own broken implementation. Earlier, we plugged in the TokenizedBytes dataloader rather than fixing the index implementation in nanosets . Here, we chose offline pre-shuffling over dataloader changes. Be careful about taking too many shortcuts, though, or you’ll end up with a patchwork system that’s hard to maintain or optimize.
第二次启动
至此,我们已具备:
- 稳定的吞吐量(暂存存储 + 备用节点策略)
- 无步数诱发的骤降(
TokenizedBytes数据加载器) - 干净的序列级打乱(按轮次离线预打乱)
我们重新启动了训练。这一次,一切都稳住了。损失曲线平滑,吞吐量稳定,我们终于可以专注于训练本身,而不是疲于应对各种突发状况。
谜题 #4——令人不满意的性能
我们顺利训练了前两天,日志中没有任何问题的迹象。然而,在大约处理了 1 万亿个 token 时,评估结果揭示了一些出人意料的事情。
作为监控工作的一部分,我们会评估中间检查点,并将其与历史训练运行进行比较。例如,我们拥有 SmolLM2(1.7B)使用类似配方训练时的中间检查点,因此可以追踪两个模型在训练相同阶段时的进展情况。结果令人费解:尽管拥有更多参数和更好的数据混合,3B 模型在相同训练阶段的表现却比 1.7B 模型更差。损失仍在下降,基准测试分数也在提升,但提升速度明显低于预期。
鉴于我们已经彻底测试了 SmolLM3 相比 SmolLM2 引入的每个架构和数据变化,我们将注意力转向了训练框架。在两套训练设置之间,只剩下少数几个未经测试的差异。最明显的是张量并行(TP,Tensor Parallelism):SmolLM2 可以放在单个 GPU 上,无需 TP 进行训练,而 SmolLM3 需要 TP=2 才能放入内存。我们之前没有想到要测试这一点,因为 TP 在 3B 消融实验中有所使用,且其结果看起来合理。
修复 #4——最终的修复
为了测试 TP 错误的假设,我们使用与 SmolLM3 完全相同的设置训练了一个 1.7B 模型——相同的架构变化(文档掩码、NoPE)、相同的数据混合、相同的超参数——分别使用和不使用 TP。差异立竿见影:TP 版本的损失持续高于非 TP 版本,下游性能也更低。这证实了我们面临的是一个与 TP 相关的错误。
随后我们详细检查了 TP 实现,比较了来自 TP 和非 TP 运行的权重。问题原来微妙但影响深远:我们在所有 TP rank(秩)上使用了相同的随机种子,而每个 rank 本应使用不同的种子进行初始化。这导致分片(shard)之间的权重初始化出现相关性,从而影响了收敛(convergence)。这个影响并非灾难性的——模型仍在训练并持续改进——但它引入了足够的低效率,足以解释我们在规模上观察到的差距。
以下是错误修复:
diff --git a/src/nanotron/trainer.py b/src/nanotron/trainer.py
index 1234567..abcdefg 100644
--- a/src/nanotron/trainer.py
+++ b/src/nanotron/trainer.py
@@ -185,7 +185,10 @@ class DistributedTrainer:
     ):
         # Set random states
-        set_random_seed(self.config.general.seed)
+        # Set different random seed for each TP rank to ensure diversity
+        tp_rank = dist.get_rank(self.parallel_context.tp_pg)
+        set_random_seed(self.config.general.seed + tp_rank)

+
修复随机种子使每个 TP rank 使用不同种子后,我们重复了消融实验,并确认 TP 和非 TP 运行在损失曲线和下游性能上都已匹配。为了确保没有其他隐藏问题,我们进行了额外的合理性检查:一次 SmolLM2 风格(架构和数据层面)的 3B 参数运行,以及一次单独的 SmolLM3 3B 参数运行,并将两者与 SmolLM2 的检查点进行了比较。结果现在与预期一致:1.7B 的 SmolLM2 表现不如 3B 的 SmolLM2 变体,而后者的表现又被 SmolLM3-3B 超越。
这一调试过程强化了我们之前阐述的核心原则之一:“扎实消融设置的真正价值不仅仅在于构建一个好的模型。当我们主训练运行期间出现问题时(无论我们准备多么充分,这种情况都会发生),我们希望对自己做出的每个决定充满信心,并能够快速识别哪些组件没有经过充分测试,可能正在导致问题。这种准备节省了调试时间,也保护了我们未来的精神健康。”
没有什么比盯着神秘的训练失败、却不知道错误藏在哪里更糟糕的了。因为训练设置中的所有其他组件都已经过验证,我们能够将 TP 确定为唯一合理的原因,并在检测到性能差距后的一天内修复了这个错误。
至此,我们解决了自启动以来浮出水面的一系列意外问题中的最后一个。第三次出发,终成正果:从那时起,剩余的一个月训练相对平稳——就是将数万亿 token 转化为最终模型的稳定工作,中间偶尔因节点故障而重启。
坚守航向
如上一节所示,从消融实验扩展到全规模预训练并不是简单的”即插即用”。它带来了意想不到的挑战,但我们成功地识别并解决了每个问题。本节涵盖大规模训练运行所必需的监控设置和注意事项。我们将回答关键问题:遇到问题后何时应该重启训练?如何处理在训练深入阶段才暴露的问题?哪些指标才真正重要?整个训练过程中数据混合方案是否应该保持固定?
训练监控:超越损失曲线
我们发现张量并行错误的原因,不是损失曲线——它看起来一切正常——而是下游评估落后于预期。此外,拥有 SmolLM2 中间检查点的评估结果至关重要,因为它们给了我们一个早期信号,表明 3B 模型的轨迹不对。因此,如果你在训练大型模型,请尽早开始运行下游评估,如果你在与开源模型进行比较,可以询问作者是否能提供中间检查点。这些可以作为无价的参考点。
在基础设施层面,最重要的指标是吞吐量,以每秒 token 数衡量。对于 SmolLM3,我们预期整个训练过程中吞吐量稳定在 13,500–14,000 tokens/sec 之间,任何持续偏差都是一个红色警报。但吞吐量单独来看是不够的:你还需要持续的硬件健康监控,以预测和检测硬件故障。我们追踪的一些关键指标包括 GPU 温度、内存使用量和计算利用率。我们将这些指标记录到 Grafana 仪表板,并为硬件异常设置了实时 Slack 告警。
修复后重启 vs. 边运行边修复
鉴于我们在处理了 1 万亿 token 后重启了训练,一个重要的问题随之而来:出现问题时是否总需要重启?答案取决于问题的严重程度和根本原因。
在我们的案例中,TP 随机种子错误意味着我们从一开始就走错了方向;一半的权重没有被正确初始化。模型的表现与 SmolLM2 相似,并在相似的节点达到了瓶颈,这意味着我们很可能最终得到一个性能相同但训练成本几乎翻倍的模型。重启是合理的。然而,许多问题可以在运行过程中纠偏,以避免浪费计算资源。最常见的问题是损失骤升(loss spike),即训练损失突然跳增,可能预示着轻微的波动或发散(divergence)。
正如 Stas Bekman 在 Machine Learning Engineering Open Book 中精辟地描述的那样:“训练损失图类似于心跳模式——有好的、有坏的,还有让你应该担心的。”
损失骤升分为两类:
- 可恢复的骤升: 这些骤升可能快速恢复(在骤升后立即恢复),也可能缓慢恢复(需要更多训练步骤才能回到骤升前的轨迹)。通常可以继续训练度过这些骤升。如果恢复非常缓慢,可以尝试回退到之前的检查点,跳过有问题的批次。
- 不可恢复的骤升: 对于这些骤升,模型要么发散,要么在比骤升前更差的性能上停滞。它们需要比简单回退到之前检查点更重大的干预。
虽然我们对训练不稳定性(training instabilities)的理解并不完整,但我们知道它们在规模增大时会变得更加频繁。假设采用了保守的架构和优化器,常见的原因包括:
- 过高的学习率: 会在训练早期引发不稳定,可以通过降低学习率来解决。
- 劣质数据: 这通常是可恢复骤升的主要原因,尽管恢复可能很慢。问题可能在训练深入时出现,当模型遇到低质量数据时。
- 数据与参数状态的交互: PaLM (Chowdhery et al., 2022) 观察到骤升通常源于特定数据批次与模型参数状态的组合,而非单纯是”劣质数据”。在不同检查点上对同样有问题的批次进行训练并不能复现骤升。
- 初始化不当: OLMo 2 (OLMo et al., 2025) 的最新研究表明,从缩放初始化切换到简单正态分布(均值=0,标准差=0.02)可以提高稳定性。
- 精度问题: 虽然现在已经没有人用 FP16 训练了,但 BLOOM 发现它与 BF16 相比极不稳定。
你可以怎么做?
在骤升发生之前,建立稳定性
采用保守学习率和良好数据的小模型很少出现骤升,但较大的模型需要主动采取稳定性措施。随着越来越多的团队在规模上进行训练,我们积累了一套有助于防止训练不稳定性的技术。这些包括:
- 数据过滤和打乱: 到目前为止,你已经注意到我们多少次兜兜转转回到数据话题。确保你的数据干净且充分打乱可以防止骤升。例如,OLMo 2 发现删除含有重复 n-gram(1 到 13 个 token 的跨度重复 32 次以上)的文档,显著降低了骤升频率。
- 训练修改: Z-loss 正则化可以防止输出 logit 增长过大,同时不影响性能。从权重衰减(weight decay)中排除嵌入层(embeddings)也有帮助。
- 架构变化: QK-norm(在注意力之前对查询(query)和键(key)投影进行归一化)已被证明是有效的。OLMo2 和其他团队发现它有助于稳定性,有趣的是,Marin 团队发现它甚至可以在训练过程中途应用,以修复发散问题。
当骤升仍然发生时——损害控制
即使有了这些预防措施,骤升仍然可能发生。以下是一些修复选项:
- 跳过有问题的批次: 回退到骤升之前并跳过有问题的批次。这是修复骤升最常见的方法。Falcon 团队 (Almazrouei et al., 2023) 跳过了 10 亿个 token 来解决他们的骤升问题,而 PaLM 团队 (Chowdhery et al., 2022) 发现跳过骤升位置附近 200–500 个批次可以防止复发。
- 收紧梯度裁剪(gradient clipping): 临时降低梯度范数阈值。
- 应用架构修复: 如上所述,QK-norm 可能有效。
我们已经回顾了所遇到的规模化挑战(从吞吐量骤降到 TP 错误)、尽早发现问题的监控实践,以及防止和修复损失骤升的策略。我们将通过讨论多阶段训练如何提升模型最终性能来结束本章。
中途训练
现代大型语言模型(LLM)预训练通常涉及多个阶段,每个阶段使用不同的数据混合方案,通常还会跟随一个扩展上下文长度的最终阶段。例如,Qwen3 (A. Yang, Li, et al., 2025) 采用三阶段方法:在 4k 上下文长度下对 30 万亿 token 进行通用阶段训练、强调 STEM 和编程的 5 万亿高质量 token 推理阶段,以及最后在 32k 上下文长度下对数千亿 token 进行长上下文阶段。SmolLM3 遵循类似的理念,包含有计划的干预措施(引入更高质量的数据集并扩展上下文),以及基于性能监控的响应式调整。
正如我们在上一章中解释的,数据混合方案不必在整个训练过程中保持固定。多阶段训练允许我们随着训练的进行策略性地调整数据集比例。一些干预措施从一开始就计划好了:对于 SmolLM3,我们知道我们会在阶段 2 引入更高质量的 FineMath4+ 和 Stack-Edu,然后在最终衰减阶段加入精选的问答(Q&A)和推理数据。其他干预措施是响应式的,由训练期间的性能监控驱动。例如,在 SmolLM2 中,当我们发现数学和代码性能落后于目标时,我们精心整理了全新的数据集(FineMath 和 Stack-Edu),并在训练中途引入了它们。这种灵活性——无论是遵循计划好的课程表,还是适应新出现的差距——正是让我们能够最大化计算预算价值的关键。
第 2 阶段和第 3 阶段的数据混合
下图展示了我们的三个训练阶段以及训练过程中网页/代码/数学比例的变化情况。每个阶段的 SmolLM3 训练配置(包含精确的数据权重)可在 SmolLM GitHub 仓库中找到。有关每个阶段构成背后的基本原理的更多详情,请参阅”数据精心整理的艺术”。
阶段 1——基础训练(8 万亿 token,4k 上下文): 基础阶段使用我们的核心预训练混合方案:来自 The Stack v2 和 StarCoder2 的网页数据(FineWeb-Edu、DCLM、FineWeb2、FineWeb2-HQ)、代码,以及来自 FineMath3+ 和 InfiWebMath3+ 的数学数据。所有训练在 4k 上下文长度下进行。
阶段 2——高质量注入(2 万亿 token,4k 上下文): 在这一阶段,我们引入了更高质量的过滤数据集,包括用于代码的 Stack-Edu、用于数学的 FineMath4+ 和 InfiWebMath4+,以及用于高级数学推理的 MegaMath(我们还添加了 Qwen 问答数据、合成改写和文本-代码交织块)。
阶段 3——带推理和问答数据的学习率衰减(1.1 万亿 token,4k 上下文): 在学习率衰减阶段,我们进一步上采样(upsample)高质量代码和数学数据集,同时引入指令(instruction)和推理数据,如 OpenMathReasoning、OpenCodeReasoning 和 OpenMathInstruct。问答样本简单地进行拼接,并用换行符分隔。
长上下文扩展:从 4k 到 128k Token
上下文长度决定了你的模型可以处理多少文本。这对于分析长文档、维持连贯的多轮对话以及处理整个代码库等任务至关重要。SmolLM3 最初在 4k token 下训练,但我们需要扩展到 128k 以满足实际应用需求。
为什么要在训练中途扩展上下文?
从一开始就在长上下文上训练在计算上非常昂贵,因为注意力机制(attention mechanisms)随序列长度呈二次方扩展。此外,研究表明,在训练结束时或持续预训练(continual pretraining)期间,用几十到一百亿 token 扩展上下文,就足以达到良好的长上下文性能 (Gao et al., 2025)。
顺序扩展:4k → 32k → 64k
我们没有直接跳到 128k。而是分阶段逐步扩展上下文,让模型在进一步扩展之前有时间适应每个长度。我们运行了两个长上下文阶段:首先从 4k 增加到 32k,然后从 32k 增加到 64k(128k 能力来自推理时的外推(extrapolation),而不是训练)。我们发现,为每个阶段在 500 亿 token 上重新开始一个学习率调度,比在主衰减阶段最后 1000 亿 token 扩展上下文效果更好。在每个阶段,我们都进行了消融实验,以找到良好的长上下文数据混合和 RoPE theta 值,并在 RULER 基准测试上进行了评估。
During the long context ablations, we found the HELMET benchmark to be very noisy on base models (the same training with different seeds gives variable results). Gao et al. (2025) recommend doing supervised fine-tuning on top to reduce variance on the benchmarks’ tasks. We instead we opted for RULER, which we found to give more reliable signal at the base model level.
在这个阶段,通常需要上采样长上下文文档(如长篇网页和书籍)以提高长上下文性能 (Gao et al., 2025)。我们运行了几次消融实验,对书籍、文章,甚至合成生成的文档(用于检索和填空等任务)进行上采样,遵循 Qwen2.5-1M 的方法 (A. Yang, Yu, et al., 2025),使用 FineWeb-Edu 和 Python-Edu。令人惊讶的是,与仅使用阶段 3 的基线混合方案相比,我们没有观察到任何改进,而基线混合方案在 RULER 上已经与 Llama 3.2 3B 和 Qwen2.5-3B 等其他最先进模型具有竞争力。我们推测这是因为基线混合方案自然包含来自网页数据和代码的长文档(估计占 token 的 10%),以及使用 NoPE 有所帮助。
带调整基频的 RoPE(ABF,Adjusted Base Frequency)
当上下文长度从 4k 扩展到 32k 时,我们将 RoPE 基频(theta)增加到 2M;从 32k 扩展到 64k 时,我们将其增加到 5M。我们发现使用更大的值(如 10M)略微改善了 RULER 分数,但损害了一些短上下文任务(如 GSM8k),因此我们保持在 5M,这不会影响这些任务。
在这个上下文扩展阶段,我们还借机进一步上采样了数学、代码和推理问答数据,并添加了几十万条 ChatML 格式的样本。
YARN 外推:达到 128k
我们希望 SmolLM3 在推理时能够处理 128k,但在 128k 序列上训练的代价过于高昂。作为替代,我们使用了 YARN(Yet Another RoPE extensioN,又一种 RoPE 扩展方法)(B. Peng et al., 2023),它允许模型在训练长度之外进行外推。
理论上,YARN 允许序列长度增加四倍。我们发现使用 64k 检查点在 128k 下的表现优于使用 32k 检查点,这证实了训练时长度越接近目标推理长度越有利。然而,推进到 256k(4 × 64k)显示出 RULER 性能下降,因此我们建议仅将模型用于 128k 以内的场景。
至此,我们已经走过了 SmolLM3 完整的预训练历程,从规划和消融实验,到最终的训练运行,以及其中一路涌现的幕后挑战。
预训练收尾
我们涵盖了大量内容:从帮助决定为何训练以及训练什么的训练指南针,到验证每个架构选择的战略规划和系统性消融实验,再到实际的训练马拉松——在我们的案例中,意外在规模化后接连出现(吞吐量神秘崩溃、数据加载器瓶颈,以及一个微妙的张量并行错误,迫使我们在处理了 1 万亿 token 后重启)。
那些精致的技术报告背后凌乱的现实如今已清晰可见:训练 LLM 既需要规范的实验和快速的调试,也需要架构创新和数据精心整理。 规划确定了什么值得测试,消融实验验证每个决策,监控及早发现问题,而当事情不可避免地崩溃时,系统性的风险消除告诉你应该去哪里找问题。
具体到 SmolLM3,这个过程实现了我们最初设定的目标:一个在 11 万亿 token 上训练的 3B 模型,在数学、代码、多语言理解和长上下文任务上具有竞争力,处于 Qwen3 系列模型的帕累托前沿(Pareto frontier)。
基础模型检查点已保存,训练也已完成,我们可能会想就此打住。毕竟,我们拥有一个能够很好地预测文本、在基准测试上取得强劲分数,并展示了我们所追求能力的模型。一切就绪,对吧?
还没有。因为今天人们想要的是助手和编程智能体(coding agents),而不是原始的下一个 token 预测器。
这正是后训练(post-training)的用武之地。就像预训练一样,现实比你想象的更为复杂。
超越基座模型——2025 年的 Post-Training(后训练)
一旦预训练完成,我们应该能在一天之内得到一个 SFT 基线。
预训练赋予了 SmolLM3 原始的能力,但在 GPU 还没冷却下来之前,我们就进入了模型能力的下一个前沿: post-training(后训练) 。这包括监督微调(supervised fine-tuning)、强化学习(reinforcement learning)、模型合并(model merging)等等——所有这些都旨在弥合「一个会预测文本的模型」与「一个人们真正能用的模型」之间的鸿沟。如果说预训练是把知识硬塞进权重里,那么后训练就是把这种原始能力雕琢成可靠且可控的东西。而再一次地,那些打磨光鲜的后训练论文并没有捕捉到深夜里的那些意外:GPU 过热熔毁、挑剔的数据混合(data mixture),或是一个看似微不足道的 chat template(聊天模板)决策如何在下游 benchmark(基准测试)上层层传导。在本章中,我们将展示我们如何在杂乱无章的后训练世界中摸索前行,将 SmolLM3 从一个强大的基座模型转变为最先进(state-of-the-art)的混合推理模型(hybrid reasoner)。
混合推理模型(hybrid reasoning model)有两种截然不同的工作模式:一种用于简洁、直接的回答,另一种用于扩展的逐步推理。通常,工作模式由用户在 system message(系统消息)中设定。沿用 Qwen3 的做法,我们用轻量级命令将其显式化:“/think” 触发扩展推理,而 “/no_think” 强制简洁回答。这样,用户就能控制模型是优先考虑深度还是速度。
后训练罗盘:Why → What → How
就像预训练一样,后训练也能从一个清晰的罗盘中受益,以避免浪费研究和工程上的迭代周期。下面是构建它的方式:
-
为什么要做后训练(Why post-train)? 我们在预训练罗盘中概括的三大训练动机同样适用于后训练。例如,你可能正在探索强化学习是否能在现有模型中解锁新的推理能力(研究),或者你可能因为延迟原因需要把一个大模型蒸馏成一个小模型(生产),又或者你发现了某个特定用例尚无强大开源模型可用的空白(战略性开源)。其区别在于,后训练是在现有能力的基础上构建,而非从零创造。但在你伸手去碰 GPU 之前,先问问自己:
- 你真的需要后训练吗?如今许多开放权重(open-weight)模型在广泛的任务上已经能与专有模型相媲美。有些甚至可以通过量化(quantization)和适度算力在本地运行。如果你想要一个通用型助手,Hugging Face Hub 上一个现成的模型可能已经能满足你的需求。
- 你能获取高质量的领域专属数据吗?当你瞄准一个通用模型表现不佳的特定任务或领域时,后训练才最有意义。有了合适的数据,你可以调优模型,使其为你最关心的应用产出更准确的输出。
- 你能衡量成功吗?没有清晰的评测标准,你就无法知道后训练是否真的有帮助。
-
后训练应该达成什么(What should post-training achieve)? 这取决于你的优先级。你想要的是:
- 一个很少偏离主题、严守指令的模型?
- 一个能按需切换语气和角色的多面手助手?
- 一个能攻克数学、代码或 agentic(智能体)问题的推理引擎?
- 一个能用多种语言对话的模型?
-
你将如何到达那里(How will you get there)? 这就是 recipe(配方)发挥作用的地方。我们将涵盖:
- 监督微调(Supervised fine-tuning, SFT) 用于灌输核心能力
- 偏好优化(Preference optimization, PO) 用于直接从人类或 AI 偏好中学习
- 强化学习(Reinforcement learning, RL) 用于超越监督数据,进一步精炼可靠性和推理能力
- 数据策展(Data curation) 用于在多样性和质量之间取得恰当的平衡
- 评测(Evaluation) 用于追踪进展并及早发现性能回退
这个罗盘让后训练的混乱有了落脚点。 why 给出方向, what 设定优先级, how 则把雄心壮志转化为一个切实可行的训练循环。
让我们来看看我们是如何为 SmolLM3 回答这些问题的:
- Why? 对我们来说,“why” 很直白,因为我们有一个在发布前需要后训练的基座模型。与此同时,像 Qwen3 这样的混合推理模型正变得越来越流行,然而展示如何训练它们的开放配方却很稀缺。SmolLM3 给了我们一个同时实现两个目标的机会:为现实世界使用准备一个模型,并贡献一份完全开放的配方,使其与 Qwen3 的 1.7B 和 4B 模型一同站在帕累托前沿(Pareto front)上。
- What? 我们着手训练一个为 SmolLM3 的优势量身定制的混合推理模型,主要的优势在于推理质量应当在英语以外的语言中也能保持。而且由于现实世界的使用越来越多地涉及 tool calling(工具调用)和长上下文(long context)工作流,这些就成了我们后训练配方中的核心需求。
- How? 这就是你将在本章余下部分中找到的答案!
就像预训练一样,后训练也是从基础、评测和基线开始的,因为每个大模型都始于一次小的消融实验(ablation)。但在消融的方式上有一个关键区别。在预训练中,“小”通常意味着更小的模型和数据集。在后训练中,“小”意味着更小的数据集和 更简单 的 算法 。我们几乎从不用一个不同的基座模型来做消融,因为行为太依赖于具体模型,而且训练运行足够短,可以直接在目标模型上迭代。
让我们从一个许多模型训练者直到项目太晚才去面对的话题开始:评测。
首要之事:评测先于一切
后训练的第一步——就像预训练一样——是决定一套正确的评测。由于当今大多数 LLM 都被用作助手,我们发现,瞄准一个”好用”的模型,比追逐像 ARC-AGI 那样抽象的”智能”基准更好。那么,一个好的助手需要做什么呢?至少,它应该能够:
- 处理含糊的指令
- 逐步规划
- 编写代码
- 在适当的时候调用工具
这些行为依赖于推理、长上下文处理,以及数学、代码和工具使用方面技能的综合运用。参数量在 3B 甚至更小的模型也能很好地胜任助手角色,不过当低于 1B 时,性能通常会急剧下滑。
在 Hugging Face,我们使用一套分层的评测套件,呼应我们在消融章节中详述的预训练原则(单调性、低噪声、高于随机的信号、排序一致性)。
随着模型的改进,可供考虑的评测列表也在不断演变。这里讨论的这些反映了我们在 2025 年年中的关注重点。关于后训练评测的全面概述,请参见 LLM 评测指南手册(Evaluation Guidebook)。
评测一个后训练模型有很多方法。这些方法包括:
-
能力评测(Capability evals)。 这一类评测瞄准基础技能:
- 知识: 我们目前使用 GPQA Diamond (Rein et al., 2024) 作为科学知识的主要评测。这个 benchmark 由研究生水平的多选题组成。对于小模型而言,它远未饱和,并且比 MMLU 之类提供更好的信号,同时运行速度快得多。另一个不错的事实性测试是 SimpleQA (Wei et al., 2024),尽管小模型由于知识有限,往往在这个 benchmark 上表现得相当吃力。
- 数学: 为了衡量数学能力,当今大多数模型都在最新版本的 AIME(目前是 2025 版)上进行评测。MATH-500 (Lightman et al., 2023) 对小模型来说仍是一个有用的健全性测试(sanity test),但它已基本被推理模型饱和。要获得一套更全面的数学评测,我们推荐来自 MathArena 的那些。
- 代码: 我们使用最新版本的 LiveCodeBench 来追踪编程能力。尽管它针对的是竞赛编程问题,我们发现 LiveCodeBench 上的提升确实能转化为更好的编程模型,尽管仅限于 Python。SWE-bench Verified 是一个更复杂的编程技能衡量标准,但它对小模型而言往往太难,因此通常不在我们的考量范围内。
- 多语言能力: 不幸的是,在测试模型的多语言能力时,可选项并不多。我们目前依赖 Global MMLU (Singh et al., 2025) 来瞄准我们的模型应当表现良好的主要语言,并纳入 MGSM (Shi et al., 2022) 作为多语言数学能力的测试。
-
集成任务评测(Integrated task evals)。 这些评测测试的能力,与我们希望交付的那些相似:
- 长上下文使用: 长上下文检索最常用的测试是 Needle in a Haystack(NIAH,大海捞针)(Kamradt, 2023),其中一个随机事实(“针”)被放置在一个长文档(“草堆”)的某处,模型必须把它检索出来。然而,这个 benchmark 太过表层,无法区分长上下文理解能力,因此社区开发了更全面的评测,比如 RULER (Hsieh et al., 2024) 和 HELMET (Yen et al., 2025)。最近,OpenAI 发布了 MRCR 和 GraphWalks 这两个 benchmark,进一步扩展了长上下文评测的难度。
- 指令遵循(Instruction following): IFEval (J. Zhou et al., 2023) 目前是衡量指令遵循最流行的评测;它使用针对”可验证指令”的自动评分。IFBench (Pyatkin et al., 2025) 是 Ai2 推出的一个扩展,它包含比 IFEval 更多样的约束集,并缓解了近期一些模型发布中出现的 benchmaxxing1(刷榜)。对于多轮指令遵循,我们推荐 Multi-IF (He et al., 2024) 或 MultiChallenge (Sirdeshmukh et al., 2025)。
- 对齐(Alignment): 衡量模型与用户意图对齐的程度,通常由人工标注者完成,或者通过 LMArena 这样的公开排行榜进行。这是因为自由形式生成、风格和整体有用性等品质,很难用自动化指标进行定量衡量。然而,运行这些评测非常昂贵,这就是为什么社区转而使用 LLM 作为人类偏好的代理。这类最流行的 benchmark 包括 AlpacaEval (Dubois et al., 2025)、ArenaHard (T. Li et al., 2024) 和 MixEval (Ni et al., 2024),其中后者与 LMArena 上的人类 Elo 评分相关性最强。
- 工具调用(Tool calling): 伯克利函数调用排行榜(Berkeley Function Calling Leaderboard, BFCL) 提供了一个全面的工具调用测试,尽管它往往很快就被饱和。TAU-Bench (Barres et al., 2025) 测试模型在模拟客服场景中使用工具并解决用户问题的能力,也已成为一个流行的报告基准。
- 过拟合预防评测(Overfitting prevention evals)。 为了测试我们的模型是否对某个特定技能过拟合,我们在评测集中纳入了一些鲁棒性或适应性评测,比如 GSMPlus (Q. Li et al., 2024),它对 GSM8k (Cobbe et al., 2021) 中的问题进行扰动,以测试模型是否仍能解决相似难度的问题。
- 内部评测(Internal evals)。 尽管公开 benchmark 在模型开发期间能提供一些有用的信号,但它们无法替代你实现自己的内部评测来瞄准特定能力,或请内部专家与你的模型互动。例如,对于 SmolLM3,我们需要一个 benchmark 来评估模型是否具备多轮推理能力,于是我们实现了一个 Multi-IF 的变体来衡量这一点。
- 氛围评测与竞技场(Vibe evals and arenas)。 类似地,我们发现对中间检查点(checkpoint)进行”氛围测试(vibe testing)“(即与模型互动)对于发现评测分数未能捕捉的模型行为中的微妙怪癖至关重要。正如我们稍后讨论的,氛围测试发现了我们数据处理代码中的一个 bug——所有 system message 都从语料库中被删除了!这件事也可以大规模进行,以衡量人类偏好,比如在流行的 LMArena 上。然而,众包的人类评估往往很脆弱(偏好谄媚和华丽辞藻而非实际有用性),所以重要的是把它视为一种低信号的反馈。
依赖公开 benchmark 的一个风险是,模型很容易对它们过拟合,尤其是当使用合成数据来生成与目标 benchmark 相似的 prompt 和 response 时。出于这个原因,对你将用来指导模型开发的评测,对训练数据进行去污染(decontaminate)是至关重要的。你可以用 n-gram 匹配来做这件事,使用的脚本如 Open-R1 中的那些。
对于 SmolLM3,我们想要一个混合推理模型,它能可靠地遵循指令,并在数学和代码等流行领域中推理良好。我们还想确保保留了基座模型的多语言和长上下文检索能力。
这引导我们得出以下这套评测:
| Benchmark | 类别 | Prompt 数量 | 指标 |
|---|---|---|---|
| AIME25 | 竞赛数学 | 30 | avg@64 |
| LiveCodeBench v4(最终发布版用 v5) | 竞赛编程 | 100(268) | avg@16 |
| GPQA Diamond | 研究生水平推理 | 198 | avg@8 |
| IFEval | 指令遵循 | 541 | Accuracy |
| MixEval Hard | 对齐 | 1000 | Accuracy |
| BFCL v3 | 工具使用 | 4441 | Mixed |
| Global MMLU(验证用 lite 版) | 多语言问答 | 590,000(6,400) | Accuracy |
| GSMPlus(验证用 mini 版) | 鲁棒性 | 10,000(2,400) | Accuracy |
| RULER | 长上下文 | 6,500 | Accuracy |
让我们看几个示例问题,以便对这些评测实际测试什么有一个具体的感受。
你可以在交互式查看器中浏览这些示例,看看每个 benchmark 中的问题类型。注意领域的多样性如何确保我们在整个消融过程中测试了模型能力的不同方面。
对于我们当时所用的 3B 模型规模,我们觉得这些评测(运行起来比训练本身还快)能给我们提供可付诸行动的信号,并让我们有信心相信任何改进都是真实的,而不仅仅是采样带来的噪声。我们还追踪了我们的预训练评测(完整列表见消融章节),以确保我们在基座模型性能上没有回退太多。
上面的叙述让人觉得我们作为一个团队聚在一起,对这套评测达成了共识,并在开始训练之前就把它们准备好了。现实要混乱得多:我们有一个紧迫的截止日期,在上述许多评测实现之前就匆忙推进了模型训练(例如,RULER 直到模型发布前几天才可用 🙈)。事后看来,这是个错误;我们本应与预训练团队讨论哪些核心评测应当在后训练中保留,并在基座模型训练完成之前就早早地优先实现它们。换句话说,要优先于一切地确定你的评测!
交战规则
让我们用几条历经千辛万苦、通过评测数千个模型才学到的教训来总结这一节:
- 使用 小子集 来加速模型开发期间的评测。例如,LiveCodeBench v4 与 v5 高度相关,但运行时间只有一半。或者,使用 tinyBenchmarks (Polo et al., 2024) 中的方法,它寻找能可靠匹配完整评测的最小 prompt 子集。
- 对于 推理模型 ,从 被评分 的输出中剥离思维链(chain of thought)。这能消除假阳性,也直接影响像 IFEval 这样的 benchmark——它会惩罚违反约束(如”用不到 50 个词写一首诗”)的回答。
- 如果某个评测使用 LLM 评判者(judge),就 固定评判者及其版本 ,以便随时间进行同类对比。更好的做法是,使用一个开放权重模型,这样即使某个供应商弃用了评判模型,评测仍然可复现。
- 警惕基座模型中的 污染(contamination) 。例如,大多数在 AIME 2025 之前发布的模型在该测试上的表现明显差于 AIME 2024,这表明存在某种刷榜行为。
- 如果可能,把消融期间使用的任何东西都视为 验证集(validation) ,而非 测试集(test)。 这意味着为最终模型报告保留一套留出(held-out)的 benchmark,类似于 Tulu 3 评测框架 (Lambert et al., 2025)。
- 始终在你自己的数据和任务上纳入一小套 “氛围评测(vibe evals)” ,以捕捉对公开套件的过拟合。
- 对于问题数量较少的评测(通常少于约 2k 个),采样
k次并报告avg@k准确率。这对于缓解噪声很重要,否则噪声可能在开发期间导致错误决策。 - 实现一个新评测时,确保你能 复现几个模型已发表的结果(在一定误差范围内)。如果做不到这一点,一旦你后面需要修复实现并重新评测许多检查点,就可能浪费大量时间。
- 当存疑时,总是要 回到评测数据本身 ,检查你究竟在用什么来提示你的模型。
有了评测,是时候训练一些模型了!但在那之前,我们需要挑选一个后训练框架。
行业利器
每一个后训练配方的背后,都有一个由框架和库组成的工具箱,它们使得大规模实验成为可能。每个框架都带来了它自己支持的算法、微调方法和可扩展性特性。下表总结了主要的支持领域,从监督微调到偏好优化和强化学习:
| 框架 | SFT | PO | RL | 多模态 | FullFT | LoRA | 分布式 |
|---|---|---|---|---|---|---|---|
| TRL | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Axolotl | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| OpenInstruct | ✅ | ✅ | ✅ | ❌ | ✅ | ✅ | ✅ |
| Unsloth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| vERL | ✅ | ❌ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Prime RL | ✅ | ❌ | ✅ | ❌ | ✅ | ✅ | ✅ |
| PipelineRL | ❌ | ❌ | ✅ | ❌ | ✅ | ✅ | ✅ |
| ART | ❌ | ❌ | ✅ | ❌ | ❌ | ✅ | ❌ |
| TorchForge | ✅ | ❌ | ✅ | ❌ | ✅ | ❌ | ✅ |
| NemoRL | ✅ | ✅ | ✅ | ❌ | ✅ | ❌ | ✅ |
| OpenRLHF | ✅ | ✅ | ✅ | ❌ | ✅ | ✅ | ✅ |
这里, FullFT 指的是 全量微调(full fine-tuning) ,即训练期间更新所有模型参数。 LoRA 代表 低秩适配(Low-Rank Adaptation) ,一种参数高效(parameter-efficient)的方法,它只更新小的低秩矩阵,同时保持基座模型冻结。 多模态(Multi-modal) 指的是是否支持在文本以外的模态(例如图像)上训练,而 分布式(Distributed) 表示是否能在多于一个 GPU 上训练模型。
在 Hugging Face,我们开发并维护 TRL,所以它是我们的首选框架,也是我们用来对 SmolLM3 进行后训练的框架。
鉴于这个领域日新月异的节奏,我们发现,在一个内部 fork 的 TRL 上运行实验相当有效。这让我们能非常快速地添加新特性,之后再将其上游(upstream)合并回主库。如果你能熟练地处理框架的内部细节,采用类似的工作流可以成为快速迭代的强大方式。
为什么还要费心用框架?
有那么一类研究者,热衷于抱怨使用训练框架,并主张你应该始终从零实现一切。这里隐含的论点是,“真正的”理解只能来自重新实现每一个 RL 算法、手动编写每一个分布式训练原语,或者东拼西凑出一个一次性的评测框架。
但这种立场忽视了现代研究和生产的现实。以 RL 为例。像 PPO 和 GRPO 这样的算法是出了名的难以正确实现 (Huang et al., 2024),而在归一化或 Kullback–Leibler(KL)惩罚项上的微小错误,都可能导致数天的算力和精力白白浪费。
类似地,尽管为某个算法写一个单文件实现可能很诱人,但同一个脚本能从 1B 扩展到 100B+ 参数吗?
框架的存在恰恰是因为基础已经被充分理解了,没完没了地重新发明它们是对时间的拙劣利用。这并不是说低层次的折腾没有价值。从零实现一次 PPO 是一个绝佳的学习练习。不用框架写一个玩具 transformer 能教会你 attention 究竟是如何工作的。但在大多数情况下,你最好就挑一个你喜欢的框架,然后为你的目的去魔改(hack)它。
发完这通牢骚之后,让我们来看看我们的训练运行通常从哪里开始。
为什么(几乎)每个后训练流程都从 SFT 开始
如果你最近在 X 上花点时间,你大概会觉得强化学习是唯一的玩家。每天都有新的缩写词、算法上的微调,以及关于 RL 究竟能否激发新能力的激烈辩论 (Chu et al., 2025; Yue et al., 2025)。
当然,RL 并不新鲜。OpenAI 和其他实验室在对齐他们的早期模型时,曾大量依赖从人类反馈中进行强化学习(RLHF)(Lambert et al., 2022),但直到 DeepSeek-R1 (DeepSeek-AI, Guo, et al., 2025) 发布,基于 RL 的后训练才真正在开源生态中流行起来。
不过,有一件事没有改变:几乎每个有效的后训练流程仍然从监督微调开始。原因很直接:
- 它便宜: 与 RL 相比,SFT 需要的算力适中。你通常无需烧掉一大堆硅片就能获得有意义的收益,而且所需时间只是 RL 的一小部分。
- 它稳定: 不像 RL 那样对奖励设计和超参数出了名地敏感,SFT “就是好使”。
- 它是正确的基线: 一个好的 SFT 检查点通常能给你带来你想要的大部分收益,而且它能让后续方法(如 DPO 或 RLHF)有效得多。
在实践中,这意味着 SFT 之所以是第一步,不仅仅因为它简单;而是因为它是那个能持续提升性能的步骤,在尝试任何更复杂的东西之前都最合理。当你处理基座模型时尤其如此,因为基座模型——除了少数例外——太过粗糙,无法从高级后训练方法中受益。
在前沿地带,从 SFT 开始的常规理由并不总是成立。没有更强的模型可供蒸馏,而人类标注对于像长思维链推理这样的复杂行为又太过嘈杂。这就是为什么 DeepSeek 跳过了 SFT,直接用 R1-Zero 进行 RL;目的是去 发现 那些无法用标准监督来教授的推理行为。
如果你身处那种境地,从 RL 开始是有道理的。但如果你真在那种境地操作,你大概也不会读这篇文章了。
那么,如果说大多数流程从 SFT 开始,下一个问题就是: 该 微调什么?这要从选择正确的基座模型开始。
挑选一个基座模型
为后训练选择基座模型时,有几个实际维度最为重要:
- 模型大小: 尽管 smol(小)模型随时间已经显著改进,但直到今天,更大的模型泛化得更好仍然成立,而且往往用更少的样本就能做到。选择一个能代表你计划在训练后如何使用或部署模型的大小。在 Hugging Face Hub 上,你可以按模态和大小筛选模型,找到合适的候选者。
- 架构(MoE vs. dense): MoE(专家混合)模型每个 token 激活参数的一个子集,提供了更高的单位算力容量。它们非常适合大规模服务(serving),但根据我们的经验,更难微调。相比之下,dense(稠密)模型训练起来更简单,且在较小规模下往往优于 MoE。
- 后训练履历: Benchmark 很有用,但如果基座模型已经催生了一批与社区共鸣的强大后训练模型,那就更好了。这为模型是否好训练提供了一个代理指标。
根据我们的经验,来自 Qwen、Mistral 和 DeepSeek 的基座模型最易于进行后训练,其中 Qwen 是明显的最爱,因为每个模型系列通常都覆盖了很大的参数范围(Qwen3 模型大小从 0.6B 到 235B 不等!)。这一特性让规模扩展(scaling)变得直接得多。
一旦你选好了一个符合你部署需求的基座模型,下一步就是建立一个简单、快速的 SFT 基线,来探测它的核心技能。
训练简单基线
对于 SFT,一个好的基线应当训练得快、聚焦于模型的核心技能,并且在某项能力不达标时易于用更多数据扩展。选择哪些数据集来做初始基线,需要一些品味,以及对那些很可能高质量的数据集的熟悉。一般来说,避免过度看重那些在学术 benchmark 上报告高分的公开数据集,而是聚焦于那些被用来训练优秀模型的数据集,比如 OpenHermes。例如,在 SmolLM 的开发中,我们最初在 WebInstruct 上运行 SFT,这在纸面上是个很棒的数据集。然而,在我们的氛围测试中,我们发现它太偏向科学了——对于像”你好吗?“这样简单的问候,模型会用方程式来回应。
这促使我们创建了 Everyday Conversations 数据集,事实证明,它对于给小模型灌输基本的聊天能力至关重要。
对于 SmolLM3,我们着手训练一个混合推理模型,并最初挑选了一小套数据集,瞄准推理、指令遵循和可控性(steerability)。下表展示了每个数据集的统计信息:2
| Dataset | Reasoning Mode | # of Examples | % of Examples | # of Tokens (M) | % of Tokens | Avg. # of Tokens per Example | Avg. # of Tokens in Context | Avg. # of Tokens in Response | Avg. # of Turns |
|---|---|---|---|---|---|---|---|---|---|
| Everyday Conversations | /no_think | 2,260 | 2.3 | 0.6 | 0.8 | 260.2 | 222.3 | 94.0 | 7.8 |
| SystemChats 30k | /no_think | 33,997 | 35.2 | 21.5 | 28.2 | 631.9 | 422.8 | 267.7 | 6.3 |
| Tulu 3 SFT Personas IF | /no_think | 29,970 | 31.0 | 13.3 | 17.5 | 444.5 | 119.8 | 380.7 | 2 |
| Everyday Conversations (Qwen3-32B) | /think | 2,057 | 2.1 | 3.1 | 4.1 | 1,522.4 | 376.8 | 1,385.6 | 4 |
| SystemChats 30k (Qwen3-32B) | /think | 27,436 | 28.4 | 29.4 | 38.6 | 1070.8 | 84.6 | 1,042.7 | 2 |
| s1k-1.1 | /think | 835 | 0.9 | 8.2 | 10.8 | 8,859.3 | 370.9 | 9,728.5 | 2 |
| Total | - | 96,555 | 100.0 | 76.1 | 100.0 | 2,131.5 | 266.2 | 2,149.9 | 4.0 |
正如我们在 SmolLM3 的整个开发过程中所学到的,训练混合推理模型比标准 SFT 更棘手,因为你不能只是把数据集混在一起;你需要跨模式 配对(pair) 数据。每个示例都必须清楚地标明模型应当进行扩展推理还是给出简洁的回答,而且理想情况下,你想要平行的示例来教会它何时切换模式。从这张表中要注意的另一件事是,你应当以 token 而非 示例 为单位来平衡你的数据混合:例如,s1k-1.1 数据集占总示例数的约 1%,但由于其冗长的推理回答,却占据了总 token 数的约 11%。
这给了我们在最关心的那些技能上的基本覆盖,但也引入了一个新挑战:每个数据集都必须根据它应该启用扩展思考与否而有不同的格式化方式。为了统一这些格式,我们需要一个一致的 chat template。
挑选一个好的 Chat Template
在选择或设计 chat template 时,并没有一刀切的解决方案。在实践中,我们发现有几个值得事先问清的问题:
- 用户能自定义 system 角色吗? 如果用户应该能够定义他们自己的 system prompt(例如,“扮演一个海盗”),那么模板需要干净利落地处理这一点。
- 模型需要工具吗? 如果你的模型需要调用 API,模板就需要为工具调用和响应容纳结构化输出。
- 它是推理模型吗? 推理模型使用像
<think> ... </think>这样的模板,把模型的”思考”与它的最终答案分隔开。一些模型会在对话的各个回合间丢弃推理 token,而 chat template 需要处理这个逻辑。 - 它能与推理引擎配合工作吗? 像 vLLM 和 SGLang 这样的推理引擎有专门的推理和工具解析器(parser)。3 与这些解析器的兼容性能省去后面很多麻烦,尤其是在那些一致的工具调用至关重要的复杂 agent benchmark 中。4
下表展示了几个流行的 chat template,以及它们在关键考量上的对比:
| Chat Template | System 角色自定义 | 工具 | 推理 | 推理引擎兼容性 | 备注 |
|---|---|---|---|---|---|
| ChatML | ✅ | ✅ | ❌ | ✅ | 简单,适合大多数用例 |
| Qwen3 | ✅ | ✅ | ✅ | ✅ | 混合推理模板 |
| DeepSeek-R1 | ❌ | ❌ | ✅ | ✅ | 用 <think> 预填充推理内容 |
| Llama 3 | ✅ | ✅ | ❌ | ✅ | 内置工具,如 Python 代码解释器 |
| Gemma 3 | ✅ | ❌ | ❌ | ❌ | System 角色自定义在第一个 user 回合定义 |
| Command A Reasoning | ✅ | ✅ | ✅ | ❌ | 每个模型有多个 chat template |
| gpt-oss | ✅ | ✅ | ✅ | ✅ | 基于 Harmony response format;复杂,但多功能 |
在大多数情况下,我们发现 ChatML 或 Qwen 的 chat template 是一个绝佳的起点。对于 SmolLM3,我们需要一个用于混合推理的模板,并发现 Qwen3 是少数几个在我们所关心的各个维度上取得良好平衡的模板之一。然而,它有一个我们不太满意的怪癖:除最后一个回合外,所有回合的推理内容都被丢弃了。如下图所示,这与 OpenAI 的推理模型 的工作方式类似:
flowchart LR
    subgraph Turn1 ["Turn 1"]
        T1_Input["**INPUT**"]
        T1_Output["**OUTPUT**"]
    end

    subgraph Turn2 ["Turn 2"]
        T2_Input["**INPUT**"]
        T2_Output["**OUTPUT**"]
    end

    subgraph Turn3 ["Turn 3"]
        T3_Input["**INPUT**"]
        T3_Output1["**OUTPUT**"]
        Reasoning["**REASONING**"]
        T3_Output2_Top["**OUTPUT**"]
        TruncatedOutput["**TRUNCATED OUTPUT**"]
    end

    T1_Input --> T2_Input
    T1_Output --> T2_Input

    T2_Input --> T3_Input
    T2_Output --> T3_Input

    T3_Input --> T3_Output1
    T3_Output1 --> Reasoning
    Reasoning --> T3_Output2_Top

    T3_Output2_Top -->|CONTEXT WINDOW ✂️| TruncatedOutput

    classDef input fill:#e8f5e8,stroke:#4caf50,stroke-width:2px
    classDef output fill:#e3f2fd,stroke:#2196f3,stroke-width:2px
    classDef reasoning fill:#f5f5f5,stroke:#999,stroke-width:1px
    classDef truncated fill:#ffebee,stroke:#f44336,stroke-width:3px
    classDef subgraphStyle fill:#f8f9fa,stroke:#dee2e6,stroke-width:1px
    classDef linkLabel fill:#f8f9fa,stroke:#dee2e6,stroke-width:1px

    class T1_Input,T2_Input,T3_Input input
    class T1_Output,T2_Output,T3_Output1,T3_Output2_Top output
    class Reasoning reasoning
    class TruncatedOutput truncated
    class Turn1,Turn2,Turn3 subgraphStyle
    linkStyle 4 stroke:#333,stroke-width:2px,fill:#f8f9fa
尽管这对于 推理 来说是合理的(为了避免上下文爆炸),但我们得出的结论是,对于 训练 而言,保留所有回合的推理 token 很重要,以便恰当地条件化(condition)模型。
于是,我们决定打造我们自己的 chat template,具备以下特性:
- 一个结构化的 system prompt,类似于 Llama 3 的 以及那些从专有模型中越狱出来的。我们还想提供完全覆盖 system prompt 的灵活性。
- 支持 code agents(代码智能体),它们执行任意 Python 代码而非进行 JSON 工具调用。
- 通过 system message 对推理模式进行显式控制。
为了迭代 chat template 的设计,我们使用了 Chat Template Playground。这个由我们 Hugging Face 的同事开发的便捷应用,让预览消息如何被渲染以及调试格式化问题变得容易。它看起来是这样的:
你可以自己试一试。从下拉菜单中选择不同的示例,看看 chat template 在多轮对话、推理或工具使用时是如何工作的。你甚至可以手动修改 JSON 输入来启用不同的行为。例如,看看如果你提供 enable_thinking: false 或在 system message 后附加 /no_think 会发生什么。
一旦你确定了一些初始数据集和一个 chat template,就该训练一些基线了!
婴儿级基线
在我们一头扎进优化、榨取每一分性能之前,我们需要建立一些”婴儿级基线(baby baselines)“。这些基线并不是为了达到最先进水平(暂时还不是),而是旨在验证 chat template 做了我们想要的事情,并且初始的超参数集能产生稳定的训练。只有在我们有了这个基础之后,才会开始大力调优超参数和训练混合。
谈到训练 SFT 基线,主要需要考虑以下几点:
- 你会使用全量微调,还是像 LoRA 或 QLoRA(量化 LoRA)这样的参数高效方法?正如 Thinking Machines 那篇精彩的博客文章所描述的,在某些条件下(通常由数据集的大小决定),LoRA 能够匹敌 FullFT。
- 你需要哪种类型的并行?对于小模型或用 LoRA 训练的模型,你通常用数据并行(data parallelism)就能应付。对于更大的模型,你将需要 FSDP2 或 DeepSpeed ZeRO-3 来分片(shard)模型权重和优化器状态。对于用长上下文训练的模型,使用像上下文并行(context parallelism) 这样的方法。
- 如果你的硬件支持,就使用像 FlashAttention 和 Liger 这样的 kernel(核)。这些 kernel 中的许多都托管在 Hugging Face Hub 上,并可以在 TRL 中通过一个简单的参数来设置,从而大幅降低 VRAM(显存)的使用。
- 对损失进行掩码以只在 assistant token 上训练。正如我们稍后讨论的,这可以通过用一个特殊的
{% generation %}关键字包裹你 chat template 的 assistant 回合来实现。 - 调优学习率(learning rate)。除了数据之外,这是决定你的模型是”还行”还是”很棒”最重要的因素。
- 打包训练样本(Pack the training samples) 并调优序列长度以匹配你数据的分布。这将大幅加速训练。TRL 有一个便捷的应用来替你完成这件事。
让我们看看其中一些选择对 SmolLM3 是如何起作用的。对于我们第一批基线实验,我们想要一个简单的健全性检查:chat template 真的能激发混合推理吗?为了测试这一点,我们比较了来自我们那张表的三种数据混合:
- Instruct(指令型): 在非推理示例上训练。
- Thinking(思考型): 在推理示例上训练。
- Hybrid(混合型): 在所有示例上训练。
对于每种混合,我们在 SmolLM3-3B-Base 上使用 FullFT 运行 SFT,学习率为 1e-5,有效批量大小(effective batch size)为 128,训练 1 个 epoch。
由于这些是小数据集,我们没有使用打包,将 Instruct 子集的序列上限设为 8,192 个 token,其余的设为 32,768 个 token。在一个由八块 H100 组成的节点上,这些实验运行起来很快,根据子集的不同耗时在 30–90 分钟之间。下图比较了每个子集在相应推理模式下的性能。
这些结果很快向我们表明,混合模型表现出一种”裂脑(split brain)“现象,即一种推理模式的数据混合对另一种模式几乎没有影响。这一点从大多数评测在 Instruct、Thinking 和 Hybrid 子集上得分相近就可看出,而 LiveCodeBench v4 和 IFEval 是例外,在这两者上混合数据提升了整体性能。
氛围测试你的基线
尽管评测看起来还行,但当我们试图让混合模型扮演不同人设(例如,像海盗一样)时,它始终无视我们放在 system message 中的任何内容。经过一番挖掘,我们发现原因在于我们格式化数据的方式:
在我们 chat template 的设计中,我们暴露了一个 custom_instructions 参数来存储 system prompt。例如,下面是我们如何在对话中设置一个人设:
from transformers import AutoTokenizer

tok = AutoTokenizer.from_pretrained("HuggingFaceTB/SmolLM3-3B")

messages = [
    {
        "content": "I'm trying to set up my iPhone, can you help?",
        "role": "user",
    },
    {
        "content": "Of course, even as a vampire, technology can be a bit of a challenge sometimes [TRUNCATED]",
        "role": "assistant",
    },
]
chat_template_kwargs = {
    "custom_instructions": "You are a vampire technologist",
    "enable_thinking": False,
}
rendered_input = tok.apply_chat_template(
    messages, tokenize=False, **chat_template_kwargs
)
print(rendered_input)
## <|im_start|>system
### Metadata

## Knowledge Cutoff Date: June 2025
## Today Date: 28 October 2025
## Reasoning Mode: /no_think

### Custom Instructions

## You are a vampire technologist

## <|im_start|>user
## I'm trying to set up my iPhone, can you help?<|im_end|>
## <|im_start|>assistant
## <think>

## </think>
## Of course, even as a vampire, technology can be a bit of a challenge sometimes # [TRUNCATED]<|im_end|>
问题在于,我们的数据样本看起来是这样的:
{
    "messages": [
        {
            "content": "I'm trying to set up my iPhone, can you help?",
            "role": "user",
        },
        {
            "content": "Of course, even as a vampire, technology can be a bit of a challenge sometimes [TRUNCATED]",
            "role": "assistant",
        },
    ],
    "chat_template_kwargs": {
        "custom_instructions": None,
        "enable_thinking": False,
        "python_tools": None,
        "xml_tools": None,
    },
}
我们处理代码中的一个 bug 把 custom_instructions 设成了 None ,这实际上从 每一个训练样本 中移除了 system message 🙈!因此,对于这些训练样本,我们没有得到一个漂亮的人设,反而得到了 SmolLM3 的默认 system prompt:
chat_template_kwargs = {"custom_instructions": None, "enable_thinking": False}
rendered_input = tok.apply_chat_template(messages, tokenize=False, **chat_template_kwargs)
print(rendered_input)
## <|im_start|>system
#### Metadata

## Knowledge Cutoff Date: June 2025
## Today Date: 28 October 2025
## Reasoning Mode: /no_think

#### Custom Instructions

## You are a helpful AI assistant named SmolLM, trained by Hugging Face.

## <|im_start|>user
## I'm trying to set up my iPhone, can you help?<|im_end|>
## <|im_start|>assistant
## <think>

## </think>
## Of course, even as a vampire, technology can be a bit of a challenge sometimes [TRUNCATED]<|im_end|>
这对 SystemChats 子集尤其成问题,因为那里所有的人设都是通过 custom_instructions 定义的,因此模型有一种在对话中途随机切换角色的倾向。这把我们引向以下规则:
永远要氛围测试你的模型,即便评测看起来没问题。十有八九,你会发现训练数据中的微妙 bug。
修复这个 bug 对评测没有影响,但我们终于确信 chat template 和数据集格式化在正常工作了。
一旦你的设置稳定下来、数据流水线检查无误,下一步就是聚焦于开发特定的能力。
瞄准特定能力
在 Open-R1 的开发过程中,我们注意到,完全在单轮推理数据上训练一个基座模型,会无法泛化到多轮推理。这并不令人意外;缺少这类示例,模型就是在它的训练分布之外被测试。
为了对 SmolLM3 定量地衡量这一点,我们从 Qwen3 团队那里汲取了灵感,他们开发了一个名为 ThinkFollow 的内部评测,它随机插入 /think 或 /no_think 标签,以测试模型能否一致地在推理模式之间切换。在我们的实现中,我们取用了 Multi-IF 的 prompt,然后检查模型是否生成了被 <think> 和 </think> 标签包裹的空或非空 think 块。不出所料,我们混合基线的结果显示,模型在第一轮之后启用推理模式时惨败:
为了修复这个能力,我们构建了一个名为 IFThink 的新数据集。基于 Multi-IF 流水线,我们使用了来自 Tulu 3 指令遵循子集 的单轮指令,并用 Qwen3-32B 将它们扩展为多轮交流,以生成可验证的指令和推理轨迹(reasoning traces)。
该方法图示如下:
flowchart TD
    %% Inputs
    IFEval["Tulu 3 IF dataset"]
    InstructionTypes["Set of instruction types"]

    %% English Multi-Turn Generation
    SingleTurn["Single-turn prompt"]
    LLM1["Generate instructions with Qwen3-32B"]

    subgraph Turns ["Multi-turn prompts"]
        Turn1["Prompt @ turn 1"]
        Turn2["Prompt @ turn 2"]
        Turn3["Prompt @ turn 3"]
    end

    MultiTurn["Generate reasoning traces with Qwen3-32B"]

    IFThink["IFThink"]

    %% Connections
    IFEval --> SingleTurn
    IFEval --> InstructionTypes
    SingleTurn --> Turn1
    InstructionTypes --> LLM1
    LLM1 --> Turn2
    LLM1 --> Turn3

    Turn1 --> MultiTurn
    Turn2 --> MultiTurn
    Turn3 --> MultiTurn

    MultiTurn --> IFThink

    %% Styling
    classDef question fill:#ffd0c5
    classDef decision fill:#f9f9f9
    classDef success fill:#d1f2eb
    classDef danger fill:#fef3c7
    classDef category fill:#fef3c7

    class IFEval,InstructionTypes question
    class SingleTurn,LLM1,MultiTurn decision
    class Turn1,Turn2,Turn3 decision
    class IFThink success
把这份数据纳入我们的基线混合后,产生了显著的改进:
在用 IFThink 修复了多轮推理问题之后,我们的基线终于如预期那样运作了;它在各回合间保持一致,遵循指令,并正确使用 chat template。有了这个基础,我们转回到基础工作上:调优训练设置本身。
哪些超参数真正重要?
在 SFT 中,真正重要的超参数只有几个。学习率、批量大小和打包几乎决定了你的模型训练效率以及它泛化得有多好的方方面面。在我们的婴儿级基线中,我们只是挑选了合理的默认值来验证数据和 chat template。现在设置已经稳定,我们重新审视这些选择,看看它们对我们的基线有多大影响。
掩码 User 回合
chat template 的一个微妙设计选择是,是否在训练期间掩码 user 回合。在大多数 chat 风格的数据集中,每个训练示例都由交替的 user 和 assistant 消息组成(可能还有交错的工具调用)。如果我们训练模型预测所有 token,它实际上学会的是自动补全 user 的查询,而不是专注于产出高质量的 assistant 回答。
如下图所示,掩码 user 回合通过确保模型的损失只在 assistant 输出上计算、而非在 user 消息上计算,来防止这一点:
在 TRL 中,掩码会应用于那些能返回 assistant token 掩码的 chat template。在实践中,这涉及在模板中包含一个 {% generation %} 关键字,如下所示:
{%- for message in messages -%}
  {%- if message.role == "user" -%}
    {{ "<|im_start|>" + message.role + "\n" + message.content + "<|im_end|>\n" }}
  {%- elif message.role == "assistant" -%}
{% generation %}
{{ "<|im_start|>assistant" + "\n" + message.content + "<|im_end|>\n" }}
{% endgeneration %}
  {%- endif %}
{%- endfor %}
{%- if add_generation_prompt %}
  {{ "<|im_start|>assistant\n" }}
{%- endif %}
然后,当 apply_chat_template() 配合 return_assistant_tokens_mask=True 使用时,chat template 将指示对话的哪些部分应当被掩码。下面是一个简单的例子,展示了 assistant token 如何被赋予 ID 1,而 user token 则用 ID 0 被掩码:
chat_template = '''
{%- for message in messages -%}
  {%- if message.role == "user" -%}
    {{ "<|im_start|>" + message.role + "\n" + message.content + "<|im_end|>\n" }}
  {%- elif message.role == "assistant" %}
    {% generation %}
    {{ "<|im_start|>assistant" + "\n" + message.content + "<|im_end|>\n" }}
    {% endgeneration %}
  {%- endif %}
{%- endfor %}
{%- if add_generation_prompt %}
  {{ "<|im_start|>assistant\n" }}
{%- endif %}
'''
rendered_input = tok.apply_chat_template(messages, chat_template=chat_template, return_assistant_tokens_mask=True, return_dict=True)
print(rendered_input)
## {'input_ids': [128011, 882, 198, 40, 2846, 4560, 311, 743, 709, 856, 12443, 11, 649, 499, 1520, 30, 128012, 198, 257, 128011, 78191, 198, 2173, 3388, 11, 1524, 439, 264, 51587, 11, 5557, 649, 387, 264, 2766, 315, 264, 8815, 7170, 510, 2434, 12921, 9182, 60, 128012, 271], 'attention_mask': [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1], 'assistant_masks': [0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]}
在实践中,大多数情况下掩码对下游评测的影响不大,只带来几个点的改进。对于 SmolLM3,我们发现它对 IFEval 影响最大,这可能是因为模型不太倾向于复述 prompt,从而更紧密地遵循各种约束。下图展示了 user 掩码如何影响每个评测和推理模式。
要不要打包?
序列打包是那种对训练效率产生巨大影响的训练细节之一。在 SFT 中,大多数数据集包含长度可变的样本,这意味着每个 batch 都包含大量浪费算力并拖慢收敛的 padding(填充)token。
打包通过把多个序列连接(concatenate)在一起,直到达到一个期望的最大 token 长度,来解决这个问题。执行连接有多种方式,其中 TRL 采用了一种”最佳适配递减(best-fit decreasing)“策略 (Ding et al., 2024),即待打包序列的排序由其长度决定。如这里所示,这种策略在最小化跨 batch 边界文档截断的同时,也减少了 padding token 的数量:
在预训练中,这根本不是个问题。当在数万亿个 token 上训练时,打包是必不可少的,以避免在 padding 上浪费大量算力。像 Megatron-LM 和 Nanotron 这样的预训练框架默认就实现了打包。后训练则不同。因为运行更短,权衡也随之改变。
为了感受打包对训练有多高效,让我们比较一下在我们基线数据集上一个 epoch 内打包与不打包的运行时间:
根据批量大小的不同,我们看到打包将吞吐量提升了 3–5× 倍!那么,你应该 总是 使用打包吗?在某种程度上,答案取决于你的数据集有多大,因为打包通过把更多 token 装进每一步,减少了每个 epoch 的优化步数。你可以在下图中看到这一点,图中我们绘制了每个 batch 的非 padding token 的平均数量:
使用打包时,每个 batch 的 token 数量随批量大小线性增长,而且与不打包训练相比,每个优化步可以包含多达 33× 倍的 token!然而,打包可能会略微改变训练动态:虽然你总体上处理了更多数据,但你做的梯度更新更少,这可能影响最终性能。在小数据集上尤其如此,那里每个样本都更重要。例如,如果我们在同样的有效批量大小 128 下比较打包与不打包,我们会看到一些评测(如 IFEval)的性能受到了显著的冲击:
更普遍地,我们看到,一旦有效批量大小大于 32,对于这个特定模型和数据集,性能就有一个平均的下降:
在实践中,对于数据集庞大的大规模 SFT,打包几乎总是有益的,因为算力节省远远超过了梯度频率上的任何微小差异。然而,对于较小或更多样的数据集——比如领域专属的微调或在有限的人工策展数据上的指令调优——也许值得禁用打包,以保留样本的粒度,并确保每个示例都干净地为优化做出贡献。
最终,最好的策略是经验性的:先启用打包,同时监控吞吐量和下游评测,然后根据速度提升是否转化为等效或更优的模型质量来进行调整。
调优学习率
我们现在来到最后一个重要的超参数:学习率。设得太高,训练可能发散;太低,收敛就慢得令人痛苦。
在 SFT 中,最优学习率通常比预训练期间使用的小一个数量级(或更多)。这是因为我们是从一个具有丰富表征的模型初始化的,而激进的更新可能导致灾难性遗忘(catastrophic forgetting)。
不像预训练那样,在完整运行上做超参数扫描(sweep)代价高得令人却步,后训练运行足够短,以至于我们实际上可以做完整的学习率扫描。
在我们的实验中,我们发现”最佳”学习率随模型家族、大小以及打包的使用而变化。由于高学习率可能导致梯度爆炸,我们发现当启用打包时,略微降低学习率往往更安全。我们的结果表明,使用 3e-6 或 1e-5 这样小的 LR,比使用大值能给出更好的整体性能:
尽管平均几个点看起来不算多,但如果你看像 AIME25 这样的单个 benchmark,你会发现当学习率大于 1e-5 时,性能急剧下降。
扩展 Epoch 数量
在我们的消融中,我们通常训练单个 epoch 以便快速迭代。一旦你确定了一个好的数据混合并调优了像学习率这样的关键参数,下一步就是为最终训练增加 epoch 数量。
例如,如果我们取用我们的基线数据混合并训练五个 epoch,我们会看到,平均挤出多几个百分点的性能是可能的:
正如我们在学习率扫描中看到的,平均性能掩盖了扩展 epoch 数量对单个评测的影响:在使用扩展思考的 LiveCodeBench v4 的情况下,我们将性能比单个 epoch 几乎翻了一倍!
一旦你迭代了你的 SFT 数据混合并且模型达到了一个合理的性能水平,下一步往往是去探索更高级的方法,比如[偏好优化](#from-sft-to-preference-optimization-teaching-models-what- better- means) 或强化学习。然而,在一头扎进那些方法之前,值得考虑一下,把额外的算力花在通过 持续预训练(continued pretraining) 来强化基座模型上是否更好。
我们在预训练章节提到的另一个重要组件是优化器。AdamW 在后训练中同样仍是默认选择。一个悬而未决的问题是,用 Muon 这样的替代优化器预训练的模型,是否应该用 相同的 优化器进行后训练。Kimi 团队发现,对预训练和后训练使用相同的优化器,为他们的 Moonlight 模型带来了最佳性能。
通过持续预训练增强推理能力
持续预训练——或者说 mid-training(中期训练) ,如果你想听起来时髦点的话——意味着取一个基座模型,并在做 SFT 之前在大量领域专属 token 上进一步训练它。当你 SFT 的目标能力共享一个共同的核心技能(比如编程或推理)时,中期训练就很有用。在实践中,这会把模型推向一个能更好地支持推理、某种特定语言或你所关心的任何其他能力的分布。从一个已经整合了那个核心技能的模型开始 SFT,能让你的模型更好地聚焦于你 SFT 数据中的特定主题,而不是用算力从零学习那个核心技能。
中期训练的方法可以追溯到 ULMFit (Howard & Ruder, 2018),它开创了通用预训练 → 中期训练 → 后训练的三阶段流水线,这在如今的现代 LLM 中已经很常见,比如 FAIR 的 Code World Model (team et al., 2025):
这种方法也被用于 Phi-4-Mini-Reasoning (Xu et al., 2025) 的训练中,但有一个变化:作者没有在 web 数据上做持续预训练,而是用了从 DeepSeek-R1 蒸馏出的推理 token 作为中期训练语料。结果令人信服,展示了通过多阶段训练带来的一致且巨大的收益:
| Model | AIME24 | MATH-500 | GPQA Diamond |
|---|---|---|---|
| Phi-4-Mini | 10.0 | 71.8 | 36.9 |
| + Distill mid-training | 30.0 | 82.9 | 42.6 |
| + Distill fine-tuning | 43.3 | 89.3 | 48.3 |
| + Roll out DPO | 50.0 | 93.6 | 49.0 |
| + RL (Phi-4-Mini-Reasoning) | 57.5 | 94.6 | 52.0 |
这些结果促使我们尝试了一种类似的方法。从我们之前在 Open-R1 中创建和评测推理数据集的经验出发,我们有三个主要的候选数据集可供使用:
- Mixture of Thoughts : 从 DeepSeek-R1 蒸馏出的 35 万个推理样本,覆盖数学、代码和科学。
- Llama-Nemotron-Post-Training-Dataset: NVIDIA 的大规模数据集,从各种各样的模型(如 Llama 3 和 DeepSeek-R1)蒸馏而来。我们筛选了数据集中的 DeepSeek-R1 输出,结果约有 364 万个样本,即 18.7B 个 token。
- OpenThoughts3-1.2M: 质量最高的推理数据集之一,有 120 万个从 QwQ-32B 蒸馏出的样本,包含 16.5B 个 token。
由于我们计划在最终的 SFT 混合中纳入推理数据,我们决定把 Mixture of Thoughts 留给那个阶段,而把其他的用于中期训练。我们用 ChatML 作为 chat template,以避免过早地”烧入(burning in)” SmolLM3 的那一套模板。我们训练了五个 epoch,学习率为 2e-5,使用八个节点以加速训练,有效批量大小为 128。
你可能会纳闷为什么我们在做了一些 SFT 运行 之后 才讨论中期训练。从时间顺序上讲,中期训练发生在对基座模型做 SFT 之前,但它是否有益,往往只有在你运行了初始 SFT 实验并识别出性能差距之后才会变得清晰。在实践中,你常常会迭代:运行 SFT 以识别薄弱环节,然后做有针对性的中期训练,再运行 SFT。把这一节当作 “当单靠 SFT 不够时该怎么办”。
GPU 熔毁之谜
运行这些实验在我们的集群上竟成了一个出人意料的挑战:老化的 GPU 会在各个时刻被降频(throttled),从而导致硬件故障并迫使每次运行重启。为了让你体会一下那是什么感觉,下面是其中一次运行的日志,每一次颜色变化都代表一次重启:
我们最初以为可能是 DeepSpeed 的问题,因为这个加速器为吞吐量做了高度优化。为了测试这一点,我们切换到数据并行,这多少有点帮助,但接着损失(loss)却大相径庭!
正如我们后来发现的,Hugging Face Accelerate 中数据并行的一个 bug 意味着权重和梯度以模型的原生精度(此处为 BF16)存储,这在累积和优化期间导致了数值不稳定和梯度精度的损失。
于是,我们切换回 DeepSpeed,并加入了激进的检查点保存(checkpointing),以最小化因 GPU 过热和”掉总线(falling off the bus)“而损失的时间。这一策略被证明是成功的,也是我们更普遍推荐的做法:
正如我们在预训练章节强调的,在训练运行期间频繁保存模型检查点,并把它们推送到远程存储(例如 Hugging Face Hub),以避免意外覆盖。此外,让你的训练框架对故障具有鲁棒性,并能够自动重启。这两个策略都将为你节省时间,尤其是对于像中期训练这样长时间运行的任务。
在照看了这些运行大约一周之后,我们终于有了结果:
总体而言,我们发现 NVIDIA 的后训练数据集比 OpenThoughts 给出了更好的性能,但两者的组合整体上是最好的。
现在让我们来看看,取用这些检查点之一并应用我们同样的基线数据混合的效果:
使用一个经过中期训练的推理模型,而非预训练模型,其效果是显著的:使用扩展思考,我们在 AIME25 和 LiveCodeBench v4 上的性能几乎翻了三倍,而 GPQA-D 获得了整整 10 个点的提升。有点出人意料的是,这个推理核心也部分地迁移到了 /no_think 推理模式,在推理 benchmark 上有大约 4 到 6 个点的改进。这些结果给了我们清晰的证据:对于推理模型,如果你的基座模型在预训练期间还没有见过大量推理数据,那么进行一定量的中期训练几乎总是合理的。
当你的模型必须学习一项新的核心技能时,中期训练就大放异彩。当基座模型已经具备该技能,或者你试图激发的是像风格或对话闲聊这样的浅层能力时,它就用处不大了。在这些情况下,我们建议跳过中期训练,把你的算力分配给其他方法,比如偏好优化或强化学习。
一旦你对你的 SFT 数据混合和模型的广泛能力有了信心,焦点就自然地从学习技能转向精炼它们。在大多数情况下,最有效的前进方式是 偏好优化(preference optimization) 。
从 SFT 到偏好优化:教模型什么叫 更好
尽管你可以用更多数据继续扩展 SFT,但到了某个点,你会观察到收益递减,或者出现一些失败模式,比如你的模型无法修复自己有 bug 的代码。为什么?因为 SFT 是一种 模仿学习(imitation learning) ,所以模型只学会复现它被训练的数据中的模式。如果数据本身就不包含好的修复,或者期望的行为难以通过蒸馏激发出来,那么模型就没有清晰的信号来判断什么才算”更好”。
这就是偏好优化登场的地方。我们不只是复制示范,而是给模型提供比较性的反馈,比如”回答 A 比回答 B 更好”。这些偏好为质量提供了一个更直接的训练信号,并使模型性能能够扩展到单靠 SFT 的极限之外。
偏好优化的另一个好处是,它通常需要的数据远比 SFT 少,因为起点已经是一个相当好的模型,它能遵循指令,并拥有来自前几个训练阶段的知识。
让我们看看这些数据集是如何创建的。
创建偏好数据集
历史上,偏好数据集是通过向人工标注者提供成对的模型回答,并请他们评判哪一个更好(可能在一个量表上)来创建的。这种方法至今仍被 LLM 供应商用来收集 人类偏好(human preference) 标签,但它极其昂贵且扩展性很差。最近,LLM 已经变得能够产出高质量的回答,而且往往以一种经济高效的方式。这些进步使得用 LLM 为许多应用生成偏好变得切实可行。在实践中,有两种常见的方法。
Strong vs. Weak(强 vs. 弱)
- 取一组固定的 prompt (通常为覆盖度和难度而精心策展)。
- 从一个较弱或基线模型生成一个回答,再从一个高性能模型生成另一个。
- 把较强模型的输出标记为 chosen(选中)回答 ,把较弱的标记为 rejected(拒绝) 。
这产生了一个”较强 vs. 较弱”比较的数据集 ,它构建起来很简单,因为我们假设较强模型的输出可靠地更好。
下面是来自 Intel 的一个流行例子,他们取了一个包含 GPT-3.5 和 GPT-4 回答的 SFT 数据集,并通过选择 GPT-4 的回答作为 chosen、GPT-3.5 的作为 rejected,将其转换成了一个偏好数据集:
On-Policy with Grading(带评分的同策略)
- 使用你将要训练的 同一个模型 来为同一个 prompt 生成多个候选回答。这创建的数据是”同策略(on-policy)“的,因为它反映了模型会自然产出的输出分布。
- 不依赖一个更强的模型作为参考,而是引入一个 外部评分者(external grader) :要么是一个验证器(verifier),要么是一个奖励模型(reward model),它沿着一个或多个质量轴(例如有用性、事实准确性)给回答打分。
- 然后评分者在候选回答之间分配偏好标签,产生一个更细致、更灵活的偏好数据集。
这种方法允许随着模型改进而持续地自举(bootstrap)偏好数据,但其质量在很大程度上取决于评估者的可靠性和校准(calibration)。
SnorkelAI 提供了这样一个数据集的好例子。他们取了一个名为 UltraFeedback 的流行偏好数据集中的 prompt,把它们划分为三个集合,然后迭代地应用上述配方来改进他们的模型:
在 SmolLM3 开发之时,还不存在任何带有推理轨迹的偏好数据,所以我们决定使用”strong vs. weak”方法自己生成一些。我们使用了 Ai2 的 Tulu 3 偏好混合中的 prompt,在 /think 模式下从 Qwen3-0.6B 和 Qwen3-32B 生成回答。结果是一个包含 25 万+ LLM 生成偏好的大规模数据集,准备好用偏好优化算法在多个轴上同时改进我们的 SFT 检查点。
你应该使用哪种算法?
直接偏好优化(Direct preference optimization, DPO) (Rafailov et al., 2024) 是第一个在开源界获得广泛采用的偏好优化算法。
它的吸引力来自于实现简单、实践中稳定,以及即便只有适量偏好数据也有效。因此,DPO 已成为在伸手去拿 RL 这样更复杂的技术之前,改进 SFT 模型的默认方法。
但研究者很快发现,有许多方法可以在 DPO 之上进行改进,如今有各种各样的替代方案可供探索。下面是我们发现最有效的几个:
- Kahneman–Tversky 优化(Kahneman–Tversky optimization, KTO) (Ethayarajh et al., 2024):KTO 不依赖偏好对,而是用人类决策中的思想来建模单个回答是否”可取(desirable)“。如果你无法获得成对的偏好数据(例如,从终端用户那里收集的原始回答,如 👍 或 👎),这是个不错的选择。
- 赔率比偏好优化(Odds ratio preference optimization, ORPO) (Hong et al., 2024):这通过在交叉熵损失上添加一个赔率比,把偏好优化直接整合进 SFT。因此,无需参考模型或 SFT 阶段,这使得该方法在计算上更高效。
- 锚定偏好优化(Anchored preference optimization, APO) (D’Oosterlinck et al., 2024):这是一个更可控的目标,它显式地正则化模型对 chosen 与 rejected 输出的似然应当偏移多少,而不仅仅是优化它们的差异。它有两个变体(APO-zero 和 APO-down)。使用哪一个取决于你的模型与偏好数据之间的关系;即 chosen 输出是优于还是劣于模型自身的输出。
幸运的是,我们只需在 TRL 的 DPOTrainer 中改动一行代码,就能在其中许多方法之间切换,所以对于我们的初始基线,我们做了以下事情:
- 使用 Ai2 的 Tulu 3 Preference Personas IF 数据集 中的 prompt 和 completion,在
/no_think推理模式下衡量 IFEval 上指令遵循的改进。 - 复用上述数据集的 prompt,但现在用 Qwen3-32B 和 Qwen3-0.6B 生成”strong vs. weak”偏好对。这给了我们
/think推理模式的偏好数据。 - 训练一个 epoch,并衡量 IFEval 上的 域内(in-domain) 改进,以及对其他评测(如 AIME25,它与指令遵循直接相关)的 域外(out-of-domain) 影响。
如下图所示,两种推理模式的域内改进都很显著:在 IFEval 上,APO-zero 比 SFT 检查点提升了 15–20 个百分点!
由于 APO-zero 也有最佳的整体域外性能,我们决定在余下的消融中使用它。
正如我们的结果所示,偏好优化不仅让模型更有用或更对齐;它还教它们 推理得更好 。如果你需要一种快速改进你推理模型的方法,试试生成”strong vs. weak”偏好,并对不同的损失函数做消融。你可能会发现相对于原版 DPO 的显著收益!
哪些超参数对偏好优化最重要?
对于偏好优化,通常只有三个超参数会影响训练动态:
- 学习率,通常比用于 SFT 的小 10–100× 倍
- β 参数,它通常控制偏好对之间间隔(margin)的大小
- 批量大小
让我们看看这些对 SmolLM3 是如何起作用的,起点是我们在整个 smoltalk2 上训练的 SFT 检查点。
使用小学习率以获得最佳性能
我们运行的第一个消融是检查学习率对模型性能的影响。我们运行实验来确定学习率在比 SFT 学习率(2e-5)小约 200×(1e-7)到小约 2×(1e-5)之间的影响。之前的项目,如 Zephyr 7B,已经教会我们,偏好优化方法的最佳学习率大约比用于 SFT 的小 10× 倍,而我们为 SmolLM3 运行的消融确认了这条经验法则。
如下图所示,大约小 10× 倍的学习率在两种推理模式下都改善了 SFT 模型的性能,但超过那个 10× 极限的所有学习率都导致了扩展思考模式更差的性能:
/no_think 推理模式的趋势更稳定,最佳学习率在 5e-6。这主要由单个 benchmark(LiveCodeBench v4)驱动,所以我们在 SmolLM3 运行中选择了 1e-6。
我们对你训练运行的建议是,在比你 SFT 学习率小 5× 到 20× 倍的范围内扫描你的学习率。你极有可能在那个范围内找到你的最优性能!
调优你的 β
我们在一个很宽的值范围(从 0.01 到 0.99)上为 β 参数运行实验,以探索对参考模型的不同对齐程度。提醒一下,较低的值鼓励停留在参考模型附近,而较高的值则允许模型更紧密地匹配偏好数据。在没有扩展思考的情况下,多个 β 值上的性能保持稳定。β=0.1 的模型性能在两种推理模式下都是最高的,并相比 SFT 检查点的指标显示出改进。使用较低的 β 值损害了模型性能,导致一个比 SFT 检查点更差的模型。
这些结果表明,对于偏好优化,大于 0.1 的值更可取,而且把模型与偏好数据对齐,比停留在参考模型附近更有益。然而,我们建议在 0.01–0.5 的范围内探索 β 值。更高的值可能抹去 SFT 检查点中那些我们可能没有在图上所示评测中捕捉到的能力。
扩展偏好数据
我们还运行了实验,以确定数据集大小如何影响结果,测试了从 2k 到 340k 偏好对的值。在这个范围内,性能保持稳定。扩展思考模式中的性能下降出现在超过 100k 偏好对的数据集上,但这个下降不像我们在不同学习率值上看到的那么明显。我们用于 SmolLM3 训练运行的数据集是 169k 偏好对,但结果显示,更小的数据集也能带来相对于 SFT 检查点的改进。对于未来的项目,我们知道在迭代阶段(此时重要的是尝试多种想法并快速识别最有前途的配置)可以用更小的数据集做实验。
集大成
把所有这些线索汇集到一起,产生了最终的 SmolLM3-3B 模型:其尺寸级别下同类最佳,并与 Qwen 自家的混合推理模型一同坐落在帕累托前沿上。
就几周的工作而言,相当不赖!
交战规则
总结一下我们关于偏好优化的发现,它们可能对你未来的项目有用:
- 别害怕创建你自己的偏好数据!随着推理变得”便宜到不计成本(too cheap to meter)“,如今从各种推理供应商(inference providers) 生成 LLM 偏好既简单又经济高效。
- 选择 DPO 作为你的初始基线,并从那里开始迭代。我们发现,根据偏好数据的类型,其他算法(如 ORPO、KTO 或 APO)相对于 DPO 能提供显著的收益。
- 使用比用于 SFT 的小约 10× 倍的学习率。
- 扫描 β,通常在 0.01 到 0.5 的范围内。
- 由于大多数偏好算法在一个 epoch 后就过拟合,划分你的数据并迭代式地训练以获得最佳性能。
偏好优化往往是简单性与性能之间的甜蜜点,但它继承了一个关键局限:它的好坏取决于你能收集到的离线(offline)偏好数据。在某个点上,静态数据集会耗尽信号,你就需要能在模型与 prompt 和环境互动时在线(online)生成新鲜训练反馈的方法。那就是偏好优化与更广泛的同策略和基于 RL 的方法家族相遇之处。
走向同策略,超越监督标签
如果你想让你的模型持续地解决数学问题、生成可执行代码,或跨多个步骤进行规划,你往往需要一个 奖励信号(reward signal) ,而不只是”A 比 B 更好”。
这就是 RL 开始变得有意义的地方。我们不再用偏好来监督模型,而是让它与一个环境(可以是数学验证器、代码执行器,甚至真实的用户反馈)互动,并直接从结果中学习。RL 在以下情况下大放异彩:
- 你能自动检查正确性 ,例如用单元测试、数学证明或 API 调用,或者你能获得一个高质量的验证器或奖励模型。
- 任务需要多步推理或规划 ,此时局部偏好可能无法捕捉长期的成功。
- 你想为超越偏好标签的目标进行优化 ,比如让代码通过单元测试,或最大化某个目标。
谈到 LLM,RL 主要有两种风味:
- 从人类反馈中强化学习(Reinforcement learning from human feedback, RLHF): 这种由 OpenAI 的 InstructGPT 论文 (Ouyang et al., 2022) 推广的方法,是 GPT-3.5 和许多现代 LLM 的基础。这里,人工标注者比较模型输出(例如,“A 比 B 更好”),然后训练一个奖励模型来预测这些偏好。接着用 RL 微调策略(policy)以最大化学到的奖励。
- 带可验证奖励的强化学习(Reinforcement learning with verifiable rewards, RLVR): 这种由 DeepSeek-R1 推广的方法,涉及使用验证器来检查模型的输出是否满足某些明确定义的正确性标准(例如,代码是否能编译并通过所有测试,或数学答案是否正确)。然后用 RL 微调策略,以产出更多可验证正确的输出。
RLHF 和 RLVR 都定义了模型 为何 而被优化,但它们没有告诉我们那个优化应当 如何 进行。在实践中,基于 RL 的训练的效率和稳定性,在很大程度上取决于学习算法是 同策略(on-policy) 还是 异策略(off-policy) 。
像 GRPO 这样的方法通常落入同策略优化算法的类别,即生成 completion 的模型(策略)与正在被优化的模型是同一个。虽然 GRPO 大体上是一个同策略算法,但有几点需要注意。首先,为了优化生成步骤,可能会采样若干 batch 的生成,然后对模型做 次更新,其中第一个 batch 是同策略的,而接下来的几个 batch 则是略微异策略的。
为了应对用于生成的模型与当前被优化的模型之间的策略滞后(policy lag),会使用重要性采样(importance sampling)和裁剪(clipping)来重新加权 token 概率并限制更新的大小。
由于从 LLM 进行自回归(autoregressive)生成很慢,许多框架(如 verl 和 PipelineRL)已经添加了 completion 的异步生成和模型权重的”飞行中(in-flight)“更新,以最大化训练吞吐量。这些方法需要更复杂、更精心的实现,但能达到比同步训练方法高 4–5× 倍的训练速度。正如我们稍后将看到的,这些训练效率上的改进对于推理模型尤为明显,因为它们具有长尾的 token 分布。
对于 SmolLM3,我们完全跳过了 RL,主要是由于时间限制,以及有了一个仅凭离线偏好优化就已经同类最佳的模型。然而,自发布以来,我们重新审视了这个话题,在下一节中,我们将分享我们学到的一些教训。
将 RLVR 应用于混合推理模型
混合推理模型为 RLVR 带来了额外的复杂性,因为生成长度会根据推理模式而有相当大的差异。例如,在下图中,我们绘制了来自 SmolLM3 的最终 APO 检查点 在 AIME25 上的 token 长度分布:
如你所见, /no_think 模式生成的解答中位长度约为 2k 个 token,而 /think 模式的中位长度要大得多(16k 个 token),并带有一个肥尾(fat-tailed)分布。理想情况下,我们希望用 RLVR 改进两种模式的整体性能,而不太剧烈地改变它们各自的长度分布。
为了探索这一点,我们首先聚焦于使用来自 Big-Math(一个包含超过 25 万个带验证答案的数学问题的数据集)的一个 prompt 子集,来优化 /no_think 模式。
令我们惊讶的是,天真地应用 GRPO 导致了一种形式的奖励作弊:尽管从未被提示要发出一长串思维链(CoT),模型却学会了利用其基础推理能力来增加奖励。如下图所示,不仅奖励上升了,completion 的长度也跟着上升了:
换句话说,用 GRPO 进行 RLVR 把我们推理模型的 /no_think 模式转变成了一个看起来非常像 /think 模式的东西!
当我们查看模型的 completion 时,我们看到它现在正在生成长 CoT,甚至包含了一些与推理模型相关的认知行为 (Gandhi et al., 2025),比如”Wait, …(等等,……)”。这里展示了一个例子:
However, since the jogger and the train are moving in the same direction, the relative speed between them is the difference of their speeds:
\\( v_{\\text{rel}} = v_t - v_j = 12.7778 - 2.7778 = 10 \\) m/s

 **Wait,**  let me double-check the calculation:

 **Wait,**  46 km/hr to m/s:
46 * 1000 m / 3600 s = (46 * 10)/36 = 460/36 ≈ 12.7778 m/s (correct)
10 km/hr is:
10 * 1000 / 3600 = 10000 / 3600 ≈ 2.7778 m/s (correct)
Difference: 12.7778 - 2.7778 = 10 m/s (exact, since 46-10=36 km/hr → 36*(1000/3600)=10 m/s exactly)

The jogger is 340 meters ahead of the train's engine. When the train passes the jogger, the distance the train needs to cover relative to the jogger is 340 meters plus the length of the train? Wait, actually, let me think about the problem again.

 **Wait,**  actually, when the problem says the train takes 46 seconds to pass the jogger, that usually means the time from the front of the train to the end passing the jogger. The length of the train would then be equal to the relative speed multiplied by the time.

But first, the initial position: the jogger is 340 meters ahead of the engine. So the engine is 340 meters ahead of the jogger. Wait no, the wording says "340 m ahead of the engine", so the jogger is ahead by 340 meters. So when the jogger is running alongside, the engine of the train is 340 m away behind the jogger? Wait, maybe I need to clarify.

 **Wait**  the problem says: "A jogger running at 10 km/hr alongside a railway track is 340 m ahead of the engine of a train running at 46 km/hr in the same direction. The train takes 46 seconds to pass the jogger. How long is the train in meters?"

Hmm, so the jogger is 340 m ahead of the engine along the track. Since they're moving in the same direction, the train is behind the jogger by 340 meters. To pass the jogger, the train has to cover that 340 meters plus the length of the train itself?
用超长惩罚缓解奖励作弊
这个问题可以通过加入一个 超长 completion 惩罚(overlong completion penalty) 来缓解,它惩罚超过某一长度的 completion。这个惩罚由两个参数化的参数决定:最大 completion 长度 ,以及软惩罚缓存(soft punishment cache) 。这个惩罚是 DAPO 论文 (Yu et al., 2025) 中提出的改进之一,相当于应用如下的奖励函数:
使用这个惩罚,我们可以直接控制模型的输出分布,并衡量增加响应长度与性能之间的权衡。下图展示了一个例子,其中我们将超长惩罚从 1.5k 到 4k 以 512 个 token 为步长进行变化:
当我们检视 AIME25 上的改进时,响应长度与性能之间的权衡就更清晰了:
现在我们可以清楚地看到超长惩罚如何影响下游性能,2–4k 范围内的惩罚带来了显著的改进,同时把 token 分布控制住。如下图所示,如果我们取用第 400 步的检查点,我们可以在一系列不同的惩罚下比较初始策略和最终模型之间的输出 token 分布:
集大成
我们发现,应用一个 2.5–3k 范围内的长度惩罚给出了性能与响应长度之间的最佳权衡,下图显示 GRPO 在 AIME 2025 上的性能比 APO 这样的离线方法几乎翻了一倍:
现在我们知道了如何改进 /no_think 推理模式的性能,RL 训练流水线的下一步将是同时对两种推理模式进行模型的 联合训练(joint training) 。然而,我们发现这是一块相当难啃的硬骨头,因为每种模式都需要它自己的长度惩罚,而它们之间的相互作用迄今为止产生了不稳定的训练。这凸显了试图在混合推理模型上应用 RL 的主要挑战,我们可以从像 Qwen 这样的模型开发者的一个新趋势中看到它的反映——他们把 instruct 和 reasoning 变体分开发布。
我们的实验表明,RLVR 能有效地引导推理行为,但只有在精心的奖励塑形(reward shaping)和稳定性机制下才行。鉴于这种复杂性,值得问一问,强化学习是否是唯一可行的前进路径。事实上,近期文献中已经提出了几种更轻量级的同策略优化策略,尽管它们仍然惊人地未被开源社区充分探索。让我们看看其中一些,来为本章收尾。
RL 是唯一的玩家吗?
其他同策略学习的方法,把偏好优化和蒸馏扩展为迭代循环,在模型演进时刷新训练信号。这些包括:
- Online DPO(在线 DPO): 模型不是在一个固定的偏好数据集上训练一次,而是持续地采样新回答,收集新鲜的偏好标签(来自奖励模型或 LLM 评分者),并更新自己。这让优化保持同策略,并减少训练数据与模型当前行为之间的漂移(drift)(Guo et al., 2024)。
- On-policy distillation(同策略蒸馏): 信号不来自偏好,而来自一个更强的教师模型(teacher model)。学生(student)在每个训练步采样回答,而学生与教师在这些样本上的 logit 之间的 KL 散度(KL divergence)提供了学习信号。这让学生能够持续地吸收教师的能力,而无需显式的偏好标签或验证器 (Agarwal et al., 2024)。
这些方法模糊了静态偏好优化与完整 RL 之间的界线:你仍然能获得适应模型当前分布的好处,但没有设计和稳定一个强化学习循环的全部复杂性。
你应该使用哪种方法?
尽管有无数篇研究论文在讨论哪种同策略方法”最好”,但在实践中,这个决定取决于下表所示的几个因素:
| Algorithm | When to Use | Trade-offs | Model Size |
|---|---|---|---|
| Online DPO | 你能廉价地获得偏好标签。最适合让行为与不断演变的分布对齐。 | 易于迭代式扩展,比 RL 更稳定,但依赖标签质量和覆盖度。仅在少数训练框架中受支持。 | 适合任何尺寸,前提是偏好能捕捉超越模仿的改进。 |
| On-policy distillation | 你能获得一个更强的教师模型,并希望高效地迁移能力。 | 实现简单、运行便宜,但会继承教师的偏见,且上限受教师限制。仅在 TRL 和 NemoRL 中受支持。 | 对小到中型模型(<30B)最有效。 |
| Reinforcement learning | 你有可验证奖励,或有需要多步推理/规划的任务。可与奖励模型一起使用,但存在挑战(比如奖励作弊,即模型利用奖励模型的弱点)。 | 灵活且强大,但成本高、更难稳定;需要精心的奖励塑形。在大多数后训练框架中受支持。 | 最适合中到大型模型(20B+),额外的容量让它们能利用结构化的奖励信号。 |
在开源生态中,像 GRPO 和 REINFORCE 这样的强化学习方法往往是使用最广泛的,尽管 Qwen3 技术报告 (A. Yang, Li, et al., 2025) 强调了使用同策略蒸馏来训练 32B 参数以下的模型:
flowchart LR
    subgraph Flagship ["Flagship Models"]
        Base1["Base Models"] --> Stage1["Stage 1:
Long CoT Cold Start"]
        Stage1 --> Stage2["Stage 2:
Reasoning RL"]
        Stage2 --> Stage3["Stage 3:
Thinking Mode Fusion"]
        Stage3 --> Stage4["Stage 4:
General RL"]
        Stage4 --> FlagshipOut["Qwen3-235B-A22B
Qwen3-32B"]
    end

    subgraph Lightweight ["Lightweight Models"]
        Base2["Base Models"] --> Distillation["Strong-to-Weak
Distillation"]
        FlagshipOut --> Distillation
        Distillation --> LightweightOut["Qwen3-30B-A3B
14B/8B/4B/1.7B/0.6B"]
    end

    classDef flagshipStage fill:#ffd0c5
    classDef lightweightStage fill:#fef3c7
    classDef output fill:#f8d7da

    class Stage1,Stage2,Stage3,Stage4 flagshipStage
    class Distillation lightweightStage
    class FlagshipOut,LightweightOut output
小模型上同策略蒸馏的一个有趣特性是,它通常以 RL 方法一小部分的算力成本就超越了它们。这是因为,我们不是为每个 prompt 生成多个 rollout,而是只采样一个,然后在单次前向/反向传播中由教师评分。正如 Qwen3 技术报告所示,相对于 GRPO 的收益可以是显著的:
| Method | AIME24 | AIME25 | MATH500 | LiveCodeBench v5 | MMLU-Redux | GPQ Diamond | GPU Hours |
|---|---|---|---|---|---|---|---|
| Off-policy distillation | 55.0 | 42.8 | 92.4 | 42.0 | 86.4 | 55.6 | - |
| + Reinforcement learning | 67.6 | 55.5 | 94.8 | 52.9 | 86.9 | 61.3 | 17,920 |
| + On-policy distillation | 74.4 | 65.5 | 97.0 | 60.3 | 88.3 | 63.3 | 1,800 |
最近,Thinking Machines 已经证明,同策略蒸馏在缓解 灾难性遗忘 方面也很有效——所谓灾难性遗忘,是指一个后训练模型在一个新领域上进一步训练后,其先前的性能发生回退。在下表中,他们展示了,尽管 Qwen3-8b 的聊天性能(IFEval)在它被微调于内部数据时一落千丈,但这种行为可以用廉价的蒸馏来恢复:
我们对同策略蒸馏相当兴奋,因为有海量多样、能力强的开放权重 LLM 可以被蒸馏成更小的、任务专属的模型。然而,所有同策略蒸馏方法的一个弱点是,教师和学生必须共享相同的 tokenizer。为了解决这个问题,我们开发了一种名为 通用同策略 Logit 蒸馏(General On-Policy Logit Distillation, GOLD) 的新方法,它允许任何教师被蒸馏到任何学生中。如果你对这些话题感兴趣,我们建议你看看我们的技术文章。
类似地,FAIR 的研究者比较了对 DPO 而言完全异策略与同策略的效果,并展示了用远少得多的算力来匹敌 GRPO 的性能是可能的 (Lanchantin et al., 2025):
正如他们论文所示,在线 DPO 对数学任务效果很好,甚至半同策略(semi-on-policy)变体在偏离策略许多步的情况下也能达到可比的性能:
| Training Method | Math500 | NuminaMath | AMC23 |
|---|---|---|---|
| Seed (Llama-3.1-8B-Instruct) | 47.4 | 33.9 | 23.7 |
| Offline DPO (s = ∞) | 53.7 | 36.4 | 28.8 |
| Semi-online DPO (s = 100) | 58.9 | 39.3 | 35.1 |
| Semi-online DPO (s = 10) | 57.2 | 39.4 | 31.4 |
| Online DPO (s = 1) | 58.7 | 39.6 | 32.9 |
| GRPO | 58.1 | 38.8 | 33.6 |
总体而言,我们觉得在有效地扩展 RL (Khatri et al., 2025) 以及探索其他提升计算效率的方法上,仍有大量工作有待完成。确实是令人兴奋的时代!
总结后训练
如果你坚持读到了这里,恭喜你:你现在已经拥有了在后训练中取得成功所需的所有核心要素。你已经准备好运行实验、测试不同的算法以获得 SOTA 结果了。
但正如你大概已经意识到的,知道如何训练出色的模型只是故事的一半。要真正让这些模型活起来,你需要正确的基础设施。让我们用一个对 LLM 训练中无名英雄的审视,来为这部巨著收尾。
基础设施——无名英雄
既然你已经掌握了我们关于模型创建与训练的全部知识,接下来该谈谈那个关键却被低估的环节——它能成就你的项目(和你的银行账户),也能让它们一败涂地:基础设施。无论你专注于框架、架构还是数据治理,理解基础设施基础都有助于识别训练瓶颈、优化并行策略以及调试吞吐量问题。(至少,它能改善你与基础设施团队的沟通!)
大多数训练模型的人都极其在意架构和数据,却很少有人理解基础设施的细节。基础设施专业知识通常掌握在框架开发者和集群工程师手中,而其他人则把它当作一个已解决的问题:租一些 GPU,装上 PyTorch,万事大吉。我们在 384 块 H100 上训练 SmolLM3 近一个月,总共处理了 11 万亿 token……而这绝非一帆风顺!在此期间,我们应对了节点故障、存储问题和训练重启(详见 “训练马拉松”)。你需要有完善的应急预案和策略,为应对这类问题做好准备,让训练保持平稳、低维护。
本章旨在弥合这一知识鸿沟。可以把它看作一份硬件层的实用指南,聚焦于对训练真正重要的问题。(注意:每个小节都以 TL;DR 开头,方便你自行选择阅读深度。)
前两节探讨硬件运作的基本原理:GPU 究竟由什么组成?内存层次结构如何运作?CPU 和 GPU 如何通信?我们还会讨论在采购 GPU 时需要考虑什么,以及在投入长时间训练之前如何测试它们。最重要的是,我们会在每一步向你展示如何亲自测量和诊断这些系统。后续几节则更偏向实战:你将看到如何让基础设施具备故障韧性,以及如何最大化优化训练吞吐量。
本章的核心目标,就是找到并修复瓶颈!
可以把它当作一种直觉的建立——理解为什么某些设计决策至关重要。当你明白模型的激活值需要流经多级缓存,而每一级都有不同的带宽和延迟特性时,你自然会开始思考如何组织训练以最小化数据移动。当你看到节点间(internode)通信比节点内(intranode)通信慢上几个数量级时,你就会理解为什么并行策略如此关键。
让我们从剖开一块 GPU、看看里面有什么开始吧。
GPU 内部:内部架构
GPU 本质上是一种针对吞吐量(而非延迟)优化的大规模并行处理器。与擅长快速执行少数复杂指令流的 CPU 不同,GPU 通过同时执行数千个简单操作来获得性能。
理解 GPU 性能的关键,在于认识到它不仅仅关乎原始算力;而是关乎计算与数据移动之间的相互作用。一块 GPU 可以拥有数万亿次浮点运算的理论算力,但如果数据无法足够快地到达计算单元,那部分潜力就会被浪费。这就是为什么我们既需要理解内存层次结构(数据如何移动),也需要理解计算流水线(工作如何完成)。
简单来说,在最高层级上,GPU 执行两项基本任务:
- 移动和存储数据(内存系统)。
- 用数据做有用的工作(计算流水线)。
在接下来的小节中,我们将探讨这个等式的两端:GPU 如何计算(FLOPs、Tensor Cores、精度),以及它们如何移动数据(即内存层次结构,从高带宽内存 [HBM] 一直到寄存器)。
计算单元与 FLOPs
TL;DR: GPU 以 FLOPs(每秒浮点运算次数)衡量性能。像 H100 这样的现代 GPU 在更低精度下能提供显著更高的吞吐量:BF16 下为 990 TFLOPs,而 FP32 下仅为 67 TFLOPs。然而,由于内存瓶颈,实际性能仅为理论峰值的 70–77%。SOTA 训练能达到 20–41% 的端到端效率,也称为模型 FLOPs 利用率(MFU)。在规划训练任务时,请使用现实的数字,而非营销规格。
GPU 的计算性能以每秒浮点运算次数(FLOPs)来衡量。一个 FLOP 就是一次单独的算术运算,比如 a + b,而现代 GPU 每秒能执行数万亿次这样的运算(TFLOPs)。
GPU 计算的基本构建模块是 流式多处理器(Streaming Multiprocessors, SMs),即并行执行指令的独立处理单元。每个 SM 包含两类 核心:用于标准浮点运算的 CUDA Cores,以及专门为矩阵乘法优化的 Tensor Cores——矩阵乘法是深度学习中的主力运算(对 transformer 性能至关重要)。
现代 GPU 在芯片上组织了数百个这样的 SM。例如,H100 SXM5 版本(也就是我们集群上使用的 GPU)包含 132 个 SM。每个 SM 独立运行,以锁步(lockstep)方式执行被称为 warp 的 32 线程组。为此,SM 依赖于另一个组件—— warp 调度器(warp schedulers) : 通过在不同 warp 之间平衡指令,它们让 SM 能够在某个 warp 被阻塞时切换到另一个 warp,从而”隐藏”延迟。这种 SIMT(单指令多线程,single instruction, multiple threads)执行模型意味着一个 warp 中的所有线程同时对不同数据执行相同的指令。
有了数百个各自并发执行多个 warp 的 SM,一块 GPU 就能同时运行数万个线程。正是这种大规模并行能力,使 GPU 在主导深度学习工作负载的矩阵运算上表现卓越。
在讨论 FLOPs 时, 精度至关重要。Tensor Cores 可以在不同精度下运算(FP64、FP32、FP16/BF16、FP8、FP4)。因此,可达到的吞吐量会因数据类型而剧烈变化,往往相差几个数量级。更低精度的格式能带来更高的吞吐量,因为它们所需的数据移动更少,并且能在同样的硅片面积上塞进更多运算。过去人们因训练不稳定而避免使用它们,但如今得益于一系列新技术,训练和推理都越来越被推向更低精度,甚至达到 FP8 和 FP4。
下表展示了不同 NVIDIA GPU 世代和精度下的理论峰值性能(TFLOPs):
| 精度 / GPU 类型 | A100 | H100 | H200 | B100 | B200 |
|---|---|---|---|---|---|
| FP64 | 9.7 | 34 | 34 | 40 | 40 |
| FP32 | 19.5 | 67 | 67 | 80 | 80 |
| FP16/BF16 | 312 | 990 | 990 | 1.750 | 2,250 |
| FP8 | - | 3,960 | 3,960 | 4,500 | 5,000 |
| FP4 | - | - | - | 9,000 | 10,000 |
来源:NVIDIA、SemiAnalysis
低精度下吞吐量的急剧提升不仅仅关乎原始速度;它反映了我们思考数值计算方式的根本性转变。FP8 和 FP4 让模型能够在每 瓦特 和每 秒 内执行更多运算,使它们成为大规模训练和推理的必备选择。H100 在 FP8 下的 3,960 TFLOPs 相比 FP16/BF16 提升了 4 倍,而 B200 在 FP4 下的 10,000 TFLOPs 则将这一点推得更远。
请注意,这些理论峰值 FLOPs 代表的是 在理想条件下可达到的最大计算吞吐量——即所有计算单元都被充分利用且数据随时可用的情况下。在实践中,实际性能在很大程度上取决于你的工作负载能在多大程度上让计算单元持续有数据可处理,以及你的运算能否高效地映射到可用的硬件上。
对于 SmolLM3,我们打算在 NVIDIA H100 80GB HBM3 GPU 上训练,因此我们首先想用真实世界的性能来检验 H100 的理论 TFLOPs 规格。为此,我们使用了 SemiAnalysis GEMM 基准测试,它测试来自 Meta 的 Llama 70B 训练的真实世界矩阵乘法形状上的吞吐量。
下表展示了在 H100 80GB GPU 上,针对 Llama 70B 训练工作负载,不同精度和矩阵形状下实际达到的 TFLOPs:
| 形状 (M, N, K) | FP64 torch.matmul | FP32 torch.matmul | FP16 torch.matmul | BF16 torch.matmul | FP8 TE.Linear (autocast, bias=False) | FP8 torch._scaled_mm (e5m2/e4m3fn) | FP8 torch._scaled_mm (e4m3) |
|---|---|---|---|---|---|---|---|
| (16384, 8192, 1280) | 51.5 TFLOPs | 364.5 TFLOPs | 686.5 TFLOPs | 714.5 TFLOPs | 837.6 TFLOPs | 1226.7 TFLOPs | 1209.7 TFLOPs |
| (16384, 1024, 8192) | 56.1 TFLOPs | 396.1 TFLOPs | 720.0 TFLOPs | 757.7 TFLOPs | 547.3 TFLOPs | 1366.2 TFLOPs | 1329.7 TFLOPs |
| (16384, 8192, 7168) | 49.5 TFLOPs | 356.5 TFLOPs | 727.1 TFLOPs | 752.9 TFLOPs | 1120.8 TFLOPs | 1464.6 TFLOPs | 1456.6 TFLOPs |
| (16384, 3584, 8192) | 51.0 TFLOPs | 373.3 TFLOPs | 732.2 TFLOPs | 733.0 TFLOPs | 952.9 TFLOPs | 1445.7 TFLOPs | 1370.3 TFLOPs |
| (8192, 8192, 8192) | 51.4 TFLOPs | 372.7 TFLOPs | 724.9 TFLOPs | 729.4 TFLOPs | 1029.1 TFLOPs | 1404.4 TFLOPs | 1397.5 TFLOPs |
验证理论性能
我们的实验揭示了理论峰值与可达到性能之间的差距。对于 FP64 Tensor Core 运算,我们达到了 49–56 TFLOPs,相当于理论峰值(67 TFLOPs)的 74–84%。对于 TF32(TensorFloat-32,PyTorch 在 Tensor Cores 上默认对 FP32 张量使用的格式),我们达到了 356–396 TFLOPs,相当于理论峰值(约 495 TFLOPs 稠密)的 72–80%。虽然这些结果表明硬件利用率极佳,但这些精度在现代深度学习训练中很少使用:FP64 因其计算成本高昂,而 TF32 则是因为 BF16 和 FP8 等更低精度能提供更好的性能。
对于 BF16 运算,我们在不同矩阵形状上始终如一地达到了 714–758 TFLOPs,约为 H100 理论峰值 990 TFLOPs 的 72–77%。对于一个真实世界的工作负载来说,这在实践中是一个极佳的利用率!
虽然 kernel 基准测试测量的是原始 TFLOPs,但端到端训练效率由模型 FLOPs 利用率(MFU)来衡量:即有用的模型计算与硬件理论峰值性能之比。
我们的 BF16 matmul 基准测试显示我们达到了 H100 理论峰值的 72–77%。这代表了我们这套配置在 kernel 层面所能达到的上限。端到端训练的 MFU 必然会更低,因为还有更复杂的非 matmul 运算、通信开销以及其他辅助计算。
训练中的最先进 MFU:Meta 在训练 Llama 3 405B 时达到了 38–41%,而 DeepSeek-V3 在因 MoE 架构而存在更紧张通信瓶颈的 GPU 上达到了约 20–30%。对于 SmolLM3,我们达到了约 30% 的 MFU,后文你会看到。其中大部分差距来自分布式训练中的节点间通信开销。鉴于我们在 kernel 层面约 77% 的天花板,这些端到端数字相对于可达到的 matmul 性能大约代表了 50–55% 的效率。推理工作负载可以达到更高的 MFU(>70%,更接近原始 matmul 性能),不过来自生产部署的公开结果较为稀少。
FP8 的结果则更为微妙。让我们看看我们在三种不同矩阵乘法方法 / kernel 上的结果。
使用 PyTorch 的 torch._scaled_mm kernel 配合 e4m3 精度,我们根据矩阵形状的不同达到了 1,210–1,457 TFLOPs,约为理论峰值 3,960 TFLOPs 的 31–37%。为什么?这个较低的利用率百分比(在 FP8 下)实际上并不意味着性能差;相反,它反映了随着计算吞吐量的增长,这些运算变得越来越受内存限制(memory-bound)。Tensor Cores 处理 FP8 数据的速度比内存系统供给数据的速度更快,使内存带宽成为限制因素。
Transformer Engine 的 TE.Linear 根据形状不同达到了 547–1,121 TFLOPs,而 torch._scaled_mm 始终如一地提供了更高的吞吐量。这凸显了一个重要教训:Kernel 实现至关重要,即使针对相同的硬件能力,API 的选择也能让性能相差 2–3 倍。
对于 SmolLM3 的训练,这些实际测量帮助我们设定了切合实际的吞吐量预期。在规划你自己的训练任务时,务必使用可达到的数字,而非理论峰值。
除了选择正确的 kernel API,我们还需要确保这些 kernel 是为正确的硬件世代编译的。 计算能力(Compute capability, CC) 是 NVIDIA 的版本控制系统,它将物理 GPU 细节从 PTX 指令集中抽象出来。它决定了你的 GPU 支持哪些指令和特性。
为什么这很重要: 为特定计算能力编译的 kernel 可能无法在更老的硬件上运行,而如果你的代码没有为目标 GPU 的 CC 编译,你可能会错过一些优化。更糟糕的是,框架可能会悄无声息地选择次优的 kernel——我们就发现 PyTorch 在我们的 H100 上选择了 sm_75 kernel(计算能力 7.5,为 Turing GPU 设计),导致了莫名其妙的性能下降。PyTorch 社区中也记录了一个类似问题,框架常常默认选择更老、更兼容的 kernel 而非最优的。这个看似微小的细节可能意味着同一块硬件上是跑出 720 TFLOPs 还是 500 TFLOPs 的差别。
在使用预编译库或自定义 kernel 时,务必验证它们是为你硬件的计算能力构建的,以确保兼容性和最优性能。例如,sm90_xmma_gemm_..._cublas 表示一个为 SM 9.0(计算能力 9.0,H100 所使用)编译的 kernel。
你可以用 nvidia-smi --query-gpu=compute_cap 查看你的 GPU 计算能力,或者在 NVIDIA CUDA C 编程指南的计算能力章节中查找技术规格。
正如我们所见,当计算在低精度下变得过快时,GPU 内存似乎会成为瓶颈。让我们更仔细地看看 GPU 内存如何运作,以及是什么导致了瓶颈的出现。
GPU 内存层次结构:从寄存器到 HBM
TL;DR: GPU 将内存组织成一个层次结构,从快但小(寄存器、共享内存)到慢但大(HBM 主内存)。理解这一层次结构至关重要,因为现代 AI 往往是受内存限制的(memory-bound):瓶颈在于移动数据,而非对数据进行计算。算子融合(operator fusion,如 Flash Attention)通过将中间结果保留在快速的片上内存中而非写入慢速的 HBM,实现了 2–4 倍的加速。基准测试显示,H100 的 HBM3 在实践中提供约 3 TB/s 的带宽,与大规模传输的理论规格相符。
理解 GPU 内存层次结构对于编写高性能 kernel 至关重要。为了进行计算,GPU 需要从内存读取 / 向内存写入,因此了解这些传输发生的速度非常重要。
为了直观地理解内存操作在实践中如何流经 GPU,让我们先来看看 NVIDIA Nsight Compute 的内存图表(Memory Chart),这是一种性能分析图表,能为你所选的任意 kernel 提供数据如何在不同内存单元之间移动的图形化表示:
一般来说,内存图表既展示 逻辑单元(绿色),如 Global、Local、Texture、Surface 和 Shared,也展示 物理单元(蓝色),如 L1/TEX Cache、Shared Memory、L2 Cache 和 Device Memory。单元之间的连线表示单元间发生的指令数(Inst)或请求数(Req),颜色则表示峰值利用率的百分比:从未使用(0%)到以峰值性能运行(100%)。
你可以使用 NVIDIA Nsight Compute 为任意 kernel 生成这张内存图表:
## 通过内存工作负载分析对特定 kernel 进行性能剖析
ncu --set full --kernel-name "your_kernel_name" --launch-skip 0 --launch-count 1 python your_script.py
## 剖析完成后,在 Nsight Compute GUI 中打开结果以查看内存图表
它提供了几个关键洞察:
- 瓶颈识别: 饱和的连线(以红 / 橙色显示)指示出数据移动受限的位置。
- 缓存效率: L1/TEX 和 L2 缓存的命中率揭示了你的 kernel 对内存层次结构的利用程度。
- 内存访问模式: 逻辑单元与物理单元之间的数据流显示了你的 kernel 是否具有良好的空间 / 时间局部性。
- 端口利用率: 即使聚合带宽看似利用不足,单个内存端口也可能已经饱和。
在我们的具体案例中,你可以看到 kernel 指令如何流经内存层次结构(针对我们硬件上的 FP64 矩阵乘法):Global load 指令向 L1/TEX 缓存生成请求,这些请求可能命中或未命中,并向 L2 生成进一步的请求,最终在未命中时访问设备内存(HBM)。单元内部的彩色矩形表示端口利用率;即使各条连线的运行低于峰值,共享数据端口也可能已经饱和。
让我们探索一下使这张图表成为可能的底层内存层次结构。现代 GPU 将内存组织成一个在速度、容量和成本之间取得平衡的层次结构,这是由基本物理和电路约束所决定的设计。
为了获得最优性能,应尽量减少对较慢内存层(HBM)的访问流量,同时最大化对较快内存层(共享内存、寄存器)的利用。
在这一层次结构的底部是 HBM(High Bandwidth Memory,高带宽内存): 即 GPU 的主内存,也称为 全局内存(global memory) 或 设备内存(device memory)。H100 配备 HBM3,理论带宽为 3.35 TB/s。HBM 是内存层次结构中最大但最慢的一层。
沿着层次结构向计算单元上行,我们会发现逐级更快但更小的内存层:
- L2 缓存: 一个跨整个 GPU 共享的大型 SRAM 缓存,通常为数十兆字节。在 H100 上,它为 50 MB,带宽约 13 TB/s。
- L1 缓存和共享内存(SMEM): 每个流式多处理器都有自己的 L1 缓存和由程序员管理的共享内存,它们共享同一块物理 SRAM 存储。在 H100 上,这块合并空间为每个 SM 256 KB,每个 SM 的带宽约 31 TB/s。
- 寄存器内存(RMEM): 在层次结构的顶端,寄存器是最快的存储,紧邻计算单元。寄存器为各个线程私有,提供每个 SM 约 100 TB/s 量级的有效带宽。
这种层次结构之所以存在,是因为 SRAM(用于缓存和寄存器)速度快但物理体积大且昂贵,而 DRAM(用于 HBM)密度高且便宜但速度较慢。结果就是:快速内存以小容量贴近计算单元,由逐级更大、更慢、距离更远的内存池作为后盾。
为什么这很重要
理解这一层次结构对于 kernel 优化至关重要。关键洞察在于:受内存限制的运算受限于你移动数据的速度,而非计算的速度。正如 Horace He 在 “Making Deep Learning Go Brrrr from First Principles” 中所解释的,从内存加载 → 自乘两次 → 写回内存 所花的时间,与 从内存加载 → 自乘一次 → 写回内存 基本相同。相比内存访问,计算几乎是”免费”的。
这就是为什么 算子融合(operator fusion) 如此强大:通过将多个运算合并到单个 kernel 中,你可以将中间结果保留在快速的 SRAM 中,而无需在运算之间将其写回慢速的 HBM。Flash Attention 正是这一原理付诸实践的完美例子。
标准的 attention 实现是受内存限制的,因为它们在 HBM 中物化(materialize)完整的 attention 矩阵:
- 计算
Q @ K^T→ 将 N × N 的 attention 分数写入 HBM - 应用 softmax → 从 HBM 读取、计算、再写回 HBM
- 与 V 相乘 → 再次从 HBM 读取 attention 分数
Flash Attention 通过 融合这些运算 并将中间结果保留在 SRAM 中,实现了 2–4 倍的加速:
- 它不计算完整的 attention 矩阵,而是以可装入 SRAM 的小块(tile)来处理 attention。
- 中间的 attention 分数从不离开快速的片上内存。
- 只有最终输出才会被写回 HBM。
结果: Flash Attention 将 HBM 访问从 O( N²) 降低到 O( N),把一个受内存限制的运算转变为能更好地利用 GPU 计算能力的运算。这正是高效 kernel 设计的精髓:最小化慢速内存移动,最大化快速计算。
示例:在实践中验证我们的 HBM3 带宽
既然我们理解了内存层次结构,让我们把理论付诸实践,在 H100 GPU 上验证实际带宽!这正是基准测试工具大显身手之处。
NVBandwidth 是 NVIDIA 的开源基准测试工具,专门用于测量 GPU 系统间的带宽和延迟。它使用复制引擎(copy engines)和基于 kernel 的方法,评估各种内存复制模式(host-to-device、device-to-host 和 device-to-device)的数据传输速率。该工具对于评估 GPU 间通信(例如通过 NVLink 和 PCIe)以及在多 GPU 环境中验证系统性能尤为有价值。
你可以从 NVIDIA 的 GitHub 仓库安装 NVBandwidth。它会输出详细的带宽矩阵,展示数据在不同设备间传输的效率,非常适合用于诊断性能瓶颈和验证 GPU 互连是否健康。
我们可以使用这个工具,通过 device_local_copy 测试来测量 H100 的本地内存带宽,该测试测量在不同消息大小下,GPU 本地设备缓冲区之间 cuMemcpyAsync 的带宽:
$ ./nvbandwidth -t device_local_copy -b 2048
memcpy local GPU(column) bandwidth (GB/s)
           0         1         2         3         4         5         6         7
 0   1519.07   1518.93   1519.07   1519.60   1519.13   1518.86   1519.13   1519.33
结果揭示了内存系统的一个重要特征: 对于较小的消息大小(< 1 MB),我们受限于延迟(latency-bound) 而非带宽。发起内存传输的开销主导了性能,使我们无法达到峰值带宽。然而, 对于较大的消息大小(≥ 1 MB),我们在读写操作上都达到了约 1,500 GB/s 的持续带宽。
由于 HBM 带宽同时计入读取和写入,我们将二者相加得到 总计 3 TB/s 的双向带宽(1,519 读取 + 1,519 写入),这与 H100 的理论 3.35 TB/s HBM3 规格高度吻合。
Roofline 模型
理解你的 kernel 是受计算限制(compute-bound)还是受内存限制(memory-bound),决定了哪些优化会有帮助。有两种情形:
- 如果你 受内存限制(大部分时间花在移动数据上),提升计算吞吐量并无帮助:你需要通过算子融合等技术来减少内存流量。
- 如果你 受计算限制(大部分时间花在 FLOPs 上),优化内存访问模式并无帮助:你需要更强的算力或更好的算法。
Roofline 模型 提供了一个可视化框架,用于理解这些性能特征并识别优化机会。我们前面提到的 Nsight Compute 性能分析工具中就提供了 roofline 视图。下面是我们将它应用于自己的 kernel 时得到的结果:
让我们看看如何读懂这张图表。它有两个轴:
- 纵轴( Performance ,性能)表示达到的 FLOPs 数量,使用对数刻度以容纳较大的取值范围。
- 横轴( Arithmetic Intensity ,算术强度)表示工作量与内存流量之比,以每字节 FLOPs(FLOPs per byte)衡量。同样,它使用对数刻度。
Roofline 本身由两条边界构成:
- 内存带宽边界(倾斜的线)由 GPU 的内存传输速率(HBM 带宽)决定。沿这条线的性能受限于数据移动的速度。
- 峰值性能边界(水平的线)由 GPU 的最大计算吞吐量决定。沿这条线的性能受限于计算执行的速度。
这两条边界相交的 脊点(ridge point) 代表了受内存限制与受计算限制两种状态之间的转折点。
我们可以通过查看图表被划分出的两个区域来解读性能:
- 位于 受内存限制 区域(倾斜边界之下)的 kernel 受内存带宽限制。GPU 在等待数据;提升算力无济于事。优化应聚焦于通过算子融合、更好的内存访问模式或提高算术强度来减少内存流量。
- 位于 受计算限制 区域(水平边界之下)的 kernel 受计算吞吐量限制。GPU 有足够的数据但处理得不够快。优化应聚焦于算法改进或利用 Tensor Cores 等专用硬件。
达到值(achieved value)(图上绘制的点)显示了你的 kernel 当前所处的位置。从该点到 roofline 边界的距离代表了你的优化空间:越接近边界,你的 kernel 性能就越优。
在我们的示例中,kernel 位于受内存限制的区域,表明通过优化内存流量仍有改进空间。
既然我们理解了 GPU 内部 发生的事情,让我们放大视野,探索 GPU 如何与外部世界通信。
GPU 外部:GPU 如何与世界对话
我们已经讲述了 GPU 如何利用其内部内存层次结构进行计算,但此刻我们需要正视一个关键现实:GPU 并非孤立运作。在任何计算发生之前,数据必须被加载到 GPU 的内存中。CPU 需要调度 kernel 并协调工作。而在分布式训练中,GPU 之间必须不断交换激活值、梯度和模型权重。
这意味着外部通信基础设施至关重要。无论你的 GPU 计算单元多么强大,如果数据无法足够快地到达它们——无论是来自 CPU、来自存储,还是来自其他 GPU——你那昂贵的硬件都将闲置。理解这些通信通路及其带宽特性,对于最大化硬件利用率和最小化瓶颈至关重要。
在本节中,我们将考察连接 GPU 与外部世界的四条关键通信链路:
- CPU–GPU(CPU 如何调度工作并向 GPU 传输数据)
- GPU–GPU 节点内(intranode)(同一台机器上的 GPU 如何通信)
- GPU–GPU 节点间(internode)(不同机器上的 GPU 如何通过网络通信)
- GPU–存储(数据如何从存储流向 GPU 内存)
这些链路各有不同的带宽和延迟特性,理解它们将帮助你识别训练流水线可能在哪里出现瓶颈。为了便于理解,我们制作了一张简化图,突出最重要的组件和通信链路:
如果这看起来令人不知所措,别担心。我们将逐一详细剖析这些连接,并测量它们的实际带宽,以理解每条链路的性能特征。
CPU 到 GPU 的通信
TL;DR: CPU 通过 PCIe 连接来编排 GPU 工作,在我们的 P5 实例中,CPU 到 GPU 传输的瓶颈约为 14.2 GB/s(PCIe Gen4 x8)。CPU–GPU 延迟约为 1.4 微秒(μs),这会增加 kernel 启动开销,对于有许多小 kernel 的工作负载尤其麻烦。CUDA Graphs 可以通过批处理操作来减少这种开销。在多插槽(multi-socket)系统上,NUMA 亲和性至关重要;在错误的 CPU 插槽上运行 GPU 进程会增加显著的延迟。像 Grace Hopper 这样的现代架构用 NVLink-C2C 消除了 PCIe 瓶颈(900 GB/s 对比 128 GB/s)。
CPU 是 GPU 计算的编排者。它负责启动 kernel、管理内存分配以及协调数据传输。但 CPU 实际上能以多快的速度与 GPU 通信?这由它们之间的 PCIe(Peripheral Component Interconnect Express) 连接决定。
理解这条链路至关重要,因为它影响:
- Kernel 启动延迟(CPU 在 GPU 上调度工作的速度)
- 数据传输速度(我们在 CPU 和 GPU 内存之间移动数据的速度)
- 同步开销(CPU–GPU 协调点的代价)
在现代 GPU 服务器中,CPU–GPU 连接已经有了显著演进。早期系统使用直接的 PCIe 连接,而像 DGX H100 这样的现代高性能系统则使用更复杂的拓扑,配以 PCIe 交换机(switches) 来高效管理多块 GPU。而在最新的 GB200 架构中,NVIDIA 更进一步,将 CPU 和 GPU 放在同一块印刷电路板上,完全消除了对外部交换机的需求。
让我们使用 lstopo 检查我们 P5 实例的物理拓扑,然后测量这条关键链路的实际性能,以识别潜在瓶颈:
$ lstopo -v
...
HostBridge L#1 (buses=0000:[44-54])
    PCIBridge L#2 (busid=0000:44:00.0 id=1d0f:0200 class=0604(PCIBridge) link=15.75GB/s buses=0000:[45-54] PCISlot=64)
        PCIBridge L#3 (busid=0000:45:00.0 id=1d0f:0200 class=0604(PCIBridge) link=15.75GB/s buses=0000:[46-54] PCISlot=1-1)
            ...
            PCIBridge L#12 (busid=0000:46:01.4 id=1d0f:0200 class=0604(PCIBridge) link=63.02GB/s buses=0000:[53-53])
                PCI L#11 (busid=0000:53:00.0 id=10de:2330 class=0302(3D) link=63.02GB/s PCISlot=86-1)
                    Co-Processor(CUDA) L#8 (Backend=CUDA GPUVendor="NVIDIA Corporation" GPUModel="NVIDIA H100 80GB HBM3" CUDAGlobalMemorySize=83295872 CUDAL2CacheSize=51200 CUDAMultiProcessors=132 CUDACoresPerMP=128 CUDASharedMemorySizePerMP=48) "cuda0"
                    GPU(NVML) L#9 (Backend=NVML GPUVendor="NVIDIA Corporation" GPUModel="NVIDIA H100 80GB HBM3" NVIDIASerial=1654922006536 NVIDIAUUID=GPU-ba136838-6443-7991-9143-1bf4e48b2994) "nvml0"
            ...
...
从 lstopo 的输出中,我们可以看到系统中两个关键的 PCIe 带宽值:
- 15.75GB/s: 对应 PCIe Gen4 x8 链路(CPU 到 PCIe 交换机)
- 63.02GB/s: 对应 PCIe Gen5 x16 链路(PCIe 交换机到 GPU)
为了更好地理解整个拓扑,我们可以将其可视化:
$ lstopo --whole-system lstopo-diagram.png

这张图展示了我们系统的层次结构。目前需要注意的关键点是:
- 它包含两个 非统一内存访问(Non-Uniform Memory Access, NUMA) 节点(每个 CPU 插槽一个内存区)。
- 每个 CPU 插槽 通过 PCIe Gen4 x8 链路(15.75 GB/s)连接到四个 PCIe 交换机。
- 每个 PCIe 交换机 通过 PCIe Gen5 x16 链路(63.02 GB/s)连接到一块 H100 GPU。
我们将在后续章节探讨其他组件,比如 NVSwitch、EFA 网卡和 NVMe 驱动器。
PCIe 规格在各世代之间有所不同,每一代都将每条 lane 的传输速率翻倍,如下表所示。请注意,传输速率以 GT/s(每秒千兆次传输,gigatransfers per second)衡量,表示原始信号速率,而吞吐量以 GB/s(每秒千兆字节,gigabytes per second)衡量,已计入编码开销,表示实际可用的带宽:
| PCIe 版本 | 传输速率(每 Lane) | 吞吐量(GB/s) |
|---|---|---|
| ×1 | ×2 | ×4 |
| 1.0 | 2.5 GT/s | 0.25 |
| 2.0 | 5.0 GT/s | 0.5 |
| 3.0 | 8.0 GT/s | 0.985 |
| 4.0 | 16.0 GT/s | 1.969 |
| 5.0 | 32.0 GT/s | 3.938 |
| 6.0 | 64.0 GT/s | 7.563 |
| 7.0 | 128.0 GT/s | 15.125 |
从拓扑图和 PCIe 带宽表中,我们可以看到 CPU 到 GPU 的路径要经过两个 PCIe 跳转(hop):首先从 CPU 经 PCIe Gen4 x8(15.754 GB/s)到 PCIe 交换机,然后从 PCIe 交换机经 PCIe Gen5 x16(63.015 GB/s)到 GPU。这意味着 CPU–GPU 通信的瓶颈在于第一跳,即 15.754 GB/s。让我们用另一个工具 nvbandwidth 来验证这一点。
host_to_device_memcpy_ce 命令使用 GPU 的复制引擎,测量从主机(CPU)内存到设备(GPU)内存的 cuMemcpyAsync 带宽:
$ ./nvbandwidth -t host_to_device_memcpy_ce -b <message_size> -i 5
结果确实表明,对于较小的消息大小我们受限于延迟,但对于较大的消息大小我们达到了约 14.2 GB/s,约为 PCIe Gen4 x8 理论 15.754 GB/s 带宽的 90%。这证实了在 CPU–GPU 通信中,CPU 到 PCIe 交换机的链路是我们的瓶颈。
除了带宽之外, 延迟(latency) 对 CPU–GPU 通信同样重要,因为它决定了我们调度 kernel 的速度。为了测量它,我们使用 host_device_latency_sm 测试,该测试通过在主机(CPU)上分配一个缓冲区,并使用指针追逐(pointer-chase)kernel 从 GPU 访问它,来测量往返延迟。这模拟了真实世界中 CPU–GPU 通信的延迟:
$ ./nvbandwidth -t host_device_latency_sm -i 5
结果表明延迟约为 1.4 μs。这解释了我们在 ML 工作负载中经常观察到的几微秒的 kernel 启动开销。对于启动许多小 kernel 的工作负载,这增加的延迟会成为瓶颈;否则,这种开销会被重叠执行所隐藏。
CUDA Graphs 可以通过捕获一系列操作并将它们作为单个单元重放,显著减少这种开销,消除每次 kernel 启动数微秒的 CPU–GPU 往返延迟。这对于有许多小 kernel 或频繁 CPU–GPU 同步的工作负载尤为有益。关于理解和优化启动开销的更多细节,请参阅 NVIDIA 技术博客上的 “Understanding the Visualization of Overhead and Latency in NVIDIA Nsight Systems”。
某些混合专家(mixture-of-experts)模型的实现需要在每次迭代中进行 CPU–GPU 同步,以便为选中的专家调度相应的 kernel。这引入了 kernel 启动开销,会显著影响吞吐量,尤其是当 CPU–GPU 连接较慢时。例如,在 MakoGenerate 对 DeepSeek MOE kernel 的优化中,参考实现在每次前向传播中调度了 1,043 个 kernel,带有 67 个 CPU–GPU 同步点。通过重构专家路由机制,他们将其减少到 533 次 kernel 启动和仅 3 个同步点,实现了同步开销 97% 的降低和端到端延迟 44% 的降低。请注意,并非所有 MoE 实现都需要 CPU–GPU 同步(现代实现通常将路由完全保留在 GPU 上),但对于那些需要的实现来说,高效的 CPU–GPU 通信对性能至关重要。
与传统的 x86+Hopper 系统相比,NVIDIA 的 Grace Hopper 超级芯片采取了一种根本不同的 CPU–GPU 通信方法。关键改进包括:
- 1:1 的 GPU 与 CPU 比例(相比 x86+Hopper 的 4:1),为每块 GPU 提供 3.5 倍更高的 CPU 内存带宽
- NVLink-C2C 取代 PCIe Gen5 lane,提供 900 GB/s 对比 128 GB/s(GPU–CPU 链路带宽高出 7 倍)
- NVLink Switch System 提供比通过 PCIe Gen4 连接的 InfiniBand NDR400 网卡高 9 倍的 GPU–GPU 链路带宽
更多细节请参阅 “NVIDIA Grace Hopper Superchip Architecture” 白皮书(第 11 页)。
NUMA 亲和性:多插槽性能的关键
在像我们的 AMD EPYC 7R13 节点(2 个插槽,每个 48 核)这样的多插槽系统上,NUMA 亲和性 对 GPU 性能至关重要。NUMA 亲和性指的是将进程运行在与其目标设备(如 GPU)共享同一插槽的 CPU 核心上。当你的 GPU 进程运行在与 GPU 所连接的 NUMA 节点不同的 CPU 上时,操作必须穿越 CPU 互连(AMD Infinity Fabric),从而增加显著的延迟和带宽限制。
检查 NUMA 拓扑和节点距离将让你更好地理解其性能影响:
$ numactl --hardware
node distances:
node   0   1
  0:  10  32
  1:  32  10
访问同一 NUMA 节点上的内存(距离 10)将比跨越到另一个 NUMA 节点(距离 32)快得多。当你的进程被固定(pin)到错误的 NUMA 节点时,这 3.2 倍的内存访问延迟差异会显著影响 GPU 性能。
关于诊断和解决 NUMA 相关性能问题的详细步骤,请参阅本章后面的 “排查互连问题” 一节。
GPU 到 GPU 的节点内通信
TL;DR: 节点内的 GPU 可以通过三种方式通信:经过 CPU(最慢,约 3 GB/s,受 PCIe 瓶颈限制)、通过 EFA 网卡上的 GPUDirect RDMA(约 38 GB/s),或通过 NVLink 上的 GPUDirect RDMA(双向约 786 GB/s)。NVLink 快 9–112 倍,并且完全绕过了 CPU/PCIe。NCCL 在 NVLink 可用时会自动优先选择它。NVLink SHARP(NVLS)提供硬件加速的集合通信(collectives),将 all-reduce 性能提升 1.3 倍至 480 GB/s。然而,all-to-all 操作(340 GB/s)并不受益于 NVLS 加速。
在分布式训练中,GPU 必须频繁交换梯度、权重和激活值,每次迭代往往达数 GB 数据。传输如此海量的数据需要对通信进行精心处理。虽然 H100 的内部 HBM 读取速度约为 3 TB/s,但不小心使用了错误的标志位(flags)就能彻底拖垮你的 GPU 间通信带宽。
让我们通过考察同一节点上 GPU 通信的所有方式(以及你应该——或不应该!——设置的所有标志位),来看看原因。
经过 CPU
最朴素的方法使用主机内存(SHM):数据从 GPU1 经 PCIe 交换机到 CPU、进入主机内存,再经 CPU 返回、再次经 PCIe 交换机,最终到达 GPU2。这可以通过在 NCCL 的环境变量中设置 NCCL_P2P_DISABLE=1 和 FI_PROVIDER=tcp 来实现(尽管不推荐)。当这种模式被激活时,你可以通过设置 NCCL_DEBUG=INFO 来验证它是否生效,这会显示类似如下的消息:
NCCL INFO Channel 00 : 1[1] -> 0[0] via SHM/direct/direct
这条迂回的路径涉及多次内存复制,并使 PCIe 和 CPU 内存总线都饱和,造成拥塞。在我们的拓扑中,四块 H100 共享相同的 CPU 内存总线,当多块 GPU 试图同时通信时,由于它们争夺相同的有限 CPU 内存带宽,这种拥塞变得更加严重。
采用这种 CPU 中介的方法,我们从根本上受限于 CPU 与 PCIe 交换机之间约 16 GB/s 的 PCIe Gen4 x8 链路。幸运的是,我们的 GPU 有一种更好的、无需 CPU 参与的通信方式:GPUDirect RDMA。
经过 libfabric EFA
GPUDirect RDMA (Remote Direct Memory Access,远程直接内存访问),或称 GDRDMA,是一种通过允许直接访问 GPU 内存来实现 NVIDIA GPU 之间直接通信的技术。这消除了数据通过系统 CPU 的需求,并避免了经系统内存的缓冲区复制,相比传统的 CPU 中介传输,可带来高达 10 倍的性能提升。GPUDirect RDMA 通过 PCIe 工作,既能在节点内(如此处所述)实现快速的 GPU 间通信,也能借助具备 RDMA 能力的网卡(NIC)跨节点实现,我们将在后续章节中看到。
回顾我们的拓扑图,可以看到每个 PCIe 交换机有四块 EFA(Elastic Fabric Adapter,弹性结构适配器)网卡,这意味着每块 GPU 都能访问四个 EFA 适配器。EFA 是 AWS 为云实例定制的高性能网络接口,旨在提供低延迟、高吞吐的实例间通信。在 P5 实例上,EFA 暴露了一个 libfabric 接口(一种面向高性能应用的通信 API),它提供对类 RDMA 能力的访问,例如用于跨节点 GPU 直接通信的 GPUDirect RDMA。
让我们更仔细地看看系统拓扑的相关部分以及 EFA 链路的细节:
$ lstopo -v
...
## 我们可以看到每个 PCIe 交换机有 4 个这样的 EFA 设备
PCIBridge L#8 (busid=0000:46:01.0 id=1d0f:0200 class=0604(PCIBridge) link=15.75GB/s buses=0000:[4f-4f] PCIVendor="Amazon.com, Inc.")
PCI L#6 (busid=0000:4f:00.0 id=1d0f:efa1 class=0200(Ethernet) link=15.75GB/s PCISlot=82-1 PCIVendor="Amazon.com, Inc.")
    OpenFabrics L#4 (NodeGUID=cd77:f833:0000:1001 SysImageGUID=0000:0000:0000:0000 Port1State=4 Port1LID=0x0 Port1LMC=1 Port1GID0=fe80:0000:0000:0000:14b0:33ff:fef8:77cd) "rdmap79s0"
...

$ fi_info --verbose
        fi_link_attr:
            address: EFA-fe80::14b0:33ff:fef8:77cd
            mtu: 8760            # maximum packet size is 8760 bytes
            speed: 100000000000  # each EFA link provides 100 Gbps of bandwidth
            state: FI_LINK_UP
            network_type: Ethernet
每条 EFA 链路提供 100 Gbps(12.5 GB/s)的带宽。每块 GPU 有 4 块 EFA 网卡,每个节点有 8 块 GPU,这就给出了每节点 100 × 4 × 8 = 3,200 Gbps(400 GB/s)的聚合带宽。
为确保你启用了基于 EFA 的 GPUDirect RDMA,你应该设置 FI_PROVIDER=efa 和 NCCL_P2P_DISABLE=1 环境变量。当这种模式被激活时,你可以通过设置 NCCL_DEBUG=INFO 来验证它是否生效,这会显示类似如下的消息:
NCCL INFO Channel 01/1 : 1[1] -> 0[0] [receive] via NET/Libfabric/0/GDRDMA/Shared
虽然基于 EFA 的 GPUDirect RDMA 相比 CPU 中介传输有显著改善——每块 GPU 配四块 EFA 卡时可达到约 50 GB/s——但我们能做得更好吗?这就轮到 NVLink 登场了。
经过 NVLink NVLink 是 NVIDIA 的高速、直接 GPU 间互连技术,能在服务器内实现快速的多 GPU 通信。下表比较了各世代的 NVLink 带宽(展示理论规格)。H100 采用 NVLink 4.0,通过 18 条各自双向运行于 50 GB/s 的链路,为每块 GPU 提供 900 GB/s 的双向带宽。
| NVLink 2.0 (Volta) | NVLink 3.0 (Ampere) | NVLink 4.0 (Hopper) | NVLink 5.0 (Blackwell) |
|---|---|---|---|
| Bandwidth | 300 GB/s | 600 GB/s | 900 GB/s |
在 DGX H100 架构中,四个第三代 NVSwitch 使用分层拓扑连接八块 GPU,其中每块 GPU 跨各交换机以 5 + 4 + 4 + 5 条链路连接。这种配置确保了任意 GPU 对之间存在多条直接路径,且跳数(hop count)恒定为仅一个 NVSwitch,从而带来 3.6 TB/s 的总双向 NVLink 网络带宽。
默认情况下,NCCL 在 NVLink 可用时会优先将其用于节点内 GPU 通信,因为它在同一台机器上的 GPU 之间提供最低延迟和最高带宽的路径。为确保它被使用,请避免通过 NCCL 环境变量禁用 NVLink 支持——你可不想因为没有正确设置标志位而无意中阻止了它的使用!
NVLink 实现了无需 CPU 或系统内存参与的直接 GPU 间内存访问。当它不可用时,NCCL 会回退到经 PCIe 的 GPUDirect P2P,或在跨插槽 PCIe 传输次优时使用共享内存(SHM)传输。
要验证 NVLink 正在被使用,请设置 NCCL_DEBUG=INFO 并查找类似如下的消息:
NCCL INFO Channel 00/1 : 0[0] -> 1[1] via P2P/CUMEM
下图说明了使用 NVLink 时数据所走的直接路径。
以 NVLink 4.0 的理论带宽 900 GB/s 对比 EFA 的约 50 GB/s,我们预期节点内通信会有 18 倍的优势。为了在实践中验证这一点,我们运行了 NCCL 的 SendRecv 性能测试来测量不同通信路径下的实际带宽:
$ FI_PROVIDER=XXX NCCL_P2P_DISABLE=X sendrecv_perf -b 8 -e 8G -f 2 -g 1 -c 1 -n 100
这毫无疑问地展示了 NVLink 高效得多:它达到了 364.93 GB/s,相比 EFA 的 38.16 GB/s(快 9 倍,或双向 18 倍)和 CPU 基线的 3.24 GB/s(快 112.6 倍)。这些测量证实了为什么 NCCL 在节点内 GPU 通信中优先选择 NVLink,不过为了再做一项测试,让我们用 nvbandwidth 通过双向同时复制来测量所有 GPU 对之间的双向带宽:
$ ./nvbandwidth -t device_to_device_bidirectional_memcpy_write_ce -b <message_size> -i 5
memcpy CE GPU(row) <-> GPU(column) Total bandwidth (GB/s)
           0         1         2         3         4         5         6         7
 0       N/A    785.81    785.92    785.90    785.92    785.78    785.92    785.90
 1    785.83       N/A    785.87    785.83    785.98    785.90    786.05    785.94
 2    785.87    785.89       N/A    785.83    785.96    785.83    785.96    786.03
 3    785.89    785.85    785.90       N/A    785.96    785.89    785.90    785.96
 4    785.87    785.96    785.92    786.01       N/A    785.98    786.14    786.08
 5    785.81    785.92    785.85    785.89    785.89       N/A    786.10    786.03
 6    785.94    785.92    785.99    785.99    786.10    786.05       N/A    786.07
 7    785.94    786.07    785.99    786.01    786.05    786.05    786.14       N/A

SUM device_to_device_bidirectional_memcpy_write_ce_total 44013.06
测得的 786 GB/s 双向带宽代表了 NVLink 4.0 理论 900 GB/s 规格的 85%。使用 NVLink 进行 GPU 间通信完全绕过了 CPU 瓶颈!
但这如何转化为集合通信(collective communication)模式呢?让我们用 NCCL Tests 中的 all_reduce_perf 基准测试来测量单节点内的 all-reduce 性能:
$ ./all_reduce_perf -b 8 -e 16G -f 2 -g 1 -c 1 -n 100
但等等……我们达到了 480 GB/s,这超过了 NVLink 4.0 的理论单向带宽 450 GB/s。这是什么魔法,怎么可能呢?
深入查阅文档后,答案似乎在于 NVLink SHARP(NVLS),即 NVIDIA 的硬件加速集合操作技术。它在单个节点的 H100 GPU 上为 all-reduce 操作提供了约 1.3 倍的加速!
关于 NVSwitch 如何实现这些硬件加速集合操作的技术细节,请参阅 NVSwitch 架构演示。
它们在其他地方也能帮上忙吗?让我们考察一下 all-to-all 性能:
$ ./all_to_all_perf -b 8 -e 16G -f 2 -g 1 -c 1 -n 100
我们在 all-to-all 操作上达到了 340 GB/s,这与显示 H100 系统配合 NVLink 4.0 有相似性能特征的已发布基准测试相符。与 all-reduce 不同,all-to-all 操作不受益于 NVLS 硬件加速,这就解释了为什么我们在这里看到 340 GB/s,而 all-reduce 达到了 480 GB/s。all-to-all 模式需要所有 GPU 对之间进行更复杂的点对点数据交换,纯粹依赖 NVLink 的基础带宽,而非 NVSwitch 的集合加速特性。
某些优化过的 kernel 通过分配专用的 warp 来处理传输,从而将 NVLink 通信与计算分离。例如,ThunderKittens 使用一种 warp 级设计,让特定的 warp 发起 NVLink 传输并等待完成,同时其他 warp 继续执行计算操作。这种 SM 计算与 NVLink 通信的细粒度重叠,可以隐藏大部分 GPU 间通信延迟。关于实现细节,请参阅 ThunderKittens 关于多 GPU kernel 的博客文章。
虽然 NVLink 在单个节点内提供了卓越的带宽,但训练前沿模型需要跨多个节点扩展。
这引入了一个新的潜在瓶颈:节点间网络互连,它的带宽显著低于 NVLink。
GPU 到 GPU 的节点间通信
TL;DR: 多节点 GPU 通信使用高速网络,如 InfiniBand(400 Gbps)或 RoCE(100 Gbps)。All-reduce 扩展性良好(320–350 GB/s,跨节点稳定),使大规模训练集群成为可能。由于算法复杂度,all-to-all 退化得更剧烈:延迟从节点内的约 13 μs 跳升到节点间的 55 μs 以上。对于需要频繁 all-to-all 操作的 MoE 工作负载,NVSHMEM 提供异步的、由 GPU 发起的通信,其性能显著优于由 CPU 编排的传输。
随着模型规模超出单个节点所能容纳的范围,训练需要将计算分布到通过高速网络连接的多个节点上。在深入基准测试之前,让我们看看在多节点 GPU 集群中你会遇到的三种用于连接节点的关键网络技术:
- 以太网(Ethernet) 已从 1 Gbps 演进到 100+ Gbps 的速度,至今仍广泛用于 HPC 和数据中心集群。
- RoCE(RDMA over Converged Ethernet) 为以太网网络带来 RDMA 能力,使用显式拥塞通知(Explicit Congestion Notification, ECN)进行拥塞控制,而非传统的 TCP 机制。
- InfiniBand 是 NVIDIA 的行业标准交换结构(switch fabric),提供高达 400 Gbps 的带宽和亚微秒级延迟,并支持 RDMA,通过 GPUDirect RDMA 在绕过主机 CPU 的同时实现直接的 GPU 间内存访问。
Li et al. (2022) 提供了更多细节,但总结如下:
| 技术 | Ethernet (25–100 Gbps) | Ethernet (200–400 Gbps) | RoCE | InfiniBand |
|---|---|---|---|---|
| 制造商 | 众多 | 众多 | 众多 | NVIDIA/Mellanox |
| 单向带宽 (Gbps) | 25–100 | 200–400 | 100 | 400 |
| 端到端延迟 (μs) | 10–30 | N/A | ~1 | <1 |
| RDMA | 否 | 否 | 是 | 是 |
在 AWS P5 实例上,弹性结构适配器(Elastic Fabric Adapter, EFA)充当网络接口(NIC)。如我们前面所见,每块 GPU 通过 PCIe Gen5 x16 链路连接到四块 100 Gbps 的 EFA 网卡。
当 GPU 和网卡连接到同一个 PCIe 交换机时(如此处所示), GPUDirect RDMA 使它们的通信能够仅通过该交换机进行。这种设置允许充分利用 PCIe Gen5 x16 带宽,并避免涉及其他 PCIe 交换机或 CPU 内存总线。
理论上,每节点 8 个 PCIe 交换机 × 每交换机 4 块 EFA 网卡 × 每块 EFA 网卡 100 Gbps,得出 3,200 Gbps(400 GB/s)的带宽,这正是我们在 AWS 的 P5 规格中找到的带宽。但这在实践中成立吗?让我们运行与之前相同的基准测试,但这次跨不同节点,来一探究竟!
带宽分析
点对点的 send/receive 操作在 2–4 个节点时达到约 42–43 GB/s,但在 5 个及以上节点时下降到约 21 GB/s。这种性能下降是因为当扩展超过 4 个节点时,NCCL 会自动将每个 peer 的点对点 channel 数量从 2 减少到 1,从而有效地将可用带宽利用率减半,而理论最大值仍为约 50 GB/s(4 块 EFA 网卡 × 各 12.5 GB/s)。我们通过设置 NCCL_NCHANNELS_PER_NET_PEER=2 成功在 5 个及以上节点上恢复了此测试的完整吞吐量,不过这个标志位应谨慎使用,因为它可能会损害例如 all-to-all 的性能(详见 GitHub issue #1272)。
All-reduce 操作在单个节点内表现出色,达到 480 GB/s 的总线带宽(bus bandwidth)。扩展到 2 个节点时,带宽几乎保持不变,为 479 GB/s,此后在 3–16 个节点时稳定在约 320–350 GB/s。这一模式揭示了一个重要特征:虽然在跨越节点边界时由于从 NVLink 过渡到节点间网络结构会有一个初始下降,但 随后随着我们添加更多节点,带宽几乎恒定地扩展。
这种超过两个节点后近乎恒定的扩展行为,对于大规模训练实际上相当令人鼓舞。在 3–16 个节点上相对稳定的 320–350 GB/s 表明,依赖 all-reduce 操作的并行策略(例如数据并行)可以扩展到数百乃至数千块 GPU,而不会出现显著的每 GPU 带宽退化。这种对数扩展特性是采用 8 轨(8-rail)优化胖树(fat tree)的精心设计的多层网络拓扑所特有的,其中 8 块 GPU 各自连接到一条独立的交换机轨道(switch rail),以最大化二分带宽(bisection bandwidth)。现代前沿训练集群通常运行在 100,000+ 块 GPU 上,而正是这种稳定的扩展行为使如此大规模的部署成为可能。
当处理不同带宽的链路(节点内的 NVLink 与节点间网络)时,可以考虑让你的并行策略适配每一个带宽层级,以充分利用所有可用带宽。关于为异构网络拓扑优化并行配置的详细指导,请参阅 Ultra-Scale Playbook。
All-to-all 操作表现出更显著的扩展挑战:从单个节点的 344 GB/s 开始,带宽在两个节点时下降到 81 GB/s,并继续下滑到较大集群的约 45–58 GB/s。这种更陡峭的退化反映了 all-to-all 模式密集的网络需求,其中每块 GPU 必须与跨节点的其他每块 GPU 通信,造成的网络拥塞远多于 all-reduce 操作。
延迟分析
延迟测量揭示了跨越节点边界的根本代价。Send/receive 操作在所有多节点配置下都保持相对稳定的 40–53 μs 延迟,表明点对点通信延迟主要由基础网络往返时间决定,而非集群规模,尽管一些变化表明网络拓扑和路由效应仍发挥一定作用。
All-reduce 操作在单个节点内显示出最小的延迟 12.9 μs,但在 2 个节点时跳升到 55.5 μs,并随集群规模近乎线性地持续增长,在 16 个节点时达到 235 μs。这一进展反映了通信距离的增加以及跨更多节点的归约树(reduction tree)日益增长的复杂度。
All-to-all 操作表现出类似的趋势,从单节点通信的 7.6 μs 开始,但在 2 个节点时攀升到 60 μs,在 16 个节点时达到 621 μs。all-to-all 操作延迟的超线性增长表明,随着更多节点参与集合操作,网络拥塞和协调开销会叠加放大。
随着 MoE 架构的兴起——它需要频繁的 all-to-all 通信来进行专家路由——优化过的 GPU 通信库变得日益关键。
NVSHMEM 作为一个高性能通信库正获得显著关注,它将多块 GPU 的内存合并成一个分区全局地址空间(partitioned global address space, PGAS)。与依赖 CPU 编排数据传输的传统基于 MPI 的方法不同,NVSHMEM 支持异步的、由 GPU 发起的操作,消除了 CPU–GPU 同步开销。
NVSHMEM 为 GPU 通信提供了几项关键优势:通过 GPUDirect Async 等技术,GPU 在发起节点间通信时可以完全绕过 CPU,对于小消息(<1 KiB)可实现高达 9.5 倍的吞吐量提升。这对于需要密集网络通信模式的集合操作尤为有益。
该库目前支持配备 Mellanox 适配器(CX-4 或更新版本)的 InfiniBand/RoCE、Slingshot-11(libfabric CXI)以及 Amazon EFA(libfabric EFA)。对于需要细粒度通信强扩展(strong scaling)的应用,NVSHMEM 低开销的单边(one-sided)通信原语相比传统的 CPU 代理方法能显著提升性能。
在 NVSHMEM 文档和这篇详细的 NVIDIA 关于 GPUDirect Async 的博客文章中了解更多。
当带宽测量未达预期时,有几个因素可能在限制性能。理解这些潜在瓶颈对于实现最优互连利用率至关重要。
排查互连问题
如果你遇到低于预期的带宽,请系统性地检查以下方面。
库版本
过时的 NCCL、EFA 或 CUDA 库可能缺少关键的性能优化或 bug 修复。务必验证你运行的是所有通信库的最新、兼容版本。例如,AWS 会定期更新深度学习 AMI,使用针对其硬件优化的库版本。对于重要实验,建议记录这些库的版本。
CPU 亲和性配置
不当的 CPU 亲和性设置会导致不必要的跨 NUMA 流量,从而显著影响 NCCL 性能。每块 GPU 都应绑定到同一 NUMA 节点上的 CPU,以最小化内存访问延迟。GitHub issue #1017 展示了在实践中使用 NCCL_IGNORE_CPU_AFFINITY=1 和 --cpu-bind none 如何帮助显著降低容器延迟。你可以在企业支持门户中了解更多。
网络拓扑与放置
理解你的网络拓扑对于诊断性能问题至关重要。云端的放置组(placement groups)虽然有帮助,但并不保证实例之间的网络跳数最少。在现代数据中心的胖树拓扑中,放置在不同顶层交换机下的实例会因路由路径中额外的网络跳数而经历更高的延迟和潜在更低的带宽。
对于 AWS EC2 用户,实例拓扑 API(Instance Topology API)提供了对网络节点放置的宝贵可见性。在底层(直接连接到实例)共享同一网络节点的实例在物理上最接近,将实现最低延迟的通信。
graph TD
    %% Single Level 1 node
    L1["Level 1
nn-4aed5..."]:::level1

    %% Single Level 2 node
    L2["Level 2
nn-48b0a..."]:::level2

    %% 12 nodes of Level 3
    L3_1["Level 3
nn-d2ad4..."]:::level3
    L3_2["Level 3
nn-2d36a..."]:::level3
    L3_3["Level 3
nn-65fc9..."]:::level3
    L3_4["Level 3
nn-fbb73..."]:::level3
    L3_5["Level 3
nn-65290..."]:::level3
    L3_6["Level 3
nn-27373..."]:::level3
    L3_7["Level 3
nn-5adeb..."]:::level3
    L3_8["Level 3
nn-dbe4f..."]:::level3
    L3_9["Level 3
nn-fde84..."]:::level3
    L3_10["Level 3
nn-3c5c0..."]:::level3
    L3_11["Level 3
nn-94247..."]:::level3
    L3_12["Level 3
nn-8f3c1..."]:::level3

    %% L1 -> L2
    L1 --> L2

    %% L2 -> L3 (12 arrows)
    L2 --> L3_1
    L2 --> L3_2
    L2 --> L3_3
    L2 --> L3_4
    L2 --> L3_5
    L2 --> L3_6
    L2 --> L3_7
    L2 --> L3_8
    L2 --> L3_9
    L2 --> L3_10
    L2 --> L3_11
    L2 --> L3_12

    %% Distribution Level 3 -> Leaf nodes (instance info)
    %% 1st Level 3 has 2 leaves
    L3_1 --> L4_1["ID: 02e1b4f9
ip-26-0-171-102
p5.48xlarge"]:::level4
    L3_1 --> L4_2["ID: 05388ebf
ip-26-0-171-230
p5.48xlarge"]:::level4

    %% 2nd, 3rd, 4th have 1 each
    L3_2 --> L4_3["ID: 03bfac00
ip-26-0-168-30
p5.48xlarge"]:::level4
    L3_3 --> L4_4["ID: d92bab46
ip-26-0-168-95
p5.48xlarge"]:::level4
    L3_4 --> L4_5["ID: 97a542e4
ip-26-0-163-158
p5.48xlarge"]:::level4

    %% 5th has 3
    L3_5 --> L4_6["ID: e2c87e43
ip-26-0-167-9
p5.48xlarge"]:::level4
    L3_5 --> L4_7["ID: afa887ea
ip-26-0-168-120
p5.48xlarge"]:::level4
    L3_5 --> L4_8["ID: 66c12e70
ip-26-0-167-177
p5.48xlarge"]:::level4

    %% 6th, 7th, 8th have 1 each
    L3_6 --> L4_9["ID: 9412bdf3
ip-26-0-168-52
p5.48xlarge"]:::level4
    L3_7 --> L4_10["ID: 87bd4dc8
ip-26-0-167-111
p5.48xlarge"]:::level4
    L3_8 --> L4_11["ID: b001549b
ip-26-0-166-244
p5.48xlarge"]:::level4

    %% 9th has 2
    L3_9 --> L4_12["ID: 10ed8172
ip-26-0-107-245
p5.48xlarge"]:::level4
    L3_9 --> L4_13["ID: 7c1d0a09
ip-26-0-168-238
p5.48xlarge"]:::level4

    %% 10th, 11th, 12th have 1 each
    L3_10 --> L4_14["ID: 925ce932
ip-26-0-167-217
p5.48xlarge"]:::level4
    L3_11 --> L4_15["ID: c9bc34db
ip-26-0-171-168
p5.48xlarge"]:::level4
    L3_12 --> L4_16["ID: 328d5d04
ip-26-0-167-127
p5.48xlarge"]:::level4

    %% Styles
    classDef level1 fill:#c8e6c9
    classDef level2 fill:#e1f5fe
    classDef level3 fill:#fff9c4
classDef level4 fill:#ffcdd2 最小化通信节点之间的网络跳数会直接转化为更好的互连性能。对于小规模实验和消融实验,确保你的实例共置于同一网络交换机上,可以在延迟和带宽利用率两方面带来可测量的差异。
正确的环境变量
网络适配器缺失或不正确的环境变量会严重限制带宽利用率。像 NCCL 这样的通信库依赖特定的配置标志位来启用最优性能特性,例如自适应路由(adaptive routing)、由 GPU 发起的传输以及恰当的缓冲区大小调整。
例如,使用 AWS EFA 时,请确保为你的实例类型设置推荐的 NCCL 和 EFA 环境变量。AWS EFA 速查表提供了关于不同场景下最优标志位配置的全面指导。
容器相关的考量
使用容器(Docker/Enroot)时,有几个配置步骤对于最优 NCCL 性能至关重要:
- 共享内存和固定内存(pinned memory): Docker 容器默认限制了共享内存和固定内存资源。启动容器时使用
-shm-size=1g --ulimit memlock=-1以防止初始化失败。 - NUMA 支持: Docker 默认禁用 NUMA 支持,这可能会阻止 cuMem 主机分配(host allocations)正常工作。通过用
-cap-add SYS_NICE调用 Docker 来启用 NUMA 支持。 - PCI 拓扑发现: 确保正确挂载
/sys,以允许 NCCL 发现 GPU 和网卡的 PCI 拓扑。让/sys暴露一个虚拟 PCI 拓扑可能导致次优性能。
既然你已经知道如何调试 GPU–CPU 和 GPU–GPU 通信中的瓶颈,让我们来看看 GPU 通信中一个通常较少受到关注的方面——与存储层的通信!
GPU 到存储的通信
TL;DR: GPU–存储 I/O 通过数据加载和检查点(checkpointing)影响训练。GPUDirect Storage(GDS)实现 GPU 到存储的直接传输,绕过 CPU 以获得更好性能。即便在我们的集群中未启用 GDS,本地 NVMe RAID(8 块 3.5 TB 驱动器,组成 RAID 0)也能提供 26.59 GiB/s 和 337k IOPS(比网络存储快 6.3 倍),使其成为检查点的理想选择。
GPU 与存储系统之间的连接常被忽视,但它能显著影响训练效率。在训练期间,GPU 需要持续从存储读取数据,并周期性地将模型状态写回存储(即检查点)。对于现代大规模训练任务,如果未经妥善优化,这些 I/O 操作可能成为瓶颈。
理解存储拓扑
GPU 与存储设备之间的物理连接遵循与 GPU 互连类似的层次结构。存储设备通过 PCIe 桥(bridges)连接,理解这一拓扑有助于解释性能特征和潜在瓶颈。
查看 lstopo 给出的系统拓扑,我们可以看到 NVMe 驱动器如何连接到系统。在我们的 P5 实例中,每块 GPU 配有一块 NVMe SSD:
PCIBridge L#13 (busid=0000:46:01.5 id=1d0f:0200 class=0604(PCIBridge) link=15.75GB/s buses=0000:[54-54] PCIVendor="Amazon.com, Inc.")
PCI L#11 (busid=0000:54:00.0 id=1d0f:cd01 class=0108(NVMExp) link=15.75GB/s PCISlot=87-1 PCIVendor="Amazon.com, Inc." PCIDevice="NVMe SSD Controller")
    Block(Disk) L#9 (Size=3710937500 SectorSize=512 LinuxDeviceID=259:2 Model="Amazon EC2 NVMe Instance Storage" Revision=0 SerialNumber=AWS110C9F44F9A530351) "nvme1n1"
一个自然的问题是,GPU 能否在不涉及 CPU 的情况下直接访问 NVMe 驱动器。答案是肯定的,通过 GPUDirect Storage(GDS)。
GPUDirect Storage 是 NVIDIA GPUDirect 技术家族的一部分,它在存储(本地 NVMe 或远程 NVMe-oF)与 GPU 内存之间建立了一条直接数据路径。它通过允许存储控制器附近的直接内存访问(DMA)引擎将数据直接搬入或搬出 GPU 内存,消除了经 CPU 跳转缓冲区(bounce buffers)的不必要内存复制。这减少了 CPU 开销、降低了延迟,并显著提升了像在大型多模态数据集上训练这类数据密集型工作负载的 I/O 性能。
要验证 GPUDirect Storage 是否在你的系统上正确配置,你可以检查 GDS 配置文件并使用提供的诊断工具:
$ /usr/local/cuda/gds/tools/gdscheck.py -p
 =====================
 DRIVER CONFIGURATION:
 =====================
 NVMe               : Supported
 NVMeOF             : Unsupported
 SCSI               : Unsupported
 ScaleFlux CSD      : Unsupported
 NVMesh             : Unsupported
 DDN EXAScaler      : Unsupported
 IBM Spectrum Scale : Unsupported
 NFS                : Unsupported
 BeeGFS             : Unsupported
 WekaFS             : Unsupported
 Userspace RDMA     : Unsupported
 --Mellanox PeerDirect : Enabled
 --rdma library        : Not Loaded (libcufile_rdma.so)
 --rdma devices        : Not configured
 --rdma_device_status  : Up: 0 Down: 0
 =====================
NVMe: Supported 这一行告诉我们 GDS 当前已配置为可用于 NVMe 驱动器,而 Unsupported 标志表示它未为任何其他存储类型配置。如果 GDS 未为你的存储类型正确配置,请参阅 NVIDIA GPUDirect Storage 基准测试与配置指南,了解如何修改位于 /etc/cufile.json 的配置文件。
块存储设备
要了解系统上可用的存储设备,你可以使用 lsblk:
$ lsblk --fs -M
    NAME        FSTYPE            LABEL                   UUID                                 FSAVAIL FSUSE% MOUNTPOINT
...
    nvme0n1
    └─nvme0n1p1 ext4              cloudimg-rootfs         24ec7991-cb5c-4fab-99e5-52c45690ba30  189.7G    35% /
┌┈▶ nvme1n1     linux_raid_member ip-26-0-164-236:MY_RAID d0795631-71f0-37e5-133b-e748befec126
├┈▶ nvme2n1     linux_raid_member ip-26-0-164-236:MY_RAID d0795631-71f0-37e5-133b-e748befec126
├┈▶ nvme3n1     linux_raid_member ip-26-0-164-236:MY_RAID d0795631-71f0-37e5-133b-e748befec126
├┈▶ nvme8n1     linux_raid_member ip-26-0-164-236:MY_RAID d0795631-71f0-37e5-133b-e748befec126
├┈▶ nvme5n1     linux_raid_member ip-26-0-164-236:MY_RAID d0795631-71f0-37e5-133b-e748befec126
├┈▶ nvme4n1     linux_raid_member ip-26-0-164-236:MY_RAID d0795631-71f0-37e5-133b-e748befec126
├┈▶ nvme6n1     linux_raid_member ip-26-0-164-236:MY_RAID d0795631-71f0-37e5-133b-e748befec126
└┬▶ nvme7n1     linux_raid_member ip-26-0-164-236:MY_RAID d0795631-71f0-37e5-133b-e748befec126
 └┈┈md0         xfs                                       dddb6849-e5b5-4828-9034-96da65da27f0   27.5T     1% /scratch
输出展示了系统上的块设备层次结构。这里的关键观察点是:
nvme0n1p1是挂载在/的根 Amazon EBS 文件系统,使用了其完整 291 GB 容量的 35%。- 八块 NVMe 驱动器(
nvme1n1到nvme8n1)被配置为一个名为MY_RAID的 RAID 阵列。 - 该 RAID 阵列以
/dev/md0暴露,格式化为 XFS,挂载在/scratch,可用容量 28 TB(8 × 3.5 TB)。
箭头(┈▶)表示多个 NVMe 设备是同一 RAID 阵列的成员,它们随后组合成单个 md0 设备。
网络存储
除了本地 NVMe 存储,系统还能访问网络附加存储(network-attached storage)系统:
$ df -h
Filesystem                                         Size  Used Avail Use% Mounted on
/dev/root                                          291G  101G  190G  35% /
weka-hopper.hpc.internal.huggingface.tech/default  393T  263T  131T  67% /fsx
10.53.83.155@tcp:/fg7ntbev                         4.5T  2.9T  1.7T  63% /admin
/dev/md0                                            28T  206G   28T   1% /scratch
此输出显示:
/dev/root(291 GB Amazon EBS)是根文件系统,使用率 35%。/fsx(393 TB WekaFS)已用 67%,可用 131 TB。/admin(4.5 TB FSx Lustre)已用 63%,可用 1.7 TB。/dev/md0(28 TB 本地 NVMe RAID)仅使用 1%,在/scratch有 28 TB 可用。这是我们由 8 × 3.5 TB NVMe 实例存储 SSD 组成的 RAID 阵列。
本地 NVMe RAID 阵列(/scratch)提供最快的 I/O 性能,而网络文件系统则为共享数据存储提供更大的容量。
RAID(独立磁盘冗余阵列,Redundant Array of Independent Disks): 通过数据条带化(striping)、奇偶校验(parity)或镜像(mirroring),组合多块驱动器以提升性能和/或可靠性。
NVMe(非易失性内存主机控制器接口规范,Non-Volatile Memory Express): 一种用于 SSD 的高性能存储协议,直接连接到 PCIe,相比 SATA/SAS 提供更高的吞吐量和更低的延迟。
WekaFS: 一种为 AI/ML 工作负载设计的高性能并行文件系统,跨多个节点提供低延迟访问和高吞吐量。
FSx Lustre: 一种为高性能计算设计的并行文件系统,它将元数据服务和数据服务分离到不同的服务器上以实现并行访问。虽然对大文件很有效,但它在涉及许多小文件的元数据密集型 AI/ML 工作负载上可能表现吃力。
基准测试存储带宽
为了理解每种存储系统的性能特征,我们可以使用 GPUDirect Storage 对它们的读/写速度进行基准测试。下面是一个全面的参数化基准测试脚本,用于测试各种配置:
gdsio -f /<disk_path>/gds_test.dat -d 0 -w <n_threads> -s 10G -i <io_size> -x 1 -I 1 -T 10
该基准测试从吞吐量、延迟和 IOPS 等方面评估存储系统性能,并涉及:
-
可扩展性: 性能如何随不同的线程数和 I/O 大小变化。这揭示了不同工作负载模式下的最优配置:
- 小 I/O 大小(64k 到 256k)通常能最大化 IOPS,但可能无法使带宽饱和。
- 大 I/O 大小(2M 到 8M)通常能最大化吞吐量,但会降低 IOPS。
- 线程数对两者都有影响:更多线程可以将总 IOPS 和吞吐量提升至硬件极限。
-
传输方法效率: 比较 GPU_DIRECT、CPU_GPU 与 CPUONLY,展示绕过 CPU 内存的益处:
- GPU_DIRECT 使用 RDMA 将数据直接传输到 GPU 内存,完全绕过 CPU(最低延迟、最高效率、小操作的最佳 IOPS)。
- CPU_GPU 是传统路径,数据先到 CPU 内存,然后再复制到 GPU(增加 CPU 开销和内存带宽争用,降低有效 IOPS)。
- CPUONLY 是不涉及 GPU 的纯 CPU I/O 基线。
IOPS 是每秒完成的单独 I/O 操作数量,根据 gdsio 输出按 ops / total_time 计算。IOPS 对以下情况尤为重要:
- 小 I/O 大小的随机访问模式
- 有许多小文件或分散数据访问的工作负载
类数据库操作,其中每次操作的延迟比原始带宽更重要
更高的 IOPS 表示处理并发、细粒度数据访问的能力更强。
基准测试揭示了我们四种存储系统之间的显著性能差异:
/scratch** (本地 NVMe RAID) 以 26.59 GiB/s 的吞吐量和 337k IOPS 占据主导地位,使其在吞吐量上比 FSx 快 6.3 倍,在 IOPS 上好 6.6 倍。这个由 8 × 3.5 TB NVMe 驱动器组成的本地 RAID 阵列提供了最低的延迟(峰值 IOPS 时 190 μs),并随线程数出色地扩展,在 64 线程配合 1M I/O 大小时达到吞吐量峰值性能。/fsx** (WekaFS) 以 4.21 GiB/s 和 51k IOPS 提供稳健的网络存储性能,使其成为需要合理性能的共享数据的最佳选择。FSx 使用 CPUONLY 传输达到其最佳吞吐量(4.21 GiB/s),而使用 GPU_DIRECT 传输达到其最佳 IOPS(51k)。/admin(FSx Lustre)** 和/root(EBS)** 表现出相似的中等性能,吞吐量约 1.1 GiB/s,但在 IOPS 能力上差异显著。/admin使用 GPU_DIRECT 传输达到其峰值吞吐量(1.13 GiB/s),并使用 CPU_GPU 传输在 17k IOPS 达到峰值(比/root好 24 倍),使其更适合有许多小操作的工作负载。\root较差的 IOPS 性能(730)证实它最适合仅用于大规模顺序操作。
请注意,GPUDirect Storage 当前在我们的集群中未启用,这就解释了为什么 NVMe 存储(/scratch 和 /root)的 GPU_DIRECT 结果相比 CPUONLY 传输表现欠佳。若正确配置 GDS,我们预计 GPU_DIRECT 会在 GPU 到存储的直接传输中展现显著优势,尤其对于高性能 NVMe 阵列。
在所有存储类型中,最大吞吐量出现在 1M I/O 大小,而最大 IOPS 出现在测试的最小大小(64k)。这一经典权衡意味着要根据工作负载特征在原始带宽(大 I/O)和操作并发度(小 I/O)之间做出选择。对于使用大型检查点文件的 ML 训练,/scratch 上 1–8M 的范围提供了最优性能。
小结
至此,你应该对存储层次结构以及训练基础设施中不同组件如何相互作用有了全面的理解。但这里有一个我们希望你带走的关键洞察: 识别瓶颈,正是将理论知识与实践优化区分开来的关键。
在本章中,我们测量了栈中每一层的实际带宽:单块 GPU 内 HBM3 的 3 TB/s、节点内 GPU 之间 NVLink 的 786 GB/s、CPU–GPU 传输 PCIe Gen4 x8 的 14.2 GB/s、节点间网络点对点通信的 42 GB/s,以及从 26.59 GiB/s(本地 NVMe)到 1.1 GiB/s(共享文件系统)不等的存储系统。这些测量揭示了你的训练流水线会在哪里变慢,对于实现高 MFU 至关重要。
然而,仅凭原始带宽数字并不能讲述完整的故事。现代训练系统可以 将计算与通信重叠(overlap),从而有效地将通信成本隐藏在计算操作之后。这种并行化即使在互连缓慢时也有助于缓解瓶颈。关于重叠计算与通信以最大化吞吐量的详细策略,请参阅 Ultra-Scale Playbook。
下图将我们所有的基准测量综合成单一视图,展示了当我们离 GPU 越来越远时带宽如何急剧下降:
既然我们知道了如何识别硬件和软件配置中的瓶颈,让我们看看如何更进一步,确保我们拥有一个能稳定运行数月的有韧性的系统。
构建有韧性的训练系统
拥有快速的硬件只是为 LLM 训练打造良好且稳定基础设施的最低要求。要从训练新手成长为专业人士,你需要超越原始速度来思考,并聚焦于那些不那么光鲜却至关重要的基础设施部分——它们能让整个训练体验更顺畅,并确保最小化停机时间。
在本节中,我们将把焦点从硬件和软件优化转向 生产就绪(production readiness):构建足够健壮以挺过不可避免的故障、足够自动化以无需持续照看、足够灵活以在出问题时适应变化的系统。
节点健康监控与替换
拥有足够快的 GPU 对训练很重要,但由于 LLM 训练运行数周或数月而非一两天,随时间追踪 GPU 健康状况至关重要。通过初始基准测试的 GPU 在长时间训练运行中可能开始出现热降频(thermal throttling)、内存错误或性能退化。在本节中,我们将分享我们应对这一挑战的方式以及我们使用的工具。
在启动 SmolLM3 之前,我们运行了全面的 GPU 诊断。我们使用了 GPU Fryer,这是一个内部工具,用于对 GPU 进行压力测试,检测热降频、内存错误和性能异常。我们还运行了 NVIDIA 的 DCGM Diagnostics,这是一个被广泛使用的工具,通过覆盖计算、PCIe 连接、内存完整性和热稳定性的深度诊断测试,来验证 GPU 硬件、监控性能并识别故障或功率异常的根本原因。这些前置测试捕捉到了两块本会在训练期间引发问题的有问题的 GPU。
下表展示了 DCGM Diagnostics 可以测试的内容:
| 测试级别 | 时长 | 关键测试 |
|---|---|---|
| r1 (Short) | 数秒 | PCIe/NVLink、GPU Memory、Memory BW |
| r2 (Medium) | < 2 分钟 | + Diagnostics、Targeted Stress |
| r3 (Long) | < 30 分钟 | + Targeted Power、NVBandwidth、Memory Stress |
| r4 (Extra Long) | 1–2 小时 | + Input EDPp(所有测试) |
来源: NVIDIA DCGM Diagnostics 文档
下面是我们结果的一个示例:
$ dcgmi diag -r 2 -v -d VERB
Successfully ran diagnostic for group.
+---------------------------+------------------------------------------------+
| Diagnostic | Result |
+===========================+================================================+
| -----  Metadata  ----------+------------------------------------------------ |
| DCGM Version | 3.3.1 |
| Driver Version Detected | 575.57.08 |
| GPU Device IDs Detected | 2330,2330,2330,2330,2330,2330,2330,2330 |
| -----  Deployment  --------+------------------------------------------------ |
| Denylist | Pass |
| NVML Library | Pass |
| CUDA Main Library | Pass |
| Permissions and OS Blocks | Pass |
| Persistence Mode | Pass |
| Environment Variables | Pass |
| Page Retirement/Row Remap | Pass |
| Graphics Processes | Pass |
| Inforom | Pass |

+-----  Integration  -------+------------------------------------------------+
| PCIe | Pass - All |
| Info | GPU 0 GPU to Host bandwidth:  14.26 GB/s, GPU |
| 0 Host to GPU bandwidth:  8.66 GB/s, GPU 0 b |
| idirectional bandwidth: 10.91 GB/s, GPU 0 GPU |
| to Host latency:  2.085 us, GPU 0 Host to GP |
| U latency:  2.484 us, GPU 0 bidirectional lat |
| ency:  3.813 us |

...
+-----  Hardware  ----------+------------------------------------------------+
| GPU Memory | Pass - All |
| Info | GPU 0 Allocated 83892938283 bytes (98.4%) |
| Info | GPU 1 Allocated 83892938283 bytes (98.4%) |
| Info | GPU 2 Allocated 83892938283 bytes (98.4%) |
| Info | GPU 3 Allocated 83892938283 bytes (98.4%) |
| Info | GPU 4 Allocated 83892938283 bytes (98.4%) |
| Info | GPU 5 Allocated 83892938283 bytes (98.4%) |
| Info | GPU 6 Allocated 83892938283 bytes (98.4%) |
| Info | GPU 7 Allocated 83892938283 bytes (98.4%) |

+-----  Stress  ------------+------------------------------------------------+
正如 “训练马拉松” 中所述,由于 SmolLM3 是在一个 Slurm 管理的集群上训练的,我们为整个运行预订了一个 固定的 48 节点预留(reservation)。这种设置使我们能够随时间追踪完全相同的那些节点的健康状况和性能。在训练期间,我们 持续监控 所有节点上的关键指标,如 GPU 温度、内存使用、计算利用率和吞吐量波动。我们使用 Prometheus 从所有 GPU 收集 DCGM 指标,并在 Grafana 仪表板中将其可视化以进行实时监控。关于在 AWS 基础设施上部署 Prometheus 和 Grafana 进行 GPU 监控的详细设置说明,请参阅 awsome-distributed-training 仓库中的示例设置指南。当任何节点出现可疑行为时,一个 Slack 机器人会向我们告警,使我们能够在故障硬件搞垮整个训练运行之前主动替换它。
这种多层方法意味着任何硬件问题都成为可管理的中断。
热现实检验:当 GPU 慢下来时
营销规格假设了完美的散热,但现实更为混乱。GPU 在过热时会自动降低时钟频率,即使在精心设计的系统中也会把性能削减到理论最大值之下。
我们监控来自 DCGM 的 DCGM_FI_DEV_CLOCK_THROTTLE_REASONS 指标来检测热降频。当此指标显示非零值时,GPU 正因过热而自动降低时钟频率。下面的仪表板展示了这些降频事件在实践中如何表现:
热降频不仅伤害受影响的那块 GPU;它会在你整个分布式训练配置中级联扩散。在我们的测试期间,我们观察到单个降频节点如何能显著影响集合通信性能:
这张图表展示了当我们从 1 个节点扩展到 16 个节点时 all-reduce 带宽的退化。请注意 14 个节点之后的急剧下降,从 350 GB/s 降到 100 GB/s,而我们本预期带宽会保持在 300 GB/s 以上。这不是网络问题:单个发生热降频的节点成了瓶颈,迫使所有其他节点在梯度同步期间等待。在分布式训练中,你的速度取决于你最慢的那个节点。
👉 关键教训: 在投入长时间训练运行之前,使用前面提到的那类工具对你的硬件进行压力测试,以识别热和功率限制。使用 DCGM 遥测持续监控温度,并为真实世界的热限制做好规划。验证 GPU 时钟是否设置为最大性能也是一个好习惯。关于为什么 GPU 因功率约束而无法维持其宣传性能的深入探讨,请参阅 Horace He 出色的功率降频分析。
检查点管理
检查点是我们在长时间训练运行期间的安全网。我们定期保存它们,出于三个实际原因:从故障中恢复、通过评估监控训练进度,以及与社区共享中间模型用于研究。其中恢复方面最为重要。如果我们的运行失败了,我们希望从最近保存的检查点重新启动,这样如果立即恢复,我们最多损失一个保存间隔(例如,如果每 4 小时保存一次,则损失 4 小时的训练)。
尽量自动化你的恢复流程。例如在 Slurm 上,你可以直接使用 SBATCH --requeue,这样作业就会从最近的检查点自动重新启动。这样,你就避免了等待有人注意到故障并手动重启所浪费的时间。
在实现你的恢复机制时,有两个重要细节需要记住:
- 检查点保存应在后台进行,不影响训练吞吐量。
- 留意你的存储。在一次 24 天的运行中,每 4 小时保存一次意味着约 144 个检查点。对于大模型和优化器状态,这会迅速累积。在我们的案例中,我们每次只在本地存储一个检查点(最近保存的那个),并将其余的卸载到 S3,以避免占满集群存储。
一个来自过去的惨痛教训
在我们第一次大规模运行(StarCoder-15B)期间,训练历经多次重启都进展顺利。然后,在最后一天,我们发现整个检查点文件夹被脚本末尾一个遗留的 rm -rf $CHECKPOINT_PATH 命令删除了——它来自旧的吞吐量测试。这条破坏性命令只在 Slurm 作业真正完成时才触发,而在之前的重启中这从未发生过。
幸运的是,我们保存了前一天的检查点,所以这只让我们损失了一天的重新训练。教训很明确:永远不要在生产脚本中留下破坏性命令,并在保存后立即自动化检查点备份,而非依赖人工干预。
在我们的 Nanotron 训练中,我们每 2 小时在本地保存一次检查点,立即将每个上传到 S3,然后在确认备份后删除本地副本。恢复时,如果最近的检查点在本地不可用,我们就从 S3 拉取。这种方法节省了存储、确保了备份可用,并实现了快速恢复。
自动化评估
手动运行评估会很快成为瓶颈。它们看起来简单,直到你开始反复进行。为每次运行执行基准测试、追踪并绘制结果会累积成可观的开销。解决方案是什么?预先把一切都自动化!
对于 SmolLM3,我们使用 LightEval 在 Nanotron 检查点上运行评估。每个保存的检查点都会在集群上触发一个评估作业。结果被直接推送到 Weights & Biases 或 Trackio,所以我们只需打开仪表板,看着曲线演变即可。这为我们节省了大量时间,并让评估追踪在整个运行过程中保持一致。
如果你在训练配置中只能自动化一件事,那就自动化评估。
最后,让我们看看如何优化训练布局以最大化吞吐量。
优化训练吞吐量
我们最后一个基础设施考量是优化训练布局,即模型如何分布在可用的 GPU 上。这把我们引向一个关键问题……
我们需要多少块 GPU?
在所有关于规格和基准测试的讨论之后,你仍然需要回答一个实际问题:你究竟应该租用或购买多少块 GPU?
确定正确的 GPU 数量需要在训练时间、成本和扩展效率之间取得平衡。下面是我们使用的框架。
基本规模计算公式:
这个公式将问题分解为三个关键组成部分:
- 所需总 FLOPs: 训练你的模型所需的计算工作量(取决于模型大小、训练 token 数和架构)
- 每 GPU 吞吐量: 每块 GPU 实际能提供的每秒 FLOPs 数(不是理论峰值!)
- 目标训练时间: 你愿意为训练完成等待多久
关键洞察:你需要估计 现实的吞吐量,而非依赖峰值规格。这意味着要考虑模型 FLOPs 利用率(你在实践中实际达到的理论峰值性能百分比)。
对于 SmolLM3,我们的计算如下:
- 模型大小: 3B 参数
- 训练 token 数: 11T token
- 目标训练时间: 约 4 周
- 预期 MFU: 30%(基于相似规模的实验)
首先,我们使用标准的 transformer 近似——每 token 6N** FLOPs(其中 N = 参数数量)——来计算所需的总 FLOPs:
以我们预期的 30% MFU,我们的有效每 GPU 吞吐量变为:
将其代入我们的规模计算公式,我们得到:
这个计算指向了 375–400 块 H100,我们最终拿到了 384 块——这个数字与我们的并行策略很好地契合,并给了我们一个现实的四周时间线,还为节点故障和重启等意外问题留了一些缓冲。
为什么更多 GPU 并不总是更好:Amdahl 定律的实际作用
这里有一个反直觉的真相:添加更多 GPU 实际上可能让你的训练变慢。 这正是 Amdahl 定律(Amdahl’s law) 发挥作用之处。
Amdahl 定律指出,并行化带来的加速从根本上受限于你工作负载中串行(不可并行化)部分。在 LLM 训练中,这个”串行”部分主要是 通信开销:即在 GPU 之间同步梯度/权重/激活值所花的时间,这些是无法通过并行化消除的。
公式为:
如果对于像我们这样的小模型,通信占据每个训练步的 10%,那么无论你添加多少 GPU,你都永远无法获得超过 10 倍的加速。更糟的是,随着你添加更多 GPU,通信占比往往会增加,因为:
- 更多 GPU = 更多 all-reduce 参与者 = 更长的同步时间。
- 网络延迟/带宽成为瓶颈。
- 小模型无法将通信隐藏在计算之后。
对于 SmolLM3,我们采用了弱扩展(weak scaling)原则:我们的全局批量大小随 GPU 数量扩展,全局上大致维持每块 GPU 8k token。这让我们的通信与计算之比保持合理,同时最大化吞吐量。
寻找最优并行配置
一旦你拿到了 GPU,下一个挑战就是配置它们以实际高效地训练。为此,并行策略变得至关重要。
我们遵循 Ultra-Scale Playbook 寻找最优训练配置的方法。该 playbook 将问题分解为三个连续的步骤:首先确保模型能装入内存,然后达到你的目标批量大小,最后优化以获得最大吞吐量。让我们走一遍我们如何将其应用于 SmolLM3。
步骤 1:让一个训练步装入内存
第一个问题很简单:我们的 SmolLM3 3B 模型究竟能否装入单块 H100 的 80 GB 内存?为了回答这个问题,我们使用了 Nanotron 的 predict_memory 工具,它估计模型参数、优化器状态、梯度和激活值的内存消耗。
结果显示我们已逼近 80 GB 的上限。这意味着我们需要某种形式的并行来减少每 GPU 的内存占用,无论是张量并行(将模型层跨 GPU 切分)、流水线并行(将模型深度跨 GPU 切分),还是 ZeRO 优化器分片(分布优化器状态)。没有至少其中一种策略,我们将无法高效训练,甚至可能根本无法训练。
步骤 2:达到目标全局批量大小
一旦我们知道借助某种形式的并行模型能装入内存,我们就需要确定如何达到我们约 200 万 token 的目标全局批量大小(global batch size, GBS)。这一约束给出了我们的第一个方程:
其中:
- DP(数据并行,data parallelism)是数据并行副本的数量。
- MBS(微批量大小,micro-batch size)是每块 GPU 每个微批次处理的 token 数。
- GRAD_ACC(梯度累积,gradient accumulation)是在一次优化器步骤之前的前向/反向传播次数。
- SEQLEN(序列长度,sequence length)是每个序列的 token 数(第一个预训练阶段为 4,096)。
我们还有一个来自 384 块 H100 的硬件约束:
其中:
- TP(张量并行,tensor parallelism)表示用于在每一层内对模型权重矩阵进行分片的 GPU 数量。
- PP(流水线并行,pipeline parallelism)表示用于将模型各层跨 GPU 划分的流水线阶段(pipeline stage)数量。
这两个方程定义了我们的搜索空间。
步骤 3:优化训练吞吐量
确立了约束之后,我们需要找到能最大化训练吞吐量的并行配置。搜索空间由硬件拓扑和模型架构定义。
如我们前面所见,我们的硬件配置呈现出两种截然不同的互连类型:用于节点内通信的 NVLink(900 GB/s)和用于节点间通信的 EFA(约 50 GB/s)。这一拓扑自然建议至少使用两种形式的并行来匹配我们的网络特性。这些互连之间显著的带宽差异将极大地影响哪些并行策略效果最佳。
从模型角度看,SmolLM3 的架构约束了我们的选择。由于我们不使用混合专家架构,我们不需要 专家并行(expert parallelism)。同样,在第一阶段以 4,096 token 的序列长度训练意味着 上下文并行(context parallelism) 不是必需的。这就给我们留下了三个主要的并行维度可供探索: 数据并行(DP)、 张量并行(TP) 和 流水线并行(PP)。
鉴于步骤 2 给出的约束,我们需要扫描(sweep)若干参数:
- 带 ZeRO 变体的 DP(ZeRO-0、ZeRO-1、ZeRO-3):取值从 1 到 384,约束为 2 和/或 3 的倍数。
- TP(1、2、3、4、6、8):保持在单个节点内,以充分利用 NVLink 的高带宽。
- PP(1..48):将模型深度跨 GPU 切分。
- MBS(2、3、4、5):取决于并行带来的内存节省,我们可以增大 MBS 以更好地利用 Tensor Cores。
- 激活检查点(Activation checkpointing)(无、选择性、完全):以额外的计算换取减少的内存和通信。
- Kernel 优化:在可用之处使用 CUDA Graphs 和优化过的 kernel。
虽然这看起来是数量惊人的组合,但一个实用的方法是先独立地对每个维度进行基准测试,并淘汰那些显著损害吞吐量的配置。关键洞察在于,并非所有并行策略都生而平等。有些会引入远超其收益的通信开销,尤其是在我们的规模上。
在我们的案例中,流水线并行表现出较差的性能特征。PP 需要跨节点频繁进行流水线气泡(pipeline bubble)同步,而对于我们这个相对较小的 3B 模型,通信开销抵消了任何潜在收益。此外,我们没有获得能够完全消除流水线气泡的高效 PP 调度方案,这进一步限制了 PP 的可行性。同样,0 以上的 ZeRO 级别引入了显著的 all-gather 和 reduce-scatter 操作,对吞吐量的损害超过了它们在内存上的帮助。这些早期的基准测试让我们能够大幅缩小搜索空间,聚焦于将数据并行与适度张量并行相结合的配置。
为了评估每种配置,我们运行五次迭代的基准测试,并记录 每 GPU 每秒 token 数(tokens per second per GPU),这最终是我们关心的指标。我们使用 Weights & Biases 和 Trackio 来记录吞吐量和配置,使比较不同并行策略变得容易。
在系统性地对 Nanotron 中可用的选项进行基准测试后,我们确定了 DP = 192,它利用节点间 EFA 带宽进行数据并行的梯度同步。这意味着 192 个独立的模型副本,每个处理不同批次的数据。对于张量并行,我们选择了 TP = 2,将张量并行通信保持在单个节点内,以充分利用 NVLink 的高带宽。这将每层的权重矩阵跨两块 GPU 切分,要求前向和反向传播进行快速通信。
我们的微批量大小( MBS = 3 )在内存使用和计算效率之间取得了平衡。更大的批量大小会更好地利用 Tensor Cores,但我们已经逼近内存极限。最后,我们选择了 ZeRO-0,意味着不进行优化器状态分片。虽然 ZeRO-1 或 ZeRO-3 本可以减少内存占用,但跨我们 384 块 GPU 收集和分散优化器状态的通信开销会显著损害吞吐量。
这一配置达到了我们约 200 万 token 的目标全局批量大小(192 × 3 × 1 × 4,096 ≈ 2.3M),同时在我们的 384-H100 集群上最大化了吞吐量。你可以在 stage1_8T.yaml 中查看完整的训练配置。
这就把我们带到了基础设施讲解的结尾。现在让我们退后一步,反思更宏观的图景:我们涵盖了什么、学到了什么,以及这一切将引向何方。
结语
我们从一个简单的问题开始了这段旅程:在 2026 年,训练一个高性能 LLM(大语言模型)到底需要什么?为了回答这个问题,我们走过了完整的训练流水线(pipeline),从预训练(pretraining)到后训练(post-training),不仅展示了我们所使用的技术,更呈现了让这些技术奏效的方法论。
我们首先介绍了”训练指南针”——一个用于判断是否值得开展训练的决策框架,随后展示了如何将目标转化为具体的架构(architecture)决策。你看到了如何搭建可靠的消融实验(ablation)流程、逐一测试变更,以及如何从数十亿 token 的小规模实验扩展到数万亿 token 的大规模训练。我们记录了规模扩展时可能出现的基础设施挑战(吞吐量崩溃、dataloader 瓶颈、隐蔽的 bug),以及监控与系统性降险如何帮助你早发现、快调试。
我们还展示了从基础模型(base model)到有用助手(helpful assistant)的过程同样需要系统化方法:在训练之前先建立评估基准(evals),反复迭代 SFT(有监督微调)数据混合,应用偏好优化(preference optimization),以及可选择地进一步引入强化学习(RL)。你看到了”感觉测试”(vibe testing)如何发现指标遗漏的 bug,聊天模板(chat templates)如何悄无声息地破坏指令遵循,以及为什么数据混合的比例平衡在后训练阶段与预训练阶段同等重要。
贯穿预训练和后训练两个阶段,我们始终回归同样的核心洞见:通过实验验证一切,每次只改变一个变量,预期规模扩展会以新的方式引发问题,让使用场景驱动决策而非追逐每一篇新论文。正是遵循这一过程,我们训练出了 SmolLM3——一个具有竞争力的 30 亿参数多语言推理模型,支持长上下文(long context)。一路走来,我们学到了很多关于什么有效、什么会出问题、以及出错时如何调试的经验。我们尽力在此将一切都记录下来,成功与失败皆有。
下一步?
本指南涵盖了现代 LLM 训练的基础知识,但这个领域正在快速演进。以下是一些深入学习的方向:
- 亲自运行实验。 阅读消融实验的相关内容固然有用,但自己动手运行才能真正明白什么重要。选一个小模型,搭建评估基准,开始实验。
- 阅读源代码。 Nanotron、TRL 等训练框架均为开源。理解其实现细节能揭示论文所略过的诸多细节。
- 关注最新工作。 近期最先进模型的论文展示了这个领域的走向。参考文献部分收录了我们精心筛选的有影响力论文和资源列表。
我们希望本指南能帮助你以清晰和自信的姿态迎接下一个训练项目——无论你身处大型实验室推动前沿,还是在小团队中解决具体问题。
现在去训练点什么吧。当你的 loss(损失)在凌晨 2 点神秘飙升时,请记住:每一个伟大的模型背后都有调试的故事。愿开源与开放科学的力量永远与你同在!
致谢
我们感谢 Guilherme、Hugo 和 Mario 提供的宝贵反馈,以及 Abubakar 在 Trackio 功能方面给予的帮助。
参考文献
以下是一份精选的论文、书籍和博客文章列表,它们在我们的 LLM 训练旅程中给予了我们深刻的启发。
LLM 架构
- 稠密模型(Dense models):Llama 3、OLMo 2、MobileLLM
- MoEs(混合专家模型):DeepSeek-V2、DeepSeek-V3、Scaling Laws of Efficient MoEs
- 混合模型(Hybrid models):MiniMax-01, Mamba2
优化器(Optimizers)与训练参数
- Muon is Scalable for LLM Training、Fantastic Pretraining Optimizers
- Large Batch Training、DeepSeek LLM
数据整理(Data Curation)
- 网页数据:FineWeb & FineWeb-Edu、FineWeb2、DCLM
- 代码数据:The Stack v2、To Code or Not to Code
- 数学数据:DeepSeekMath、FineMath、MegaMath
- 数据混合:SmolLM2、Does Your Data Spark Joy?
规模扩展定律(Scaling Laws)
后训练(Post-Training)
- InstructGPT:OpenAI 将基础模型转化为有用助手的奠基性论文。ChatGPT 的前身,也是人类沿卡尔达肖夫指数攀升的关键一步。
- Llama 2 & 3:Meta 关于其 Llama 模型训练过程的极为详尽的技术报告(愿其安息)。两份报告均包含大量关于人类数据收集的洞见,涵盖人类偏好数据和模型评估数据两个方面。
- Secrets of RLHF in LLMs(LLM 中 RLHF 的秘密),第一部分 & 第二部分:这两篇论文包含大量关于 RLHF(基于人类反馈的强化学习)运作细节的干货,尤其是如何训练强大的奖励模型(reward model)。
- Direct Preference Optimization(直接偏好优化,DPO):2023 年的突破性论文,让所有人停止在 LLM 上做强化学习。
- DeepSeek-R1:2025 年的突破性论文,让所有人重新开始在 LLM 上做强化学习。
- Understanding R1-Zero-Like Training (Dr. GRPO):理解 GRPO 内嵌偏差及其修复方法最重要的论文之一。
- DAPO:字节跳动分享了大量实现细节,旨在为社区解锁稳定的 R1-Zero 式训练。
- ScaleRL: Meta 的大规模实验,为 RL 推导出规模扩展定律。耗费超过 40 万 GPU 小时,建立了一套在多个数量级计算量上可靠扩展的训练方案。
- LoRA Without Regret:一篇写得极为精彩的博客文章,发现使用低秩 LoRA 进行 RL 训练可以媲美全量微调(full fine-tuning)——这是一个令人惊喜的结果。
- Command A:Cohere 发布的极为详尽的技术报告,介绍了有效对 LLM 进行后训练的各种策略。
基础设施(Infrastructure)
训练框架(Training Frameworks)
评估(Evaluation)
Footnotes
-
Benchmaxxing(刷榜)指的是训练一个模型,使其在一个狭窄的公开 benchmark 集合上表现良好,却以在现实世界任务上的表现为代价的做法。
-
对于 vLLM,参见:reasoning parsers、tool parsers。对于 SGLang,参见:reasoning parsers、tool parsers。
-
计算这些统计数据的想法来自 Llama 3 技术报告 (Grattafiori et al., 2024)。
-
Transformers 团队最近添加了用于提取工具调用和推理输出的 parsers。如果这些被 vLLM 这样的引擎采纳,那么兼容性标准在未来可能会变得不那么重要。
- Agarwal, R., Vieillard, N., Zhou, Y., Stanczyk, P., Ramos, S., Geist, M., & Bachem, O. (2024). On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes. https://arxiv.org/abs/2306.13649
- Ainslie, J., Lee-Thorp, J., de Jong, M., Zemlyanskiy, Y., Lebrón, F., & Sanghai, S. (2023). GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. https://arxiv.org/abs/2305.13245 back: 1, 2
- Allal, L. B., Lozhkov, A., Bakouch, E., Blázquez, G. M., Penedo, G., Tunstall, L., Marafioti, A., Kydlíček, H., Lajarín, A. P., Srivastav, V., Lochner, J., Fahlgren, C., Nguyen, X.-S., Fourrier, C., Burtenshaw, B., Larcher, H., Zhao, H., Zakka, C., Morlon, M., … Wolf, T. (2025). SmolLM2: When Smol Goes Big – Data-Centric Training of a Small Language Model. https://arxiv.org/abs/2502.02737 back: 1, 2, 3
- Almazrouei, E., Alobeidli, H., Alshamsi, A., Cappelli, A., Cojocaru, R., Debbah, M., Goffinet, É., Hesslow, D., Launay, J., Malartic, Q., Mazzotta, D., Noune, B., Pannier, B., & Penedo, G. (2023). The Falcon Series of Open Language Models. https://arxiv.org/abs/2311.16867
- An, C., Huang, F., Zhang, J., Gong, S., Qiu, X., Zhou, C., & Kong, L. (2024). Training-Free Long-Context Scaling of Large Language Models. https://arxiv.org/abs/2402.17463
- Aryabumi, V., Su, Y., Ma, R., Morisot, A., Zhang, I., Locatelli, A., Fadaee, M., Üstün, A., & Hooker, S. (2024). To Code, or Not To Code? Exploring Impact of Code in Pre-training. https://arxiv.org/abs/2408.10914
- Bai, J., Bai, S., Chu, Y., Cui, Z., Dang, K., Deng, X., Fan, Y., Ge, W., Han, Y., Huang, F., Hui, B., Ji, L., Li, M., Lin, J., Lin, R., Liu, D., Liu, G., Lu, C., Lu, K., … Zhu, T. (2023). Qwen Technical Report. https://arxiv.org/abs/2309.16609
- Barres, V., Dong, H., Ray, S., Si, X., & Narasimhan, K. (2025). τ2-Bench: Evaluating Conversational Agents in a Dual-Control Environment. https://arxiv.org/abs/2506.07982
- Beck, M., Pöppel, K., Lippe, P., & Hochreiter, S. (2025). Tiled Flash Linear Attention: More Efficient Linear RNN and xLSTM Kernels. https://arxiv.org/abs/2503.14376
- Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., Neelakantan, A., Shyam, P., Sastry, G., Askell, A., Agarwal, S., Herbert-Voss, A., Krueger, G., Henighan, T., Child, R., Ramesh, A., Ziegler, D. M., Wu, J., Winter, C., … Amodei, D. (2020). Language Models are Few-Shot Learners. https://arxiv.org/abs/2005.14165
- Chen, M., Tworek, J., Jun, H., Yuan, Q., de Oliveira Pinto, H. P., Kaplan, J., Edwards, H., Burda, Y., Joseph, N., Brockman, G., Ray, A., Puri, R., Krueger, G., Petrov, M., Khlaaf, H., Sastry, G., Mishkin, P., Chan, B., Gray, S., … Zaremba, W. (2021). Evaluating Large Language Models Trained on Code. https://arxiv.org/abs/2107.03374
- Chen, Y., Huang, B., Gao, Y., Wang, Z., Yang, J., & Ji, H. (2025a). Scaling Laws for Predicting Downstream Performance in LLMs. https://arxiv.org/abs/2410.08527
- Chen, Y., Huang, B., Gao, Y., Wang, Z., Yang, J., & Ji, H. (2025b). Scaling Laws for Predicting Downstream Performance in LLMs. https://arxiv.org/abs/2410.08527
- Child, R., Gray, S., Radford, A., & Sutskever, I. (2019). Generating long sequences with sparse transformers. arXiv Preprint arXiv:1904.10509.
- Chowdhery, A., Narang, S., Devlin, J., Bosma, M., Mishra, G., Roberts, A., Barham, P., Chung, H. W., Sutton, C., Gehrmann, S., Schuh, P., Shi, K., Tsvyashchenko, S., Maynez, J., Rao, A., Barnes, P., Tay, Y., Shazeer, N., Prabhakaran, V., … Fiedel, N. (2022). PaLM: Scaling Language Modeling with Pathways. https://arxiv.org/abs/2204.02311 back: 1, 2, 3, 4
- Chu, T., Zhai, Y., Yang, J., Tong, S., Xie, S., Schuurmans, D., Le, Q. V., Levine, S., & Ma, Y. (2025). SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training. https://arxiv.org/abs/2501.17161
- Cobbe, K., Kosaraju, V., Bavarian, M., Chen, M., Jun, H., Kaiser, L., Plappert, M., Tworek, J., Hilton, J., Nakano, R., Hesse, C., & Schulman, J. (2021). Training Verifiers to Solve Math Word Problems. https://arxiv.org/abs/2110.14168
- Cohere, T., :, Aakanksha, Ahmadian, A., Ahmed, M., Alammar, J., Alizadeh, M., Alnumay, Y., Althammer, S., Arkhangorodsky, A., Aryabumi, V., Aumiller, D., Avalos, R., Aviv, Z., Bae, S., Baji, S., Barbet, A., Bartolo, M., Bebensee, B., … Zhao, Z. (2025). Command A: An Enterprise-Ready Large Language Model. https://arxiv.org/abs/2504.00698
- Dagan, G., Synnaeve, G., & Rozière, B. (2024). Getting the most out of your tokenizer for pre-training and domain adaptation. https://arxiv.org/abs/2402.01035 back: 1, 2
- Dao, T., & Gu, A. (2024). Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality. https://arxiv.org/abs/2405.21060 back: 1, 2
- DeepSeek-AI. (2025). DeepSeek-V3.2-Exp: Boosting Long-Context Efficiency with DeepSeek Sparse Attention. DeepSeek. https://github.com/deepseek-ai/DeepSeek-V3.2-Exp/blob/main/DeepSeek_V3_2.pdf
- DeepSeek-AI, :, Bi, X., Chen, D., Chen, G., Chen, S., Dai, D., Deng, C., Ding, H., Dong, K., Du, Q., Fu, Z., Gao, H., Gao, K., Gao, W., Ge, R., Guan, K., Guo, D., Guo, J., … Zou, Y. (2024). DeepSeek LLM: Scaling Open-Source Language Models with Longtermism. https://arxiv.org/abs/2401.02954 back: 1, 2
- DeepSeek-AI, Guo, D., Yang, D., Zhang, H., Song, J., Zhang, R., Xu, R., Zhu, Q., Ma, S., Wang, P., Bi, X., Zhang, X., Yu, X., Wu, Y., Wu, Z. F., Gou, Z., Shao, Z., Li, Z., Gao, Z., … Zhang, Z. (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. https://arxiv.org/abs/2501.12948
- DeepSeek-AI, Liu, A., Feng, B., Wang, B., Wang, B., Liu, B., Zhao, C., Dengr, C., Ruan, C., Dai, D., Guo, D., Yang, D., Chen, D., Ji, D., Li, E., Lin, F., Luo, F., Hao, G., Chen, G., … Xie, Z. (2024). DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. https://arxiv.org/abs/2405.04434 back: 1, 2, 3
- DeepSeek-AI, Liu, A., Feng, B., Xue, B., Wang, B., Wu, B., Lu, C., Zhao, C., Deng, C., Zhang, C., Ruan, C., Dai, D., Guo, D., Yang, D., Chen, D., Ji, D., Li, E., Lin, F., Dai, F., … Pan, Z. (2025). DeepSeek-V3 Technical Report. https://arxiv.org/abs/2412.19437 back: 1, 2
- Dehghani, M., Djolonga, J., Mustafa, B., Padlewski, P., Heek, J., Gilmer, J., Steiner, A., Caron, M., Geirhos, R., Alabdulmohsin, I., Jenatton, R., Beyer, L., Tschannen, M., Arnab, A., Wang, X., Riquelme, C., Minderer, M., Puigcerver, J., Evci, U., … Houlsby, N. (2023). Scaling Vision Transformers to 22 Billion Parameters. https://arxiv.org/abs/2302.05442
- Ding, H., Wang, Z., Paolini, G., Kumar, V., Deoras, A., Roth, D., & Soatto, S. (2024). Fewer Truncations Improve Language Modeling. https://arxiv.org/abs/2404.10830
- D’Oosterlinck, K., Xu, W., Develder, C., Demeester, T., Singh, A., Potts, C., Kiela, D., & Mehri, S. (2024). Anchored Preference Optimization and Contrastive Revisions: Addressing Underspecification in Alignment. https://arxiv.org/abs/2408.06266
- Du, Z., Zeng, A., Dong, Y., & Tang, J. (2025). Understanding Emergent Abilities of Language Models from the Loss Perspective. https://arxiv.org/abs/2403.15796
- Dubois, Y., Galambosi, B., Liang, P., & Hashimoto, T. B. (2025). Length-Controlled AlpacaEval: A Simple Way to Debias Automatic Evaluators. https://arxiv.org/abs/2404.04475
- Ethayarajh, K., Xu, W., Muennighoff, N., Jurafsky, D., & Kiela, D. (2024). KTO: Model Alignment as Prospect Theoretic Optimization. https://arxiv.org/abs/2402.01306
- Gandhi, K., Chakravarthy, A., Singh, A., Lile, N., & Goodman, N. D. (2025). Cognitive Behaviors that Enable Self-Improving Reasoners, or, Four Habits of Highly Effective STaRs. https://arxiv.org/abs/2503.01307
- Gao, T., Wettig, A., Yen, H., & Chen, D. (2025). How to Train Long-Context Language Models (Effectively). https://arxiv.org/abs/2410.02660 back: 1, 2, 3
- Grattafiori, A., Dubey, A., Jauhri, A., Pandey, A., Kadian, A., Al-Dahle, A., Letman, A., Mathur, A., Schelten, A., Vaughan, A., Yang, A., Fan, A., Goyal, A., Hartshorn, A., Yang, A., Mitra, A., Sravankumar, A., Korenev, A., Hinsvark, A., … Ma, Z. (2024). The Llama 3 Herd of Models. https://arxiv.org/abs/2407.21783 back: 1, 2, 3
- Gu, A., & Dao, T. (2024). Mamba: Linear-Time Sequence Modeling with Selective State Spaces. https://arxiv.org/abs/2312.00752
- Gu, Y., Tafjord, O., Kuehl, B., Haddad, D., Dodge, J., & Hajishirzi, H. (2025). OLMES: A Standard for Language Model Evaluations. https://arxiv.org/abs/2406.08446 back: 1, 2
- Guo, S., Zhang, B., Liu, T., Liu, T., Khalman, M., Llinares, F., Rame, A., Mesnard, T., Zhao, Y., Piot, B., Ferret, J., & Blondel, M. (2024). Direct Language Model Alignment from Online AI Feedback. https://arxiv.org/abs/2402.04792
- Hägele, A., Bakouch, E., Kosson, A., Allal, L. B., Werra, L. V., & Jaggi, M. (2024). Scaling Laws and Compute-Optimal Training Beyond Fixed Training Durations. https://arxiv.org/abs/2405.18392 back: 1, 2
- He, Y., Jin, D., Wang, C., Bi, C., Mandyam, K., Zhang, H., Zhu, C., Li, N., Xu, T., Lv, H., Bhosale, S., Zhu, C., Sankararaman, K. A., Helenowski, E., Kambadur, M., Tayade, A., Ma, H., Fang, H., & Wang, S. (2024). Multi-IF: Benchmarking LLMs on Multi-Turn and Multilingual Instructions Following. https://arxiv.org/abs/2410.15553
- Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., de Las Casas, D., Hendricks, L. A., Welbl, J., Clark, A., Hennigan, T., Noland, E., Millican, K., van den Driessche, G., Damoc, B., Guy, A., Osindero, S., Simonyan, K., Elsen, E., … Sifre, L. (2022). Training Compute-Optimal Large Language Models. https://arxiv.org/abs/2203.15556
- Hong, J., Lee, N., & Thorne, J. (2024). ORPO: Monolithic Preference Optimization without Reference Model. https://arxiv.org/abs/2403.07691
- Howard, J., & Ruder, S. (2018). Universal Language Model Fine-tuning for Text Classification. https://arxiv.org/abs/1801.06146
- Hsieh, C.-P., Sun, S., Kriman, S., Acharya, S., Rekesh, D., Jia, F., Zhang, Y., & Ginsburg, B. (2024). RULER: What’s the Real Context Size of Your Long-Context Language Models? https://arxiv.org/abs/2404.06654 back: 1, 2
- Hu, S., Tu, Y., Han, X., He, C., Cui, G., Long, X., Zheng, Z., Fang, Y., Huang, Y., Zhao, W., Zhang, X., Thai, Z. L., Zhang, K., Wang, C., Yao, Y., Zhao, C., Zhou, J., Cai, J., Zhai, Z., … Sun, M. (2024). MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies. https://arxiv.org/abs/2404.06395
- Huang, S., Noukhovitch, M., Hosseini, A., Rasul, K., Wang, W., & Tunstall, L. (2024). The N+ Implementation Details of RLHF with PPO: A Case Study on TL;DR Summarization. https://arxiv.org/abs/2403.17031
- IBM Research. (2025). IBM Granite 4.0: Hyper-efficient, High Performance Hybrid Models for Enterprise. https://www.ibm.com/new/announcements/ibm-granite-4-0-hyper-efficient-high-performance-hybrid-models
- Jiang, A. Q., Sablayrolles, A., Mensch, A., Bamford, C., Chaplot, D. S., de las Casas, D., Bressand, F., Lengyel, G., Lample, G., Saulnier, L., Lavaud, L. R., Lachaux, M.-A., Stock, P., Scao, T. L., Lavril, T., Wang, T., Lacroix, T., & Sayed, W. E. (2023). Mistral 7B. https://arxiv.org/abs/2310.06825
- Kamradt, G. (2023). Needle In A Haystack - pressure testing LLMs. In GitHub repository. GitHub. https://github.com/gkamradt/LLMTest_NeedleInAHaystack back: 1, 2
- Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J., & Amodei, D. (2020). Scaling Laws for Neural Language Models. https://arxiv.org/abs/2001.08361
- Katsch, T. (2024). GateLoop: Fully Data-Controlled Linear Recurrence for Sequence Modeling. https://arxiv.org/abs/2311.01927
- Kazemnejad, A., Padhi, I., Ramamurthy, K. N., Das, P., & Reddy, S. (2023). The Impact of Positional Encoding on Length Generalization in Transformers. https://arxiv.org/abs/2305.19466
- Khatri, D., Madaan, L., Tiwari, R., Bansal, R., Duvvuri, S. S., Zaheer, M., Dhillon, I. S., Brandfonbrener, D., & Agarwal, R. (2025). The Art of Scaling Reinforcement Learning Compute for LLMs. https://arxiv.org/abs/2510.13786 back: 1, 2
- Kingma, D. P. (2014). Adam: A method for stochastic optimization. arXiv Preprint arXiv:1412.6980.
- Lambert, N., Castricato, L., von Werra, L., & Havrilla, A. (2022). Illustrating Reinforcement Learning from Human Feedback (RLHF). Hugging Face Blog.
- Lambert, N., Morrison, J., Pyatkin, V., Huang, S., Ivison, H., Brahman, F., Miranda, L. J. V., Liu, A., Dziri, N., Lyu, S., Gu, Y., Malik, S., Graf, V., Hwang, J. D., Yang, J., Bras, R. L., Tafjord, O., Wilhelm, C., Soldaini, L., … Hajishirzi, H. (2025). Tulu 3: Pushing Frontiers in Open Language Model Post-Training. https://arxiv.org/abs/2411.15124
- Lanchantin, J., Chen, A., Lan, J., Li, X., Saha, S., Wang, T., Xu, J., Yu, P., Yuan, W., Weston, J. E., Sukhbaatar, S., & Kulikov, I. (2025). Bridging Offline and Online Reinforcement Learning for LLMs. https://arxiv.org/abs/2506.21495
- Li, J., Fang, A., Smyrnis, G., Ivgi, M., Jordan, M., Gadre, S., Bansal, H., Guha, E., Keh, S., Arora, K., Garg, S., Xin, R., Muennighoff, N., Heckel, R., Mercat, J., Chen, M., Gururangan, S., Wortsman, M., Albalak, A., … Shankar, V. (2025). DataComp-LM: In search of the next generation of training sets for language models. https://arxiv.org/abs/2406.11794
- Li, Q., Cui, L., Zhao, X., Kong, L., & Bi, W. (2024). GSM-Plus: A Comprehensive Benchmark for Evaluating the Robustness of LLMs as Mathematical Problem Solvers. https://arxiv.org/abs/2402.19255
- Li, R., Allal, L. B., Zi, Y., Muennighoff, N., Kocetkov, D., Mou, C., Marone, M., Akiki, C., Li, J., Chim, J., Liu, Q., Zheltonozhskii, E., Zhuo, T. Y., Wang, T., Dehaene, O., Davaadorj, M., Lamy-Poirier, J., Monteiro, J., Shliazhko, O., … de Vries, H. (2023). StarCoder: may the source be with you! https://arxiv.org/abs/2305.06161
- Li, T., Chiang, W.-L., Frick, E., Dunlap, L., Wu, T., Zhu, B., Gonzalez, J. E., & Stoica, I. (2024). From Crowdsourced Data to High-Quality Benchmarks: Arena-Hard and BenchBuilder Pipeline. https://arxiv.org/abs/2406.11939
- Liang, W., Liu, T., Wright, L., Constable, W., Gu, A., Huang, C.-C., Zhang, I., Feng, W., Huang, H., Wang, J., Purandare, S., Nadathur, G., & Idreos, S. (2025). TorchTitan: One-stop PyTorch native solution for production ready LLM pre-training. https://arxiv.org/abs/2410.06511
- Lightman, H., Kosaraju, V., Burda, Y., Edwards, H., Baker, B., Lee, T., Leike, J., Schulman, J., Sutskever, I., & Cobbe, K. (2023). Let’s Verify Step by Step. https://arxiv.org/abs/2305.20050
- Liu, H., Xie, S. M., Li, Z., & Ma, T. (2022). Same Pre-training Loss, Better Downstream: Implicit Bias Matters for Language Models. https://arxiv.org/abs/2210.14199
- Liu, Q., Zheng, X., Muennighoff, N., Zeng, G., Dou, L., Pang, T., Jiang, J., & Lin, M. (2025). RegMix: Data Mixture as Regression for Language Model Pre-training. https://arxiv.org/abs/2407.01492
- Liu, Z., Zhao, C., Iandola, F., Lai, C., Tian, Y., Fedorov, I., Xiong, Y., Chang, E., Shi, Y., Krishnamoorthi, R., Lai, L., & Chandra, V. (2024). MobileLLM: Optimizing Sub-billion Parameter Language Models for On-Device Use Cases. https://arxiv.org/abs/2402.14905
- Loshchilov, I., & Hutter, F. (2017). SGDR: Stochastic Gradient Descent with Warm Restarts. https://arxiv.org/abs/1608.03983
- Lozhkov, A., Li, R., Allal, L. B., Cassano, F., Lamy-Poirier, J., Tazi, N., Tang, A., Pykhtar, D., Liu, J., Wei, Y., Liu, T., Tian, M., Kocetkov, D., Zucker, A., Belkada, Y., Wang, Z., Liu, Q., Abulkhanov, D., Paul, I., … de Vries, H. (2024). StarCoder 2 and The Stack v2: The Next Generation. https://arxiv.org/abs/2402.19173
- Marafioti, A., Zohar, O., Farré, M., Noyan, M., Bakouch, E., Cuenca, P., Zakka, C., Allal, L. B., Lozhkov, A., Tazi, N., Srivastav, V., Lochner, J., Larcher, H., Morlon, M., Tunstall, L., von Werra, L., & Wolf, T. (2025). SmolVLM: Redefining small and efficient multimodal models. https://arxiv.org/abs/2504.05299
- McCandlish, S., Kaplan, J., Amodei, D., & Team, O. D. (2018). An Empirical Model of Large-Batch Training. https://arxiv.org/abs/1812.06162
- Meta AI. (2025). The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation. https://ai.meta.com/blog/llama-4-multimodal-intelligence/ back: 1, 2
- Mindermann, S., Brauner, J., Razzak, M., Sharma, M., Kirsch, A., Xu, W., Höltgen, B., Gomez, A. N., Morisot, A., Farquhar, S., & Gal, Y. (2022). Prioritized Training on Points that are Learnable, Worth Learning, and Not Yet Learnt. https://arxiv.org/abs/2206.07137
- MiniMax, Li, A., Gong, B., Yang, B., Shan, B., Liu, C., Zhu, C., Zhang, C., Guo, C., Chen, D., Li, D., Jiao, E., Li, G., Zhang, G., Sun, H., Dong, H., Zhu, J., Zhuang, J., Song, J., … Wu, Z. (2025). MiniMax-01: Scaling Foundation Models with Lightning Attention. https://arxiv.org/abs/2501.08313 back: 1, 2, 3
- Mistral AI. (2025). Mistral Small 3.1. https://mistral.ai/news/mistral-small-3-1
- Moshkov, I., Hanley, D., Sorokin, I., Toshniwal, S., Henkel, C., Schifferer, B., Du, W., & Gitman, I. (2025). AIMO-2 Winning Solution: Building State-of-the-Art Mathematical Reasoning Models with OpenMathReasoning dataset. https://arxiv.org/abs/2504.16891
- Muennighoff, N., Rush, A. M., Barak, B., Scao, T. L., Piktus, A., Tazi, N., Pyysalo, S., Wolf, T., & Raffel, C. (2025). Scaling Data-Constrained Language Models. https://arxiv.org/abs/2305.16264
- Ni, J., Xue, F., Yue, X., Deng, Y., Shah, M., Jain, K., Neubig, G., & You, Y. (2024). MixEval: Deriving Wisdom of the Crowd from LLM Benchmark Mixtures. https://arxiv.org/abs/2406.06565
- Nrusimha, A., Brandon, W., Mishra, M., Shen, Y., Panda, R., Ragan-Kelley, J., & Kim, Y. (2025). FlashFormer: Whole-Model Kernels for Efficient Low-Batch Inference. https://arxiv.org/abs/2505.22758
- Nvidia, :, Adler, B., Agarwal, N., Aithal, A., Anh, D. H., Bhattacharya, P., Brundyn, A., Casper, J., Catanzaro, B., Clay, S., Cohen, J., Das, S., Dattagupta, A., Delalleau, O., Derczynski, L., Dong, Y., Egert, D., Evans, E., … Zhu, C. (2024). Nemotron-4 340B Technical Report. https://arxiv.org/abs/2406.11704
- NVIDIA, :, Basant, A., Khairnar, A., Paithankar, A., Khattar, A., Renduchintala, A., Malte, A., Bercovich, A., Hazare, A., Rico, A., Ficek, A., Kondratenko, A., Shaposhnikov, A., Bukharin, A., Taghibakhshi, A., Barton, A., Mahabaleshwarkar, A. S., Shen, A., … Chen, Z. (2025). NVIDIA Nemotron Nano 2: An Accurate and Efficient Hybrid Mamba-Transformer Reasoning Model. https://arxiv.org/abs/2508.14444
- NVIDIA, :, Blakeman, A., Basant, A., Khattar, A., Renduchintala, A., Bercovich, A., Ficek, A., Bjorlin, A., Taghibakhshi, A., Deshmukh, A. S., Mahabaleshwarkar, A. S., Tao, A., Shors, A., Aithal, A., Poojary, A., Dattagupta, A., Buddharaju, B., Chen, B., … Chen, Z. (2025). Nemotron-H: A Family of Accurate and Efficient Hybrid Mamba-Transformer Models. https://arxiv.org/abs/2504.03624
- OLMo, T., Walsh, P., Soldaini, L., Groeneveld, D., Lo, K., Arora, S., Bhagia, A., Gu, Y., Huang, S., Jordan, M., Lambert, N., Schwenk, D., Tafjord, O., Anderson, T., Atkinson, D., Brahman, F., Clark, C., Dasigi, P., Dziri, N., … Hajishirzi, H. (2025). 2 OLMo 2 Furious. https://arxiv.org/abs/2501.00656 back: 1, 2, 3
- OpenAI, Achiam, J., Adler, S., Agarwal, S., Ahmad, L., Akkaya, I., Aleman, F. L., Almeida, D., Altenschmidt, J., Altman, S., Anadkat, S., Avila, R., Babuschkin, I., Balaji, S., Balcom, V., Baltescu, P., Bao, H., Bavarian, M., Belgum, J., … Zoph, B. (2024). GPT-4 Technical Report. https://arxiv.org/abs/2303.08774
- Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C. L., Mishkin, P., Zhang, C., Agarwal, S., Slama, K., Ray, A., Schulman, J., Hilton, J., Kelton, F., Miller, L., Simens, M., Askell, A., Welinder, P., Christiano, P., Leike, J., & Lowe, R. (2022). Training language models to follow instructions with human feedback. https://arxiv.org/abs/2203.02155
- Penedo, G., Kydlíček, H., allal, L. B., Lozhkov, A., Mitchell, M., Raffel, C., Werra, L. V., & Wolf, T. (2024). The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale. https://arxiv.org/abs/2406.17557
- Penedo, G., Kydlíček, H., Sabolčec, V., Messmer, B., Foroutan, N., Kargaran, A. H., Raffel, C., Jaggi, M., Werra, L. V., & Wolf, T. (2025). FineWeb2: One Pipeline to Scale Them All – Adapting Pre-Training Data Processing to Every Language. https://arxiv.org/abs/2506.20920 back: 1, 2, 3
- Peng, B., Goldstein, D., Anthony, Q., Albalak, A., Alcaide, E., Biderman, S., Cheah, E., Du, X., Ferdinan, T., Hou, H., Kazienko, P., GV, K. K., Kocoń, J., Koptyra, B., Krishna, S., Jr., R. M., Lin, J., Muennighoff, N., Obeid, F., … Zhu, R.-J. (2024). Eagle and Finch: RWKV with Matrix-Valued States and Dynamic Recurrence. https://arxiv.org/abs/2404.05892
- Peng, B., Quesnelle, J., Fan, H., & Shippole, E. (2023). YaRN: Efficient Context Window Extension of Large Language Models. https://arxiv.org/abs/2309.00071 back: 1, 2
- Peng, H., Pappas, N., Yogatama, D., Schwartz, R., Smith, N. A., & Kong, L. (2021). Random Feature Attention. https://arxiv.org/abs/2103.02143
- Petty, J., van Steenkiste, S., Dasgupta, I., Sha, F., Garrette, D., & Linzen, T. (2024). The Impact of Depth on Compositional Generalization in Transformer Language Models. https://arxiv.org/abs/2310.19956
- Polo, F. M., Weber, L., Choshen, L., Sun, Y., Xu, G., & Yurochkin, M. (2024). tinyBenchmarks: evaluating LLMs with fewer examples. https://arxiv.org/abs/2402.14992
- Press, O., Smith, N. A., & Lewis, M. (2022). Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation. https://arxiv.org/abs/2108.12409
- Pyatkin, V., Malik, S., Graf, V., Ivison, H., Huang, S., Dasigi, P., Lambert, N., & Hajishirzi, H. (2025). Generalizing Verifiable Instruction Following. https://arxiv.org/abs/2507.02833
- Qin, Z., Han, X., Sun, W., Li, D., Kong, L., Barnes, N., & Zhong, Y. (2022). The Devil in Linear Transformer. https://arxiv.org/abs/2210.10340
- Qin, Z., Yang, S., Sun, W., Shen, X., Li, D., Sun, W., & Zhong, Y. (2024). HGRN2: Gated Linear RNNs with State Expansion. https://arxiv.org/abs/2404.07904
- Qiu, Z., Huang, Z., Zheng, B., Wen, K., Wang, Z., Men, R., Titov, I., Liu, D., Zhou, J., & Lin, J. (2025). Demons in the Detail: On Implementing Load Balancing Loss for Training Specialized Mixture-of-Expert Models. https://arxiv.org/abs/2501.11873
- Qwen Team. (2025). Qwen3-Next: Towards Ultimate Training & Inference Efficiency. Alibaba Cloud. https://qwen.ai/blog?id=4074cca80393150c248e508aa62983f9cb7d27cd&from=research.latest-advancements-list
- Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., Sutskever, I., & others. (2019). Language models are unsupervised multitask learners. In OpenAI blog (Vol. 1, p. 9).
- Rafailov, R., Sharma, A., Mitchell, E., Ermon, S., Manning, C. D., & Finn, C. (2024). Direct Preference Optimization: Your Language Model is Secretly a Reward Model. https://arxiv.org/abs/2305.18290
- Rein, D., Hou, B. L., Stickland, A. C., Petty, J., Pang, R. Y., Dirani, J., Michael, J., & Bowman, S. R. (2024). Gpqa: A graduate-level google-proof q&a benchmark. First Conference on Language Modeling.
- Rozière, B., Gehring, J., Gloeckle, F., Sootla, S., Gat, I., Tan, X. E., Adi, Y., Liu, J., Sauvestre, R., Remez, T., Rapin, J., Kozhevnikov, A., Evtimov, I., Bitton, J., Bhatt, M., Ferrer, C. C., Grattafiori, A., Xiong, W., Défossez, A., … Synnaeve, G. (2024). Code Llama: Open Foundation Models for Code. https://arxiv.org/abs/2308.12950
- Sennrich, R., Haddow, B., & Birch, A. (2016). Neural Machine Translation of Rare Words with Subword Units. https://arxiv.org/abs/1508.07909
- Shao, Z., Wang, P., Zhu, Q., Xu, R., Song, J., Bi, X., Zhang, H., Zhang, M., Li, Y. K., Wu, Y., & Guo, D. (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. https://arxiv.org/abs/2402.03300
- Shazeer, N. (2019). Fast Transformer Decoding: One Write-Head is All You Need. https://arxiv.org/abs/1911.02150
- Shi, F., Suzgun, M., Freitag, M., Wang, X., Srivats, S., Vosoughi, S., Chung, H. W., Tay, Y., Ruder, S., Zhou, D., Das, D., & Wei, J. (2022). Language Models are Multilingual Chain-of-Thought Reasoners. https://arxiv.org/abs/2210.03057
- Shukor, M., Aubakirova, D., Capuano, F., Kooijmans, P., Palma, S., Zouitine, A., Aractingi, M., Pascal, C., Russi, M., Marafioti, A., Alibert, S., Cord, M., Wolf, T., & Cadene, R. (2025). SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics. https://arxiv.org/abs/2506.01844
- Singh, S., Romanou, A., Fourrier, C., Adelani, D. I., Ngui, J. G., Vila-Suero, D., Limkonchotiwat, P., Marchisio, K., Leong, W. Q., Susanto, Y., Ng, R., Longpre, S., Ko, W.-Y., Ruder, S., Smith, M., Bosselut, A., Oh, A., Martins, A. F. T., Choshen, L., … Hooker, S. (2025). Global MMLU: Understanding and Addressing Cultural and Linguistic Biases in Multilingual Evaluation. https://arxiv.org/abs/2412.03304
- Sirdeshmukh, V., Deshpande, K., Mols, J., Jin, L., Cardona, E.-Y., Lee, D., Kritz, J., Primack, W., Yue, S., & Xing, C. (2025). MultiChallenge: A Realistic Multi-Turn Conversation Evaluation Benchmark Challenging to Frontier LLMs. https://arxiv.org/abs/2501.17399
- Smith, L. N., & Topin, N. (2018). Super-Convergence: Very Fast Training of Neural Networks Using Large Learning Rates. https://arxiv.org/abs/1708.07120
- Su, J., Lu, Y., Pan, S., Murtadha, A., Wen, B., & Liu, Y. (2023). RoFormer: Enhanced Transformer with Rotary Position Embedding. https://arxiv.org/abs/2104.09864
- Sun, Y., Dong, L., Zhu, Y., Huang, S., Wang, W., Ma, S., Zhang, Q., Wang, J., & Wei, F. (2024). You Only Cache Once: Decoder-Decoder Architectures for Language Models. https://arxiv.org/abs/2405.05254
- Takase, S., Kiyono, S., Kobayashi, S., & Suzuki, J. (2025). Spike No More: Stabilizing the Pre-training of Large Language Models. https://arxiv.org/abs/2312.16903
- Team, 5, Zeng, A., Lv, X., Zheng, Q., Hou, Z., Chen, B., Xie, C., Wang, C., Yin, D., Zeng, H., Zhang, J., Wang, K., Zhong, L., Liu, M., Lu, R., Cao, S., Zhang, X., Huang, X., Wei, Y., … Tang, J. (2025). GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models. https://arxiv.org/abs/2508.06471 back: 1, 2
- team, F. C., Copet, J., Carbonneaux, Q., Cohen, G., Gehring, J., Kahn, J., Kossen, J., Kreuk, F., McMilin, E., Meyer, M., Wei, Y., Zhang, D., Zheng, K., Armengol-Estapé, J., Bashiri, P., Beck, M., Chambon, P., Charnalia, A., Cummins, C., … Synnaeve, G. (2025). CWM: An Open-Weights LLM for Research on Code Generation with World Models. https://arxiv.org/abs/2510.02387
- Team, G., Kamath, A., Ferret, J., Pathak, S., Vieillard, N., Merhej, R., Perrin, S., Matejovicova, T., Ramé, A., Rivière, M., Rouillard, L., Mesnard, T., Cideron, G., bastien Jean-Grill, Ramos, S., Yvinec, E., Casbon, M., Pot, E., Penchev, I., … Hussenot, L. (2025). Gemma 3 Technical Report. https://arxiv.org/abs/2503.19786
- Team, K., Bai, Y., Bao, Y., Chen, G., Chen, J., Chen, N., Chen, R., Chen, Y., Chen, Y., Chen, Y., Chen, Z., Cui, J., Ding, H., Dong, M., Du, A., Du, C., Du, D., Du, Y., Fan, Y., … Zu, X. (2025). Kimi K2: Open Agentic Intelligence. https://arxiv.org/abs/2507.20534 back: 1, 2, 3
- Team, L., Zeng, B., Huang, C., Zhang, C., Tian, C., Chen, C., Jin, D., Yu, F., Zhu, F., Yuan, F., Wang, F., Wang, G., Zhai, G., Zhang, H., Li, H., Zhou, J., Liu, J., Fang, J., Ou, J., … He, Z. (2025). Every FLOP Counts: Scaling a 300B Mixture-of-Experts LING LLM without Premium GPUs. https://arxiv.org/abs/2503.05139
- Team, M., Xiao, C., Li, Y., Han, X., Bai, Y., Cai, J., Chen, H., Chen, W., Cong, X., Cui, G., Ding, N., Fan, S., Fang, Y., Fu, Z., Guan, W., Guan, Y., Guo, J., Han, Y., He, B., … Sun, M. (2025). MiniCPM4: Ultra-Efficient LLMs on End Devices. https://arxiv.org/abs/2506.07900
- Tian, C., Chen, K., Liu, J., Liu, Z., Zhang, Z., & Zhou, J. (2025). Towards Greater Leverage: Scaling Laws for Efficient Mixture-of-Experts Language Models. https://arxiv.org/abs/2507.17702 back: 1, 2, 3
- Toshniwal, S., Moshkov, I., Narenthiran, S., Gitman, D., Jia, F., & Gitman, I. (2024). OpenMathInstruct-1: A 1.8 Million Math Instruction Tuning Dataset. https://arxiv.org/abs/2402.10176
- Tunstall, L., Beeching, E., Lambert, N., Rajani, N., Rasul, K., Belkada, Y., Huang, S., von Werra, L., Fourrier, C., Habib, N., Sarrazin, N., Sanseviero, O., Rush, A. M., & Wolf, T. (2023). Zephyr: Direct Distillation of LM Alignment. https://arxiv.org/abs/2310.16944
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., & Polosukhin, I. (2023). Attention Is All You Need. https://arxiv.org/abs/1706.03762 back: 1, 2, 3
- Wang, B., & Komatsuzaki, A. (2021). GPT-J-6B: A 6 Billion Parameter Autoregressive Language Model. https://github.com/kingoflolz/mesh-transformer-jax
- Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv Preprint arXiv:2411.04368.
- Wen, K., Hall, D., Ma, T., & Liang, P. (2025). Fantastic Pretraining Optimizers and Where to Find Them. https://arxiv.org/abs/2509.02046 back: 1, 2
- Xie, S. M., Pham, H., Dong, X., Du, N., Liu, H., Lu, Y., Liang, P., Le, Q. V., Ma, T., & Yu, A. W. (2023). DoReMi: Optimizing Data Mixtures Speeds Up Language Model Pretraining. https://arxiv.org/abs/2305.10429
- Xiong, W., Liu, J., Molybog, I., Zhang, H., Bhargava, P., Hou, R., Martin, L., Rungta, R., Sankararaman, K. A., Oguz, B., Khabsa, M., Fang, H., Mehdad, Y., Narang, S., Malik, K., Fan, A., Bhosale, S., Edunov, S., Lewis, M., … Ma, H. (2023a). Effective Long-Context Scaling of Foundation Models. https://arxiv.org/abs/2309.16039
- Xiong, W., Liu, J., Molybog, I., Zhang, H., Bhargava, P., Hou, R., Martin, L., Rungta, R., Sankararaman, K. A., Oguz, B., Khabsa, M., Fang, H., Mehdad, Y., Narang, S., Malik, K., Fan, A., Bhosale, S., Edunov, S., Lewis, M., … Ma, H. (2023b). Effective Long-Context Scaling of Foundation Models. https://arxiv.org/abs/2309.16039
- Xu, H., Peng, B., Awadalla, H., Chen, D., Chen, Y.-C., Gao, M., Kim, Y. J., Li, Y., Ren, L., Shen, Y., Wang, S., Xu, W., Gao, J., & Chen, W. (2025). Phi-4-Mini-Reasoning: Exploring the Limits of Small Reasoning Language Models in Math. https://arxiv.org/abs/2504.21233
- Yang, A., Li, A., Yang, B., Zhang, B., Hui, B., Zheng, B., Yu, B., Gao, C., Huang, C., Lv, C., Zheng, C., Liu, D., Zhou, F., Huang, F., Hu, F., Ge, H., Wei, H., Lin, H., Tang, J., … Qiu, Z. (2025). Qwen3 Technical Report. https://arxiv.org/abs/2505.09388 back: 1, 2, 3
- Yang, A., Yu, B., Li, C., Liu, D., Huang, F., Huang, H., Jiang, J., Tu, J., Zhang, J., Zhou, J., Lin, J., Dang, K., Yang, K., Yu, L., Li, M., Sun, M., Zhu, Q., Men, R., He, T., … Zhang, Z. (2025). Qwen2.5-1M Technical Report. https://arxiv.org/abs/2501.15383 back: 1, 2
- Yang, B., Venkitesh, B., Talupuru, D., Lin, H., Cairuz, D., Blunsom, P., & Locatelli, A. (2025). Rope to Nope and Back Again: A New Hybrid Attention Strategy. https://arxiv.org/abs/2501.18795
- Yang, G., & Hu, E. J. (2022). Feature Learning in Infinite-Width Neural Networks. https://arxiv.org/abs/2011.14522
- Yen, H., Gao, T., Hou, M., Ding, K., Fleischer, D., Izsak, P., Wasserblat, M., & Chen, D. (2025). HELMET: How to Evaluate Long-Context Language Models Effectively and Thoroughly. https://arxiv.org/abs/2410.02694 back: 1, 2
- Yu, Q., Zhang, Z., Zhu, R., Yuan, Y., Zuo, X., Yue, Y., Dai, W., Fan, T., Liu, G., Liu, L., Liu, X., Lin, H., Lin, Z., Ma, B., Sheng, G., Tong, Y., Zhang, C., Zhang, M., Zhang, W., … Wang, M. (2025). DAPO: An Open-Source LLM Reinforcement Learning System at Scale. https://arxiv.org/abs/2503.14476
- Yuan, J., Gao, H., Dai, D., Luo, J., Zhao, L., Zhang, Z., Xie, Z., Wei, Y. X., Wang, L., Xiao, Z., Wang, Y., Ruan, C., Zhang, M., Liang, W., & Zeng, W. (2025). Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention. https://arxiv.org/abs/2502.11089
- Yue, Y., Chen, Z., Lu, R., Zhao, A., Wang, Z., Yue, Y., Song, S., & Huang, G. (2025). Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? https://arxiv.org/abs/2504.13837
- Zhou, F., Wang, Z., Ranjan, N., Cheng, Z., Tang, L., He, G., Liu, Z., & Xing, E. P. (2025). MegaMath: Pushing the Limits of Open Math Corpora. https://arxiv.org/abs/2504.02807
- Zhou, J., Lu, T., Mishra, S., Brahma, S., Basu, S., Luan, Y., Zhou, D., & Hou, L. (2023). Instruction-Following Evaluation for Large Language Models. https://arxiv.org/abs/2311.07911
- Zhu, T., Liu, Q., Wang, H., Chen, S., Gu, X., Pang, T., & Kan, M.-Y. (2025). SkyLadder: Better and Faster Pretraining via Context Window Scheduling. https://arxiv.org/abs/2503.15450 back: 1, 2
- Zuo, J., Velikanov, M., Chahed, I., Belkada, Y., Rhayem, D. E., Kunsch, G., Hacid, H., Yous, H., Farhat, B., Khadraoui, I., Farooq, M., Campesan, G., Cojocaru, R., Djilali, Y., Hu, S., Chaabane, I., Khanna, P., Seddik, M. E. A., Huynh, N. D., … Frikha, S. (2025). Falcon-H1: A Family of Hybrid-Head Language Models Redefining Efficiency and Performance. https://arxiv.org/abs/2507.22448 back: 1, 2